vibecamp newsletter · 매일 발행
vibecamp ai model
적은 예제로 스스로 깨우치는 학습법 일간
다른 채널 보기
뉴스레터 구독
매일 아침, 놓친 AI 소식을 메일로 받아보세요
가입 없이 이메일만으로 구독됩니다. 언제든 메일 하단에서 해지할 수 있어요.
 ai model🙋 능동학습#41 · 2026. 10. 23.
어떤 두 개를 비교할지 고른다, 스완지대 등 베이지안 순위 추정
쌍대 비교 판정(comparative judgement)은 두 항목씩 비교해 순위를 매기는 평가로, 판정 횟수가 곧 비용입니다. 스완지대·러프버러대 등 영국 연구팀은 순위 불확실성을 재는 베이지안 Bradley-Terry 모델을 만들고, 다음에 비교할 쌍을 고르는 액티브러닝(active learning) 전략 3종을 제안했습니다. 저·중 노이즈에선 쌍별 엔트로피 선택이, 최고 노이즈에선 사후 분리도 전략이 가장 좋았고, 중간 노이즈에서 결과 30%를 무작위로 바꿔도 성능 영향이 작았습니다.
 ai model♾️ 지속학습#41 · 2026. 10. 23.
새 지식을 아는 절차로 바꿔 배운다, UNC·시스코 SST
언어 모델을 새 도메인에 차례로 사후학습(post-training)하면 기존 능력이 무너지는 파국적 망각(catastrophic forgetting)이 생깁니다. UNC 채플힐·시스코 리서치 등 연구팀의 SST는 모델을 옛 상태로 끌어당기는 대신, 새 예제를 핵심 연산·의존관계·검증 단계만 남긴 '스킬 스키마'로 바꿔 아는 절차의 사례로 재작성합니다. 3B 백본 2종에서 평균 최종 성능이 2.53~5.75점 올랐고, Qwen-3B MATH 스트림 최대 망각은 42.41→7.10점으로 줄었습니다.
 ai model📚 커리큘럼 학습#41 · 2026. 10. 23.
고품질 데이터 투입 시점은 학습률이 정한다, 칭화대 공동 설계
LLM 사전학습(pre-training) 뒤 고품질 데이터로 넘어가는 미드트레이닝(mid-training)에서, 데이터를 언제 넣을지를 학습률(LR) 스케줄과 함께 분석한 연구입니다. 칭화대 연구팀은 LR이 전 구간 감쇠하면 미드트레이닝 데이터를 일찍 섞는 편이 낫지만, 상수 LR에서는 결론이 뒤집힌다는 점을 확인했습니다. dense·MoE 모델과 예산 10/25/47.75% 전반에서, 데이터 투입 후 LR을 높게 유지하다 마지막 20~40% 구간에서만 감쇠하는 쪽이 가장 좋았습니다.
 ai model📚 커리큘럼 학습#41 · 2026. 10. 23.
쉬운 것부터가 정답은 아니었다, 듀크대·Adobe PaceShift
커리큘럼 학습은 쉬운 샘플부터 가르치지만 분할(segmentation) 같은 밀집 예측(dense prediction)에서는 쉬운 샘플이 지름길(shortcut)을 노출하고 노이즈 샘플이 학습을 흐립니다. 듀크대·Adobe 연구팀은 같은 예산에서 쉬움→어려움 정렬이 무작위 순서와 다르지 않음을 확인하고 PaceShift를 내놓았습니다. 1단계는 난이도 대신 라벨 신뢰도로 샘플을 고르고, 2단계는 가드된 안티-커리큘럼으로 어려운 뷰에 도전, 평균 3.3~5.3% 상대 향상, 추론 비용은 그대로입니다.
 ai model🎯 소량학습#41 · 2026. 10. 23.
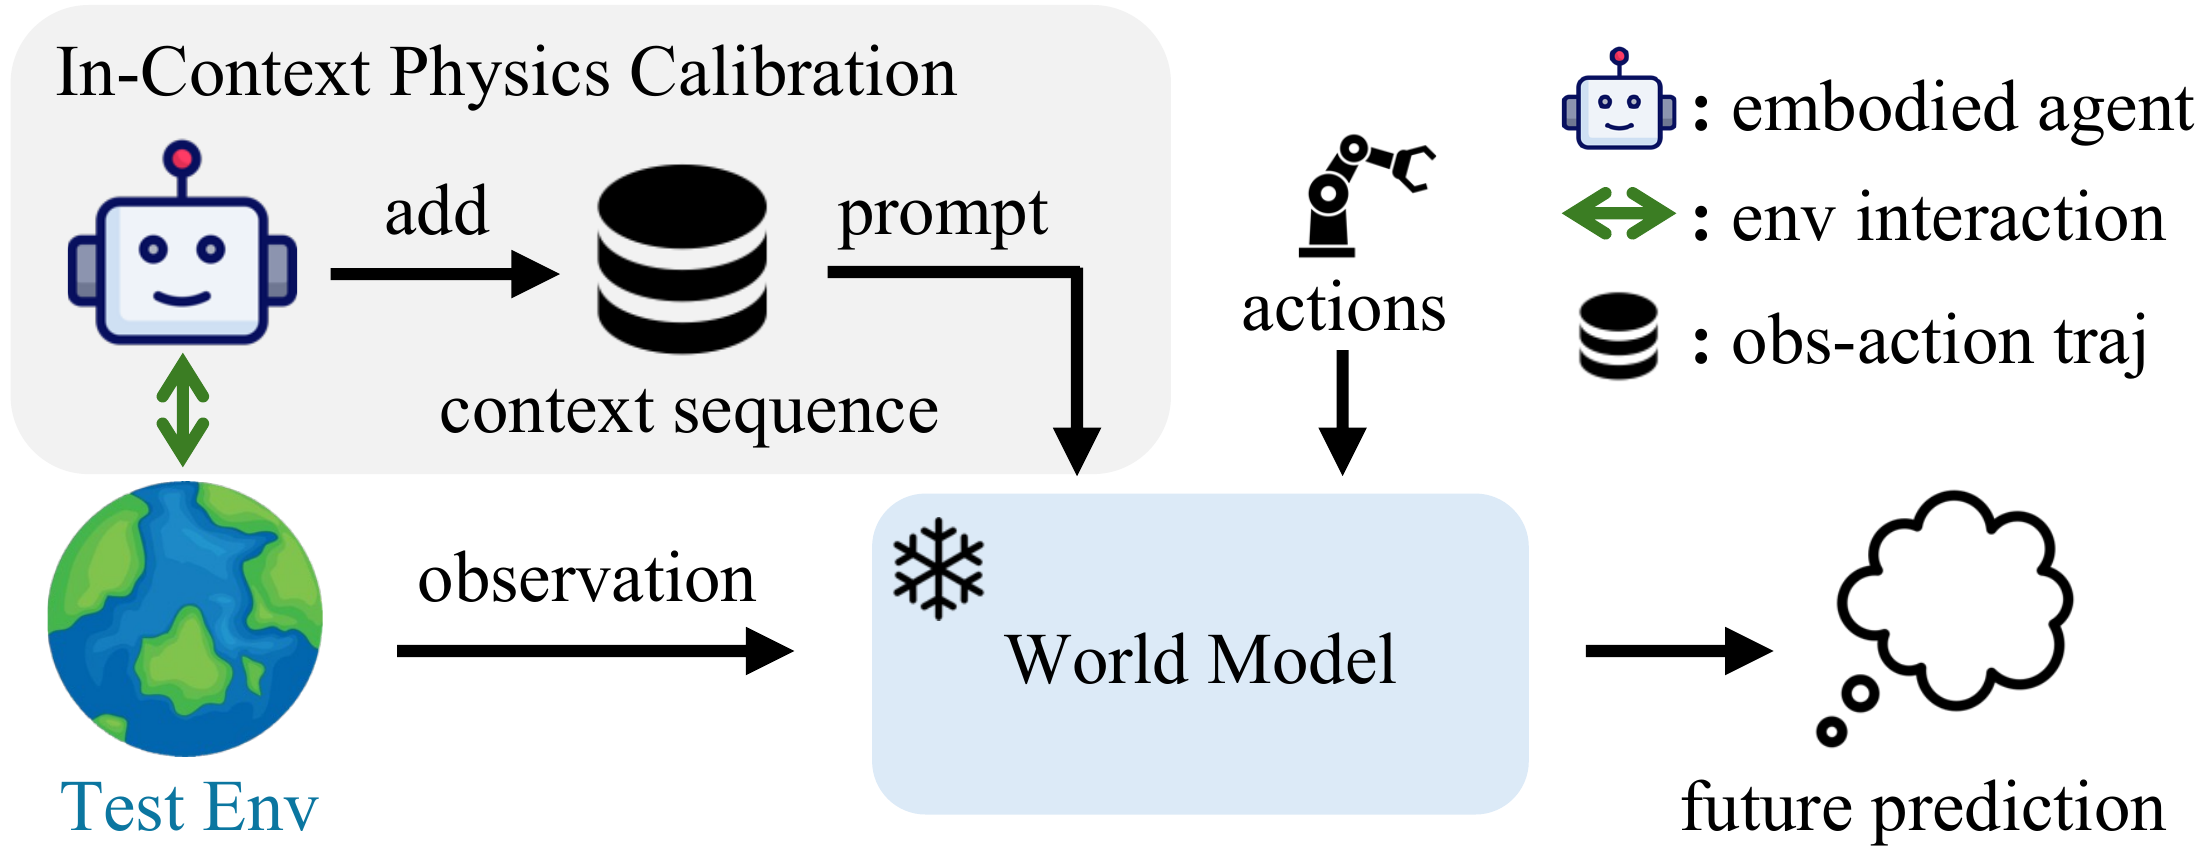
몇 초 만져보고 물리를 맞춘다, 미시간대 PhysiCalWorld
월드 모델(world model)은 현재 화면만 봐서는 무게·마찰·감쇠 같은 숨은 물리값을 알 수 없어, 낯선 장면에서 예측이 평균값으로 쏠리며 틀어집니다. 미시간대 연구팀의 PhysiCalWorld는 새 장면에서 짧게 상호작용해 본 클립을 물리 설명 토큰 하나로 압축해 프롬프트로 넣습니다. 토큰은 한 번만 뽑아 모든 롤아웃에 재사용하며, 파인튜닝이나 물리 라벨 없이 4개 환경에서 롤아웃 정확도와 시각 계획 성공률을 높였습니다.
 ai model🧬 메타학습#41 · 2026. 10. 23.
RL 없이 탐색하는 법을 배운다, 워싱턴대 ASTEROID
전문가는 정답을 알아 탐색할 필요가 없으니 모방학습으로는 탐색을 배우기 어렵고, RL로 배우면 표본 효율이 낮습니다. 워싱턴대 연구팀의 ASTEROID는 학생 정책이 먼저 직접 이력을 모으면, 정답을 보는 교사가 '학생이 지금까지 본 것 기준으로 할 일'을 라벨링해 지도학습으로 증류합니다. 11개 환경에서 고정 탐색 예산 리턴 약 2배, RL 대비 상호작용 약 100배 절감을 보였고, 카메라 없는 실로봇 조작에서 표준 증류 대비 성공률 +40%를 기록했습니다.
 ai model🔁 자가교정#41 · 2026. 10. 23.
자기 예측을 복기하며 계속 강해진다, 인민대 DeepEvolve
대부분의 AI는 출시 후 파라미터가 고정됩니다. 중국 인민대·IQuest Research·NTU 연구팀의 DeepEvolve는 미래 사건 예측을 무대로, 결과가 확정되면 예측 뒤의 추론 궤적을 파라미터 학습과 재사용 스킬로 내재화하는 재귀적 자기개선(RSI) 시스템입니다. 라이브 환경이 검증 가능한 예측 과제를 계속 합성하고, 오염을 막으려 검색과 예측을 분리했습니다. 외부 FutureX 주간 리더보드에서 3주 연속 전체 1위, 레이팅 최대 195% 향상을 기록했습니다.
 ai model🔁 자가교정#41 · 2026. 10. 23.
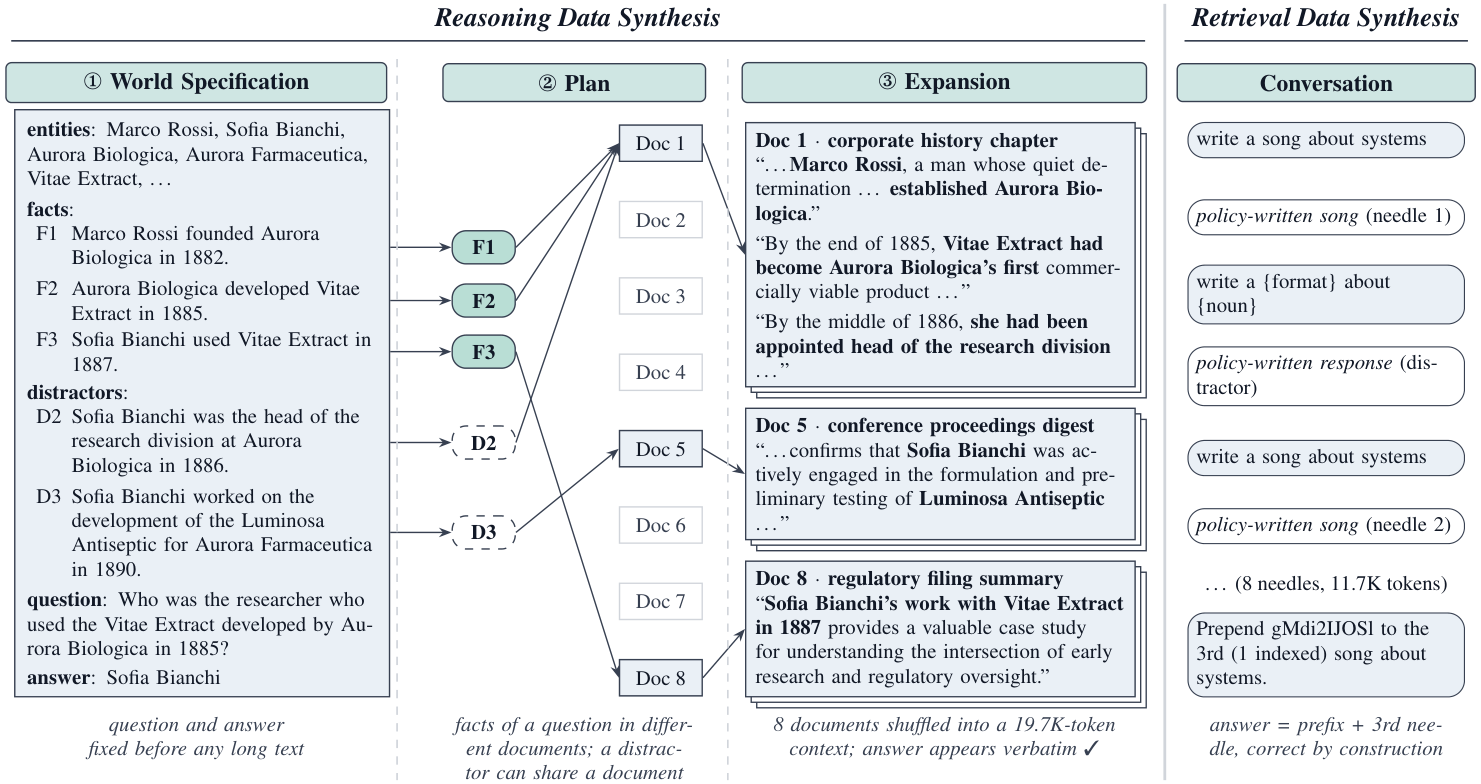
외부 데이터 없이 장문 추론을 키운다, 칭화대 LongZero
장문 맥락(long-context) 추론 강화학습에는 길고 검증 가능한 데이터가 필요한데, 기존 합성법은 외부 코퍼스나 더 강한 교사 모델에 기댑니다. 칭화대 연구팀의 LongZero는 모델이 먼저 질문·답·근거를 짧게 만든 뒤 근거를 긴 다중 문서로 확장해 스스로 문제를 출제합니다. 일관되게 못 맞히는 문제만 남겨 GRPO로 학습하자 Qwen3-4B-Thinking·Qwen3-8B가 5개 벤치마크 평균 최고점을 냈고, 397B 교사가 쓴 문제로 한 RL보다도 앞섰습니다.
 ai model🙋 능동학습#40 · 2026. 10. 22.
데이터가 빈 곳만 골라 묻는 강화학습, UNC·CMU 질의 배분
오프라인 강화학습(offline RL)은 가진 데이터 범위에 묶이고, 온라인 탐색은 비싸거나 위험합니다. UNC 채플힐·존스홉킨스대·CMU 연구팀은 고정 데이터에서 출발해 어떤 상태·시점을 협력자와 시뮬레이터에 물을지 학습자가 직접 고르는 질의 기반 협력 RL을 제안했습니다. 최적 정책 식별에 필요한 질의 수의 하한을 유도해 그대로 배분하며, 약 1만 회 질의로 멈췄습니다. 균등·커버리지 배분은 5~22배 많은 질의가 필요했습니다.
 ai model♾️ 지속학습#40 · 2026. 10. 22.
SGD 대신 지속학습 전용 옵티마이저를, 휴스턴대 SPIN
데이터 스트림을 한 번만 보고 배우는 온라인 지속학습(OCL)은 망각에 약한데도, 옵티마이저는 SGD·AdamW 같은 범용 기법을 그대로 써 왔습니다. 휴스턴대 연구팀의 SPIN은 새 데이터를 빠르게 흡수하는 가소성(plasticity) 시퀀스와 닻 역할의 안정성(stability) 시퀀스를 보간해 업데이트합니다. 기존 방법의 옵티마이저만 바꾸면 되고, 11개 SOTA OCL 방법 전반에서 성능이 올랐습니다. ER 기준 Split CIFAR-100 정확도는 27.94→33.31%였습니다.
 ai model♾️ 지속학습#40 · 2026. 10. 22.
새 개념을 배워도 옛 개념은 그대로, ETH 취리히 DyRA
텍스트-이미지 개인화는 참조 이미지 몇 장으로 고유 개념을 확산 모델에 가르치지만, 개념을 따로 배우거나 한꺼번에 주어진다고 가정합니다. ETH 취리히 Thomas Hofmann 그룹의 DyRA는 개념이 하나씩 도착하는 상황을 겨냥해 이전 개념과 간섭하지 않는 잔차 공간(residual space)에서만 업데이트합니다. 경쟁 방법 중 최고 개념 충실도에 망각은 거의 0이었고, 핵심 레이어만 적응시켜 학습 파라미터를 최대 72% 줄였습니다. 다만 SD v1.5·Concept101에서만 검증됐습니다.
 ai model🎯 소량학습#40 · 2026. 10. 22.
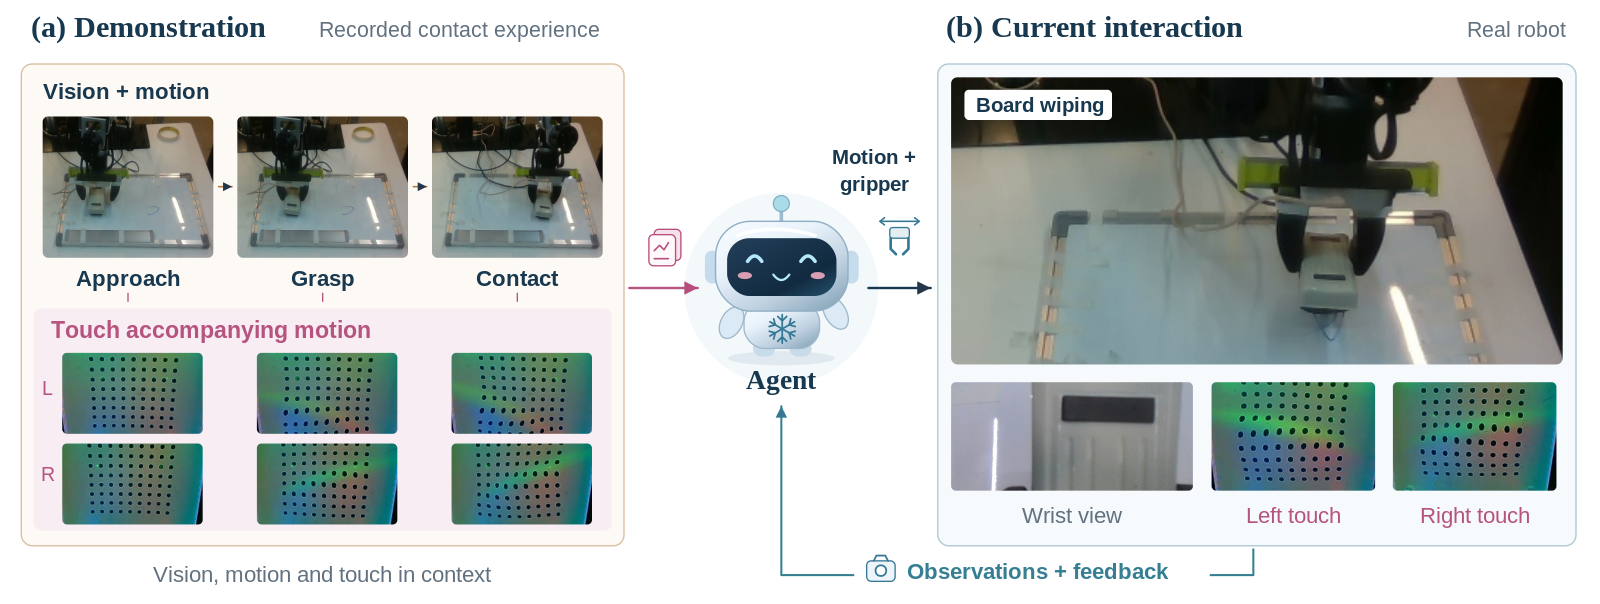
시연 2개와 촉각만으로 정밀 조작, 푸단대 Tactile-ETA
정밀한 로봇 조작에는 접촉 정보가 필요하지만, 과제마다 모델을 따로 학습하려면 데이터와 비용이 많이 듭니다. 푸단대·상하이혁신연구원·텐센트 등 연구팀의 Tactile-ETA는 전문가 시연의 동작마다 카메라 영상과 양측 촉각 관측을 짝지어 문맥에 넣고, 촉각 프레임은 시작·끝과 변화가 큰 지점만 남깁니다. 시연 2개만으로 파라미터 업데이트 없이 시뮬레이션 평균 성공률은 15.75→24.00%, 실로봇 과제는 0→60%로 올랐습니다.
 ai model🎯 소량학습#40 · 2026. 10. 22.
이진 분류로만 사전학습해도 다중 분류가 된다, 바이룽 AI
표 형식 파운데이션 모델(TFM)은 합성 데이터로 사전학습해 한 번의 순전파로 제로샷 예측을 합니다. 베이징 바이룽(Bairong) AI 연구팀은 TabICLv2의 사전학습 클래스 수 상한을 10→2로 줄여 모든 과제를 이진 분류로 만들어도 K개 클래스 분류가 된다는 점을 보였습니다. TabArena 분류 38개 데이터셋에서 1590.1 Elo로 공식 기본값(1568.0)과 TabPFN-v2.6(1577.1)을 앞섰고, 실제 신용평가 기관 60곳 중 44곳에서 AUC가 올랐습니다.
- 📄ai model♾️ 지속학습#39 · 2026. 10. 21.
RL로 똑똑해질수록 잊는 풀이법, 코넬대 적응형 재생 TAR
검증 가능한 보상 강화학습(RLVR)은 추론 정확도를 올리지만, 베이스 모델이 원래 알던 '다른 정답 풀이'를 점점 잊게 만듭니다. 코넬대 연구팀은 시뮬레이션 900회 중 92.4%가 1,000스텝 안에 소수 풀이가 억눌린 상태에 빠지고, 그중 2.6%만 회복된다는 점을 보였습니다. TAR은 다양한 정답 풀이를 작은 메모리 뱅크에 담아 두고 억제가 감지될 때만 골라 재생(replay)합니다. Qwen2.5 수학 벤치 6종에서 GRPO가 크게 잊은 베이스 풀이의 망각을 0~4%로 막았습니다.
 ai model📚 커리큘럼 학습#39 · 2026. 10. 21.
결과가 섞일 문제만 골라 비용을 아낀다, 미시간대 RIDGE
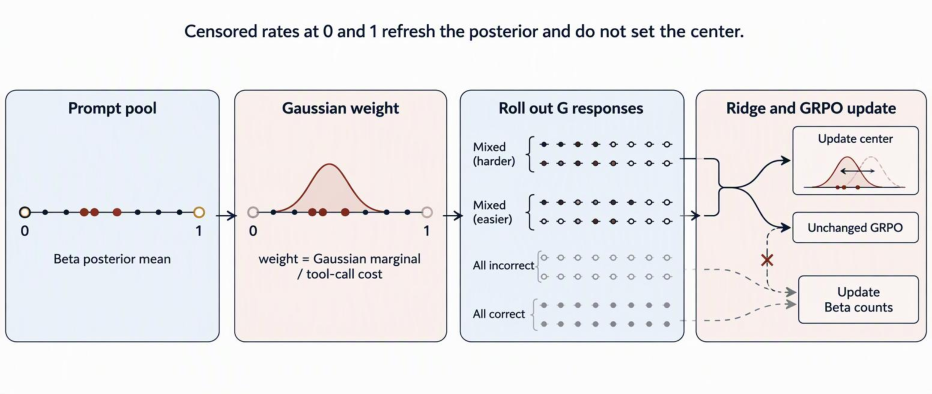
GRPO는 한 문제의 응답 그룹이 전부 맞거나 전부 틀리면 학습 신호가 0인데, 웹 검색 에이전트는 그때 이미 검색 비용을 다 써버립니다. 미시간대·에든버러대 연구팀의 RIDGE는 문제마다 통과율을 Beta 사후분포로 추적하고, 결과가 섞인 그룹만으로 '맞힐 듯 말 듯한' 난이도 구간을 갱신하며, 예측 툴콜 비용이 큰 문제는 덜 뽑습니다. GRPO 대비 평균 정확도를 3.4pt·2.9pt 올리고, dynamic sampling 대비 롤아웃 29.6%·툴콜 32.7%를 줄였습니다.
 ai model🧬 메타학습#39 · 2026. 10. 21.
예시 흉내 대신 규칙부터 세운다, 칭화대 등 CoDI 메타 귀납
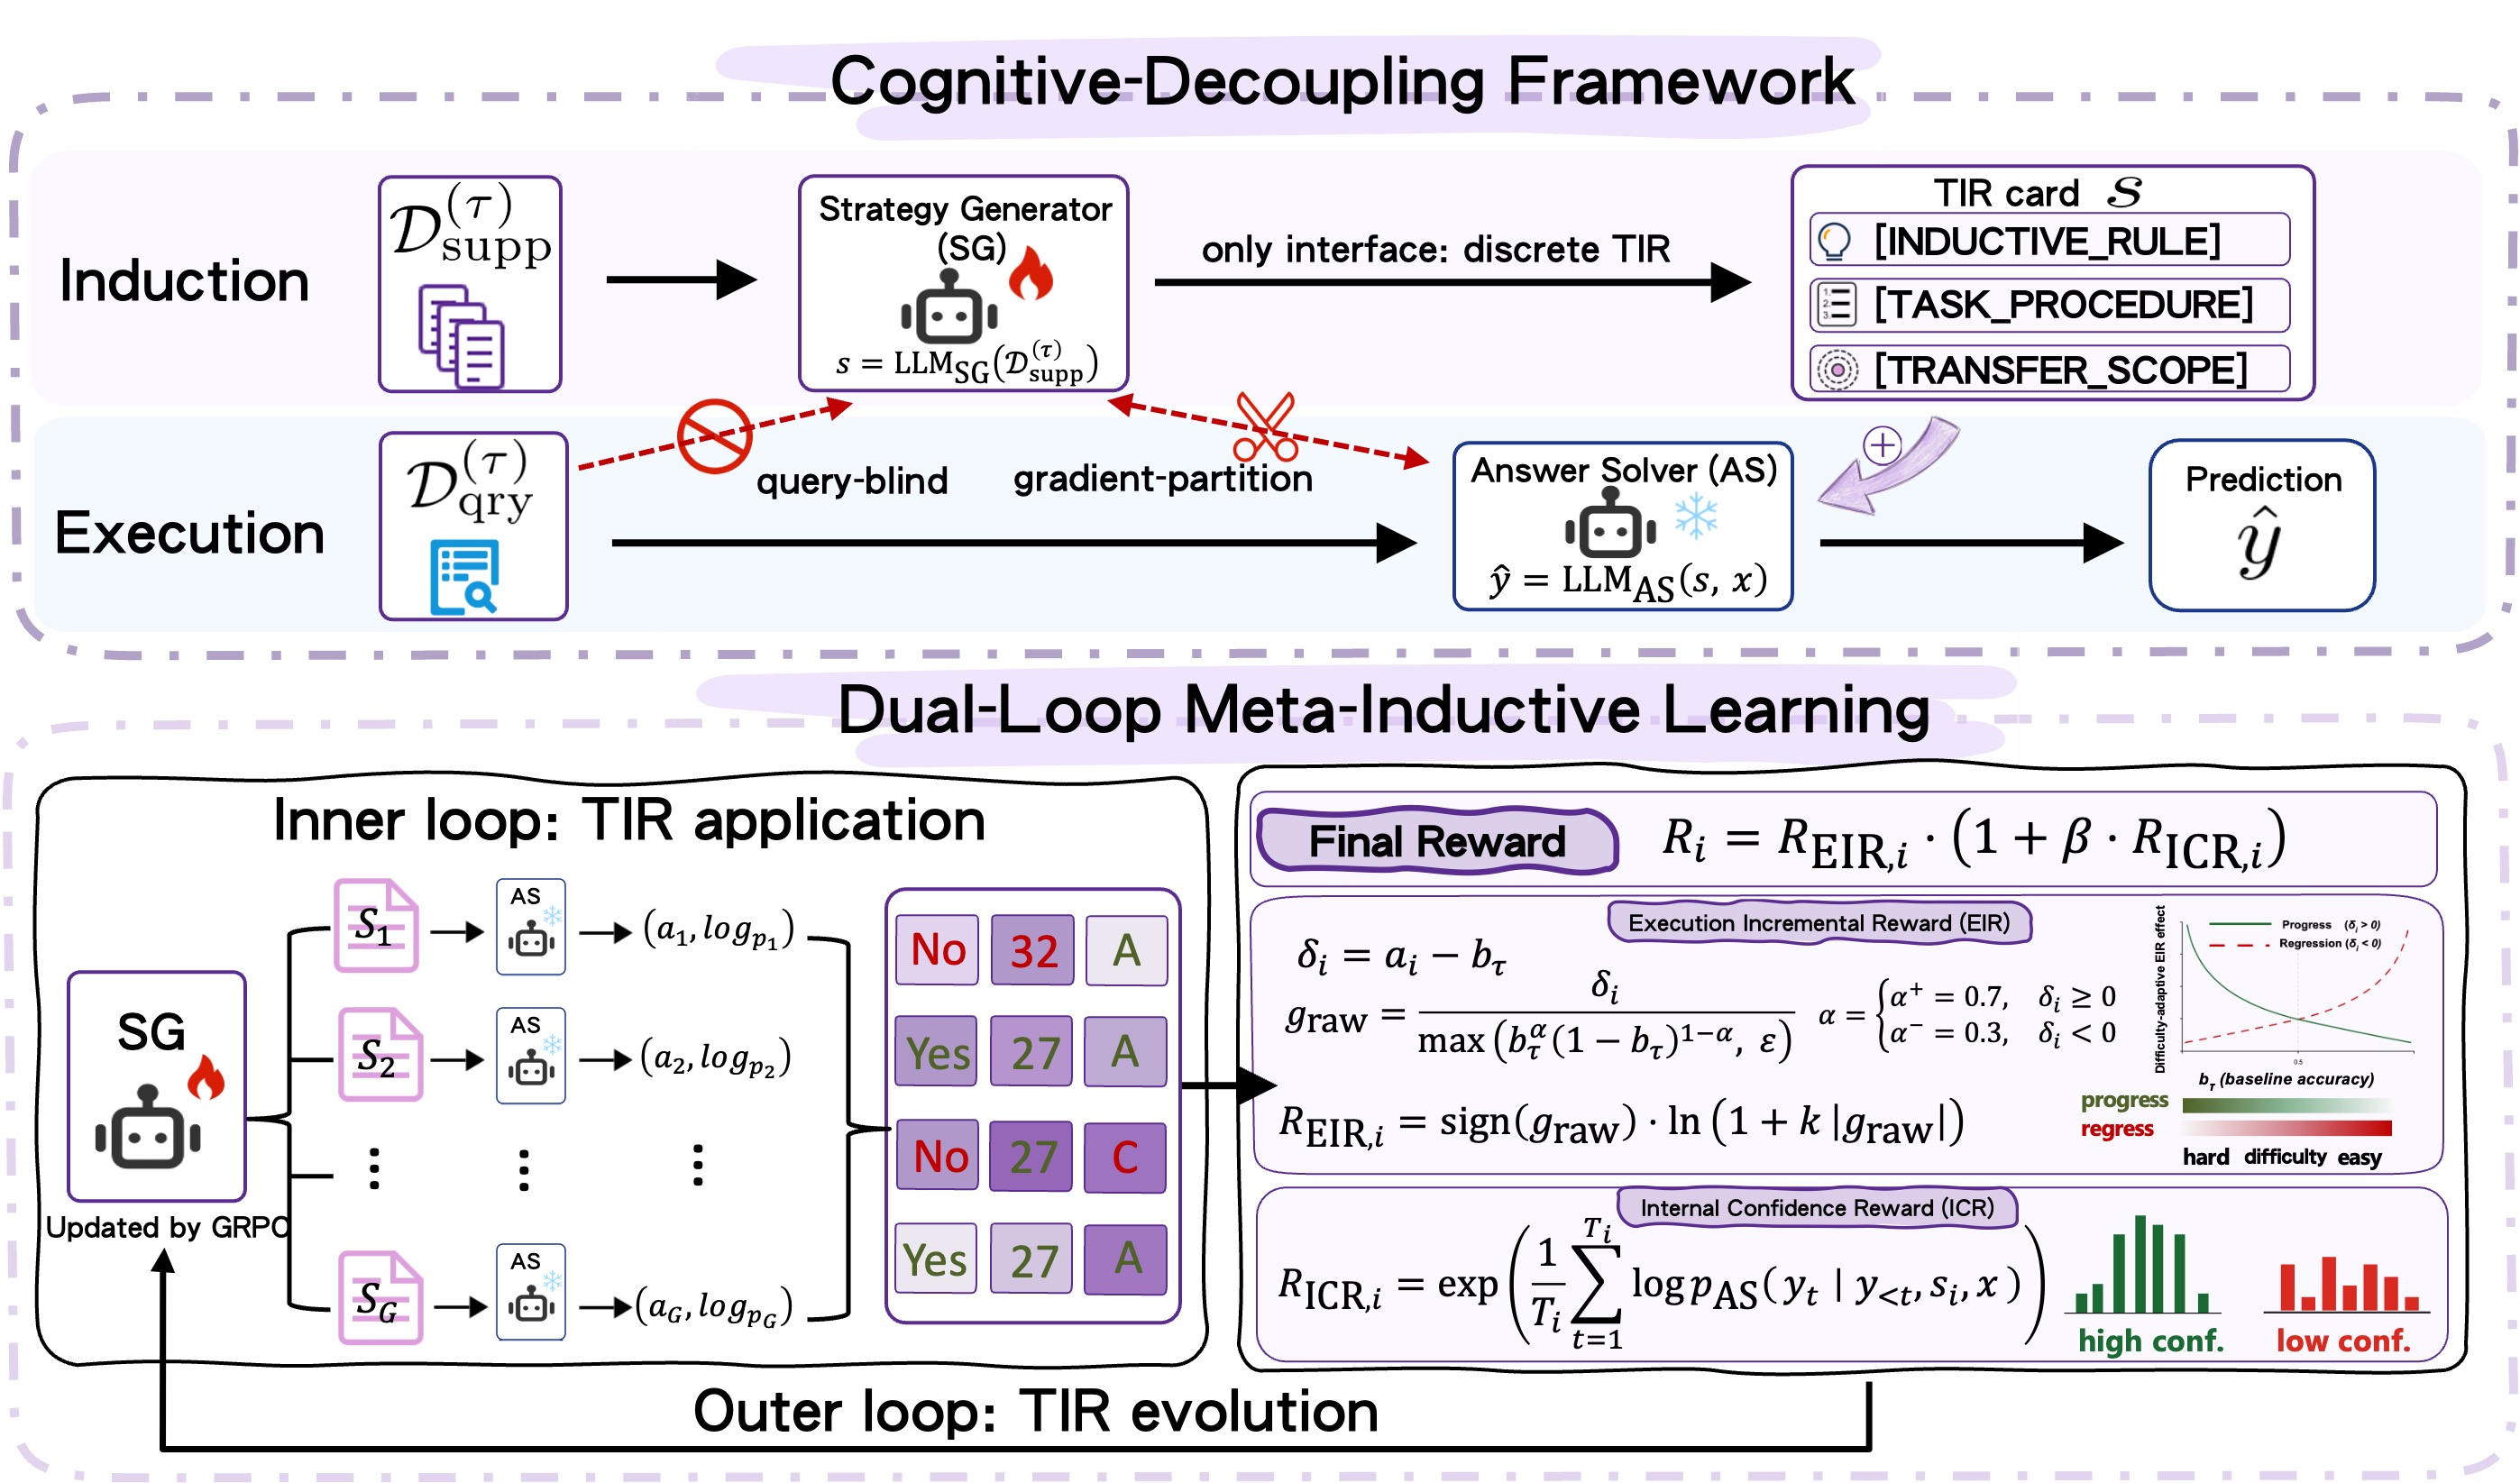
문맥 내 학습(ICL)은 질의와 비슷한 예시를 흉내 내는 데 기대 분포 밖(OOD) 문제에 약합니다. 칭화대 쑨마오쑹 교수팀과 베이징이공대 등 공동연구팀의 CoDI는 질의를 보지 않는 귀납기(inducer)가 예시에서 태스크 규칙을 먼저 뽑고, 실행기(executor)가 그 규칙을 적용합니다. 귀납기는 정답 규칙 라벨 없이 GRPO 기반 메타 강화학습 이중 루프로 훈련합니다. Qwen3-4B 기준 BIG-Bench에서 ICL 대비 분포 안 +120%, 분포 밖 +18%를 기록했습니다.
- 📄ai model🧬 메타학습#39 · 2026. 10. 21.
기억은 1%만, 적응은 8배 길게, 호주국립대 요약 메모리 RSM
재학습 없이 경험만으로 새 태스크에 적응하는 문맥 내 강화학습(in-context RL)은 오래 돌수록 메모리가 불어나거나, 창을 자르면 과거를 잃습니다. 호주국립대(ANU) 연구팀의 RSM은 최근 상호작용을 담은 짧은 버퍼에는 정밀하게 어텐션하고, 그 이전 경험은 고정 크기 요약으로 들고 다니다 버퍼가 차면 요약을 다시 씁니다. 동결된 정책이 학습 길이의 8배까지 적응 성능을 유지했고, 메모리는 전체 히스토리의 약 1%, 결정당 비용은 일정했습니다.
 ai model🔁 자가교정#39 · 2026. 10. 21.
맞은 답은 지키고 틀린 답은 더 세게, 고려대·중앙대 APSD
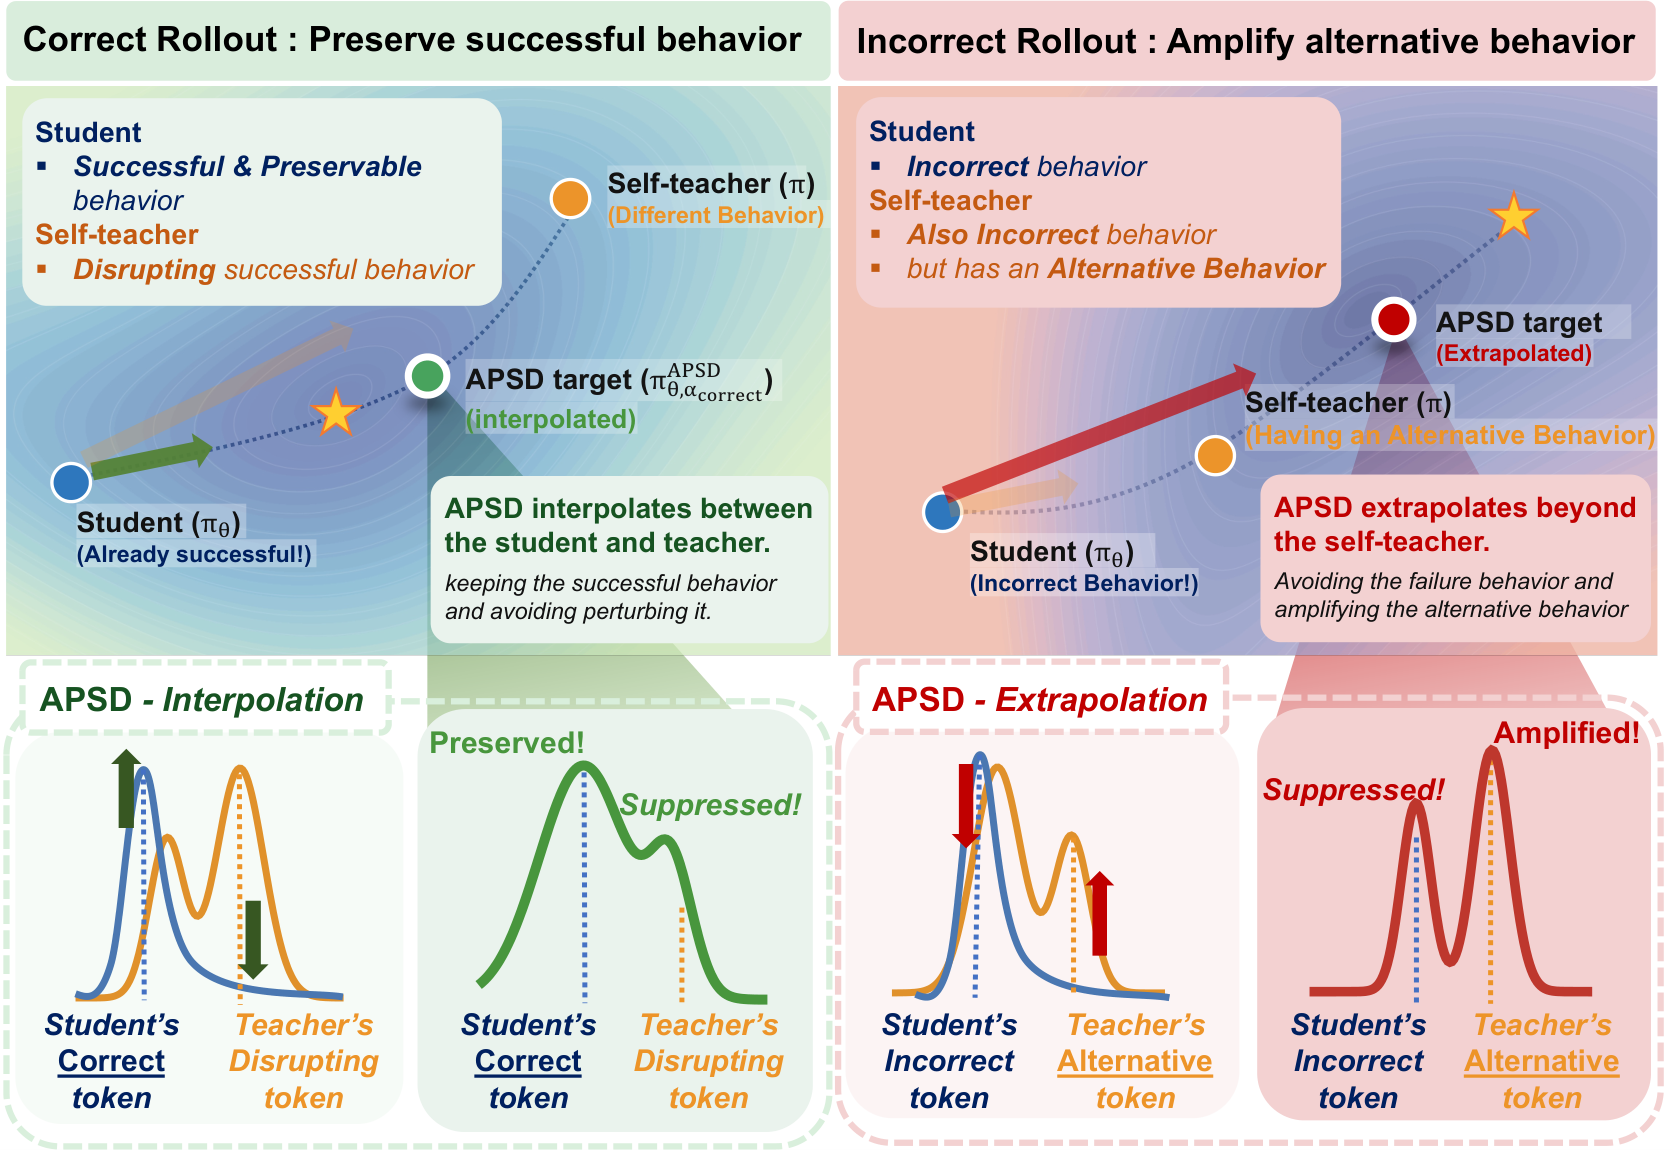
피드백을 본 모델 자신을 교사로 삼는 자기증류(self-distillation)는 그대로 따라 하면 맞은 풀이의 좋은 습관은 흐트러지고 틀린 풀이는 덜 고쳐집니다. 고려대·중앙대 연구팀(윤수완·정성룡·이창희)의 APSD는 정답 여부에 따라 목표 분포를 비대칭으로 만듭니다. 맞은 롤아웃은 학생과 자기교사 분포 사이로 보간해 보존하고, 틀린 롤아웃은 자기교사 너머로 외삽해 교정을 키웁니다. Qwen3 여러 규모에서 SDPO 성능을 평균 2.6배 적은 학습 스텝으로 달성했습니다.
- 📄ai model♾️ 지속학습#38 · 2026. 10. 20.
고칠수록 잊는다, Mila 연구팀의 자기진화 에이전트 지속학습 점검
가중치는 그대로 두고 프롬프트·메모리·스킬만 스스로 고쳐 쓰는 자기진화 에이전트(self-evolving agent)가 새 일을 배우면서 예전 일을 잊지 않는지 따져봤습니다. Mila 소속 Xiaoyin Chen 등 7인은 ReasoningBank·GEPA·Meta-Harness를 4개 변화형 태스크 스트림에 돌렸습니다. 전체 성능은 대체로 올랐지만, 공유 프롬프트를 통째로 고치는 방식은 이전 지식을 덮어썼고 유사도 기반 메모리 검색은 엉뚱한 기억을 끌어왔습니다.
 ai model♾️ 지속학습#38 · 2026. 10. 20.
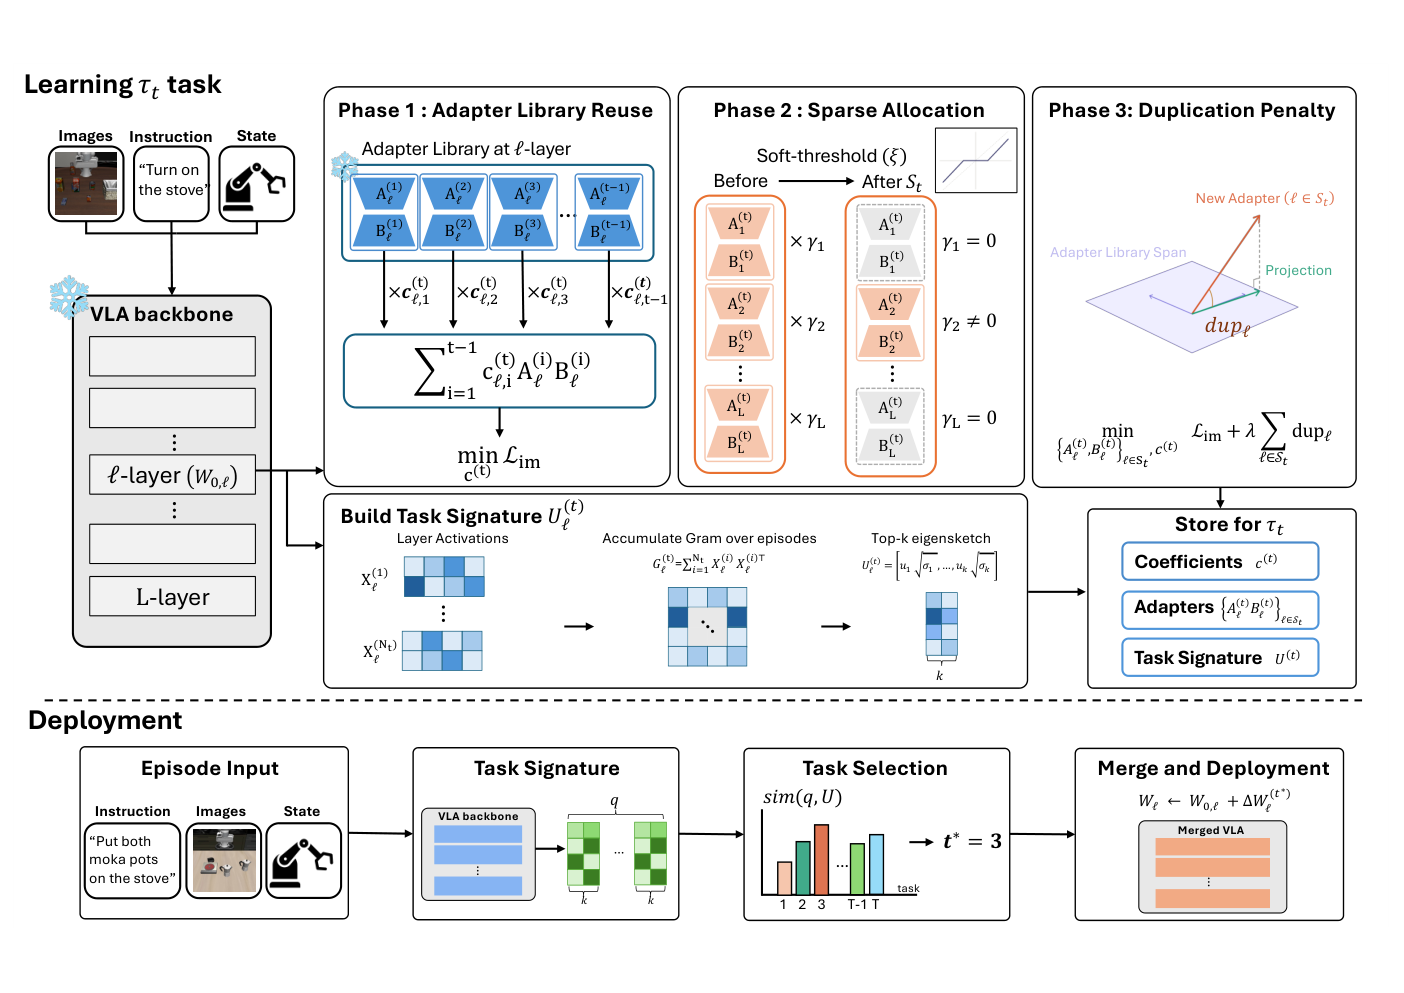
어댑터는 재사용하고 저장량은 4.5배 줄인, 서울대·아주대 SARAM
로봇이 새 작업을 배울 때마다 어댑터(adapter)를 추가하면 망각은 줄지만 온보드 저장공간이 계속 불어납니다. 서울대·아주대 공동연구팀(교신 장병탁)의 SARAM은 이전 태스크의 고정 어댑터를 재사용하고, 일부 레이어에만 희소하게 새 어댑터를 붙이며, 중복 페널티로 기존에 없는 정보만 담게 합니다. 배포 땐 태스크를 한 번 식별해 백본에 병합합니다. LIBERO 4개 스위트에서 기존 기법과 동등 이상이면서 태스크당 디스크 저장량을 최대 4.5배 줄였고, 실제 UR5 로봇팔에서도 검증했습니다.
 ai model📚 커리큘럼 학습#38 · 2026. 10. 20.
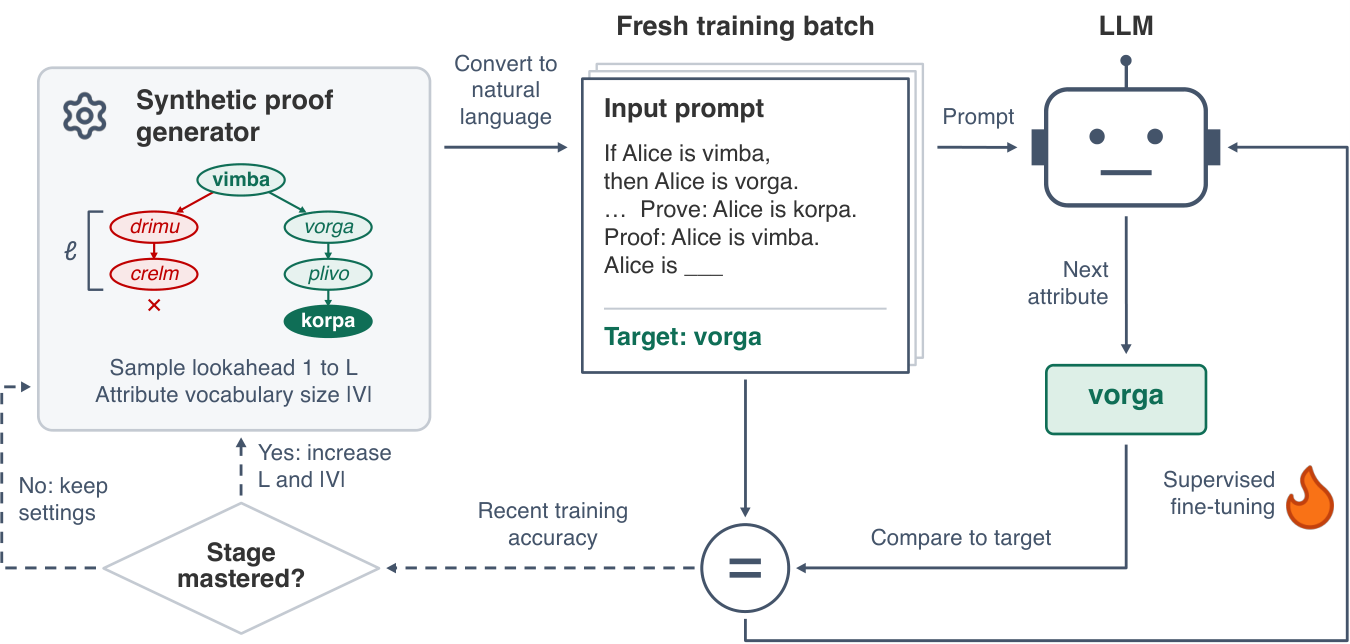
한 번에 256단계를 내다보다, 퍼듀대 커리큘럼 추론 학습
LLM은 생각의 사슬(CoT) 없이 한 번에 여러 단계를 내다보는 암묵적 추론(implicit reasoning)이 약합니다. 퍼듀대 연구팀은 어휘 크기와 내다봐야 할 단계 수(lookahead)를 조금씩 늘리는 커리큘럼으로 파인튜닝해, 같은 연산량에서 Qwen3-0.6B가 lookahead 256 문제를 98% 정확도로 풀게 했습니다(커리큘럼 없이 45%). 효과는 11개 자연어 추론 벤치마크로 전이됐지만 향상폭이 포화 곡선을 그려 모델마다 천장이 있고 단계를 너무 크게 올리면 학습이 멈췄습니다.
 ai model📚 커리큘럼 학습#38 · 2026. 10. 20.
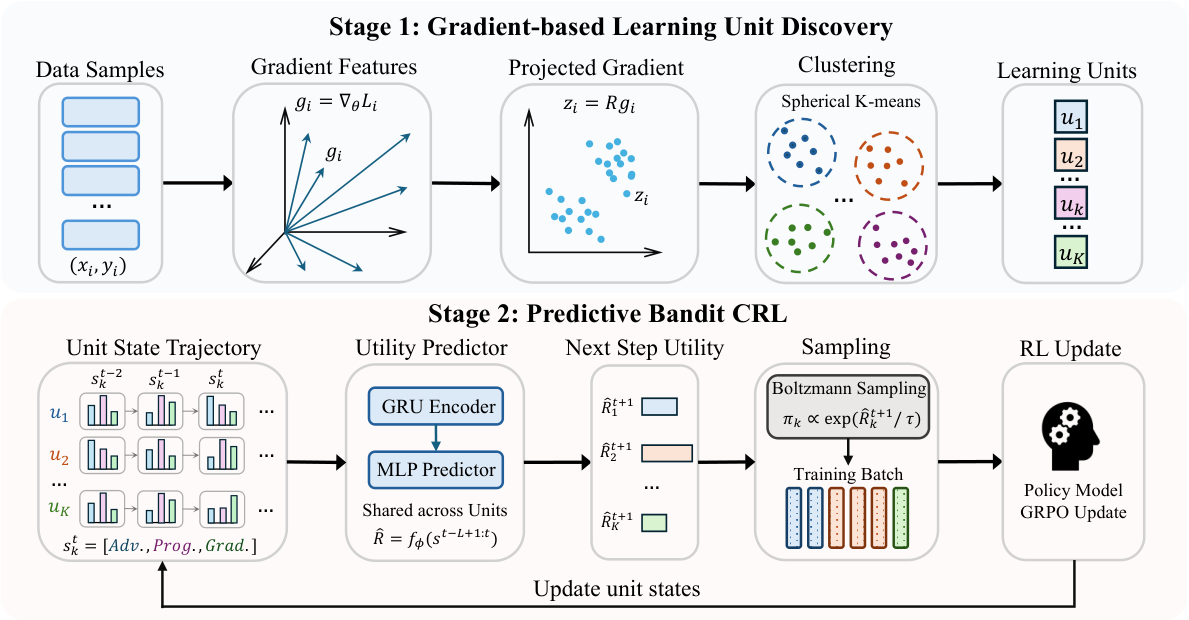
난이도 대신 그래디언트로 묶다, 중국과학원·메이퇀 RL 커리큘럼
강화학습(RL) 커리큘럼은 보통 난이도 같은 정해진 속성으로 문제를 묶고 최근 성적만 보고 출제 비중을 정합니다. 중국과학원 계산기술연구소·메이퇀 연구팀의 PGB 커리큘럼은 샘플별 그래디언트를 군집화해 '학습 효과가 비슷한' 단위를 찾고, 경량 예측기로 각 단위의 미래 효용을 내다본 뒤 볼츠만 분포로 데이터를 배분합니다. Qwen3 수학 추론 RL에서 표준 GRPO 대비 상대 향상 기준 도메인 안 8.8~14.3%, 도메인 밖 14.7~16.3%를 기록했습니다.
- 📄ai model🎯 소량학습#38 · 2026. 10. 20.
암호로 바꿔야 예시를 본다, IIT 봄베이 희귀어 용어 번역
프롬프트에 용어 예시를 넣어줘도 번역 모델이 그 예시를 따르지 않고 기존 지식에 기대는 경우가 많습니다. IIT 봄베이 연구팀의 RareCipherFT는 학습 때 같은 희귀 용어를 공유하는 예시를 붙이고, 그 용어를 문맥과 정답 양쪽에서 문자를 섞은 암호(cipher)로 바꿔 '예시에서 복사해야만' 맞히게 만듭니다. 영어와 타밀·아삼·네팔·하우사어 등 7개 방향, 1B~7B 모델 4종에서 용어 재현율이 5~15%포인트 올랐고 번역 품질(COMET)은 떨어지지 않았습니다.
 ai model🧬 메타학습#38 · 2026. 10. 20.
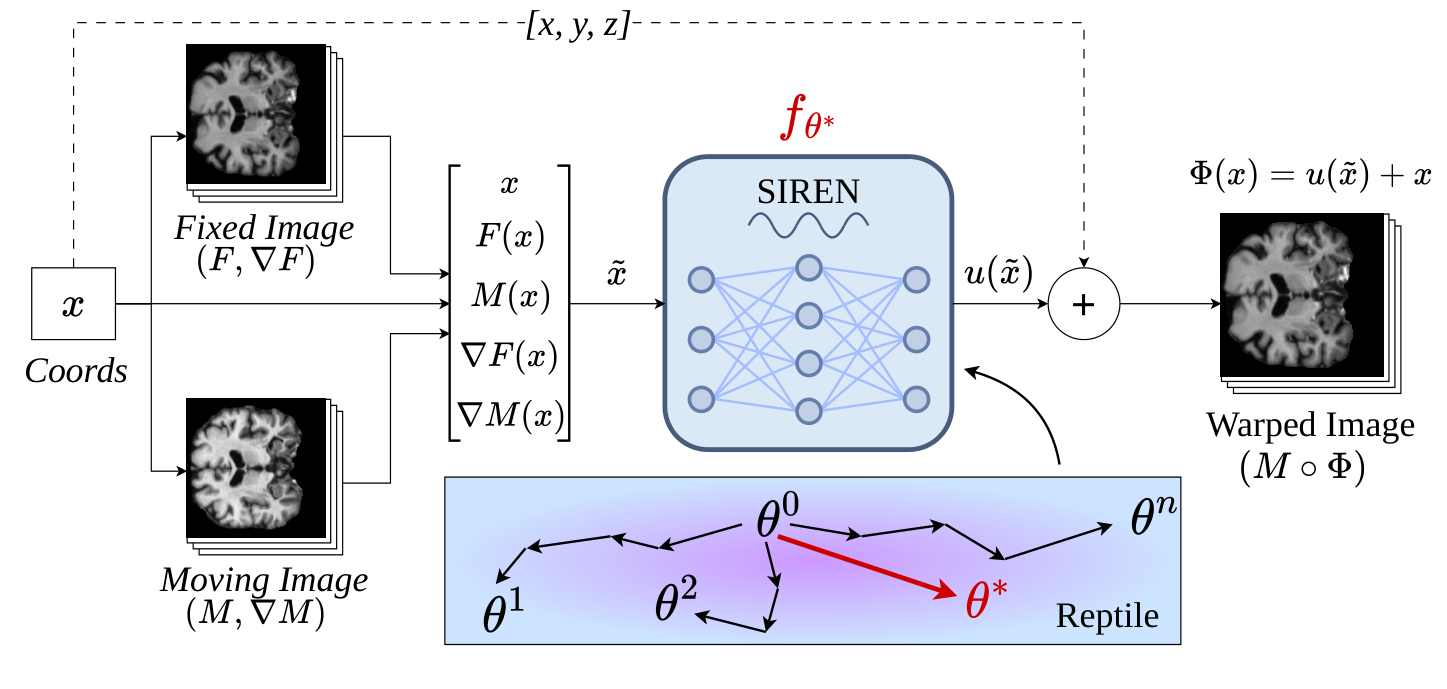
정합 속도 약 10배, 폴란드 AGH의 메타러닝 의료영상 정합
암묵적 신경 표현(INR) 기반 의료영상 정합(registration)은 영상 쌍마다 네트워크를 새로 최적화해야 해 느립니다. 폴란드 AGH 크라쿠프과기대·Sano 센터 연구팀의 LUMINR은 좌표에 국소 밝기·그래디언트 특징을 더해 입력하는 INR의 초기값을 메타러닝으로 학습해, 처음 보는 영상 쌍도 몇 번의 반복만으로 맞춥니다. OASIS 3D 뇌 MRI에서 처음부터 학습한 같은 모델과 동일한 정확도에 그래디언트 스텝과 실제 소요 시간을 각각 약 10분의 1로 줄였습니다.
 ai model🔁 자가교정#38 · 2026. 10. 20.
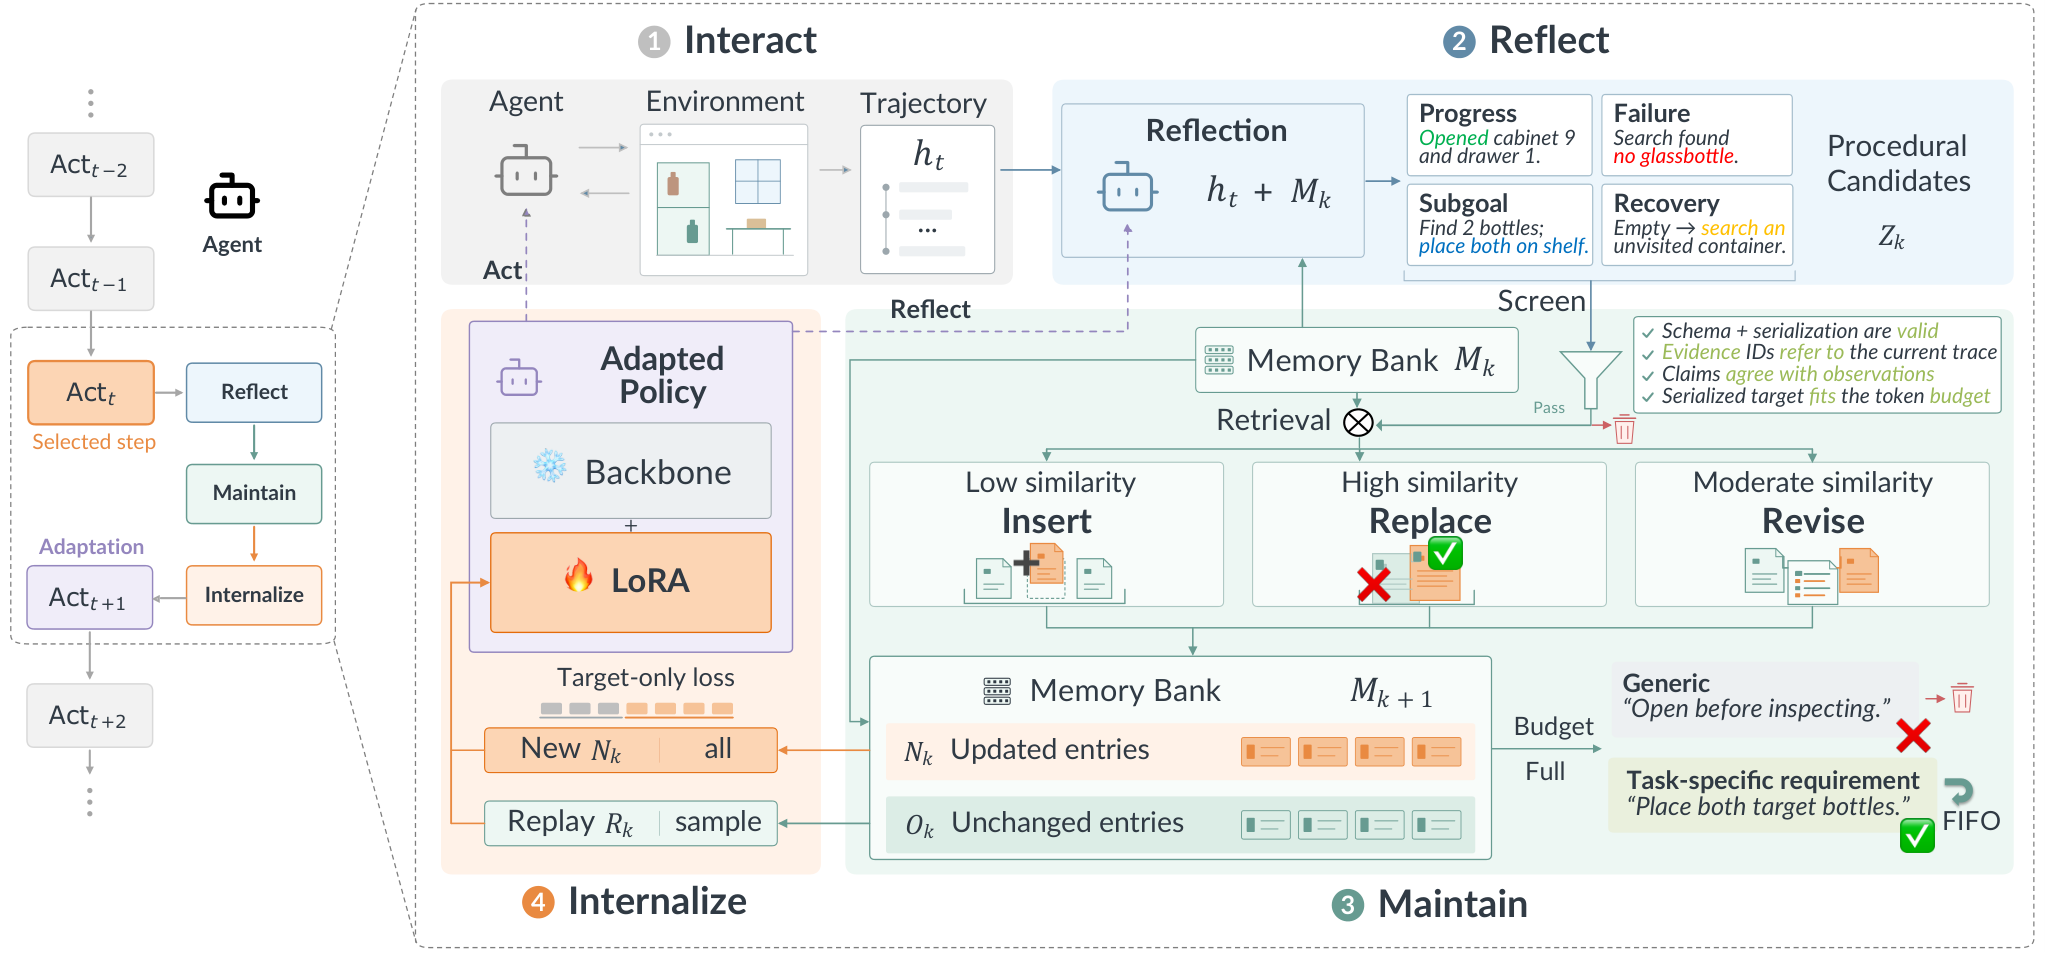
실패에서 뽑은 교훈으로 즉석 학습, 푸단대·상하이 AI Lab ReTTT
에이전트가 겪은 실패를 바로 다음 결정에 살리기는 어렵습니다. 푸단대·상하이 AI 연구소·홍콩중문대 연구팀의 ReTTT는 환경 피드백을 반성(reflection)해 교훈을 메모리에 쌓고, 그 교훈으로 작업 중 LoRA 어댑터를 즉석 학습합니다(백본 고정). 적응된 모델이 다시 행동하고 반성하는 폐루프입니다. ALFWorld·ScienceWorld·SWE-bench Lite 6개 설정 모두에서 기존 궤적 기반 테스트 타임 학습을 앞섰고, 성공률은 최대 12.14%포인트 올랐습니다.
 ai model🔁 자가교정#38 · 2026. 10. 20.
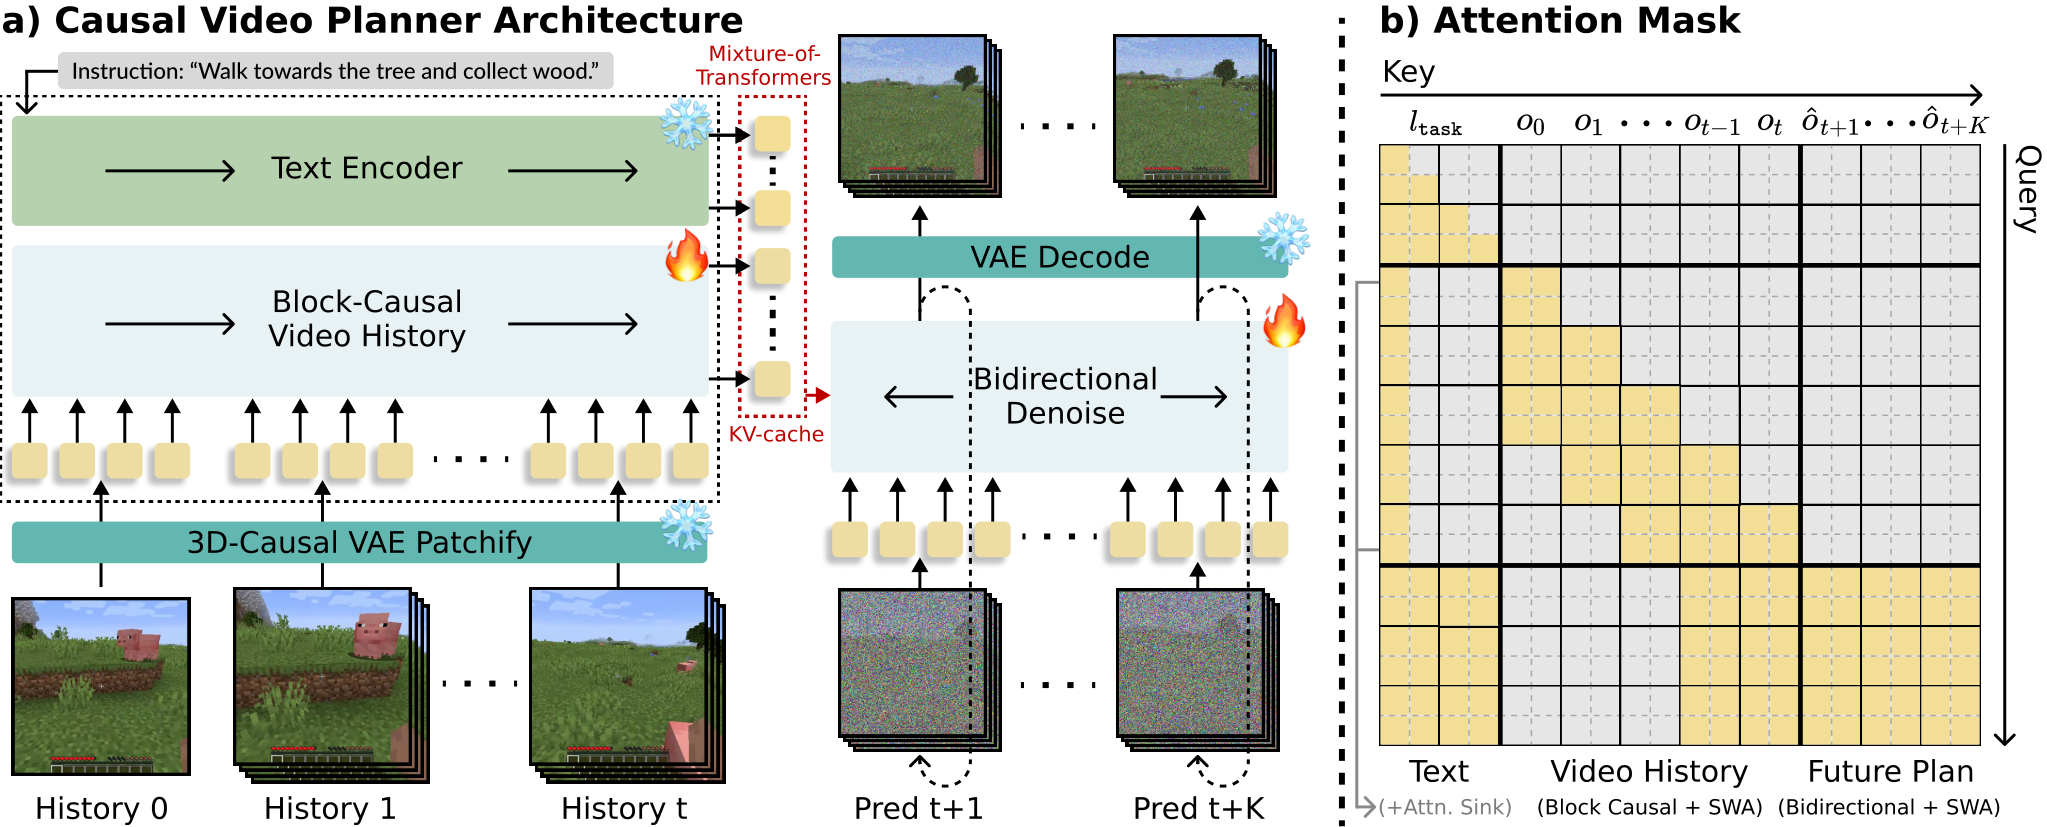
라벨 없이 해보며 배운다, MIT CSAIL 영상-행동 자기개선 Mirror
영상 생성 모델이 그린 시각적 계획을 실제 행동으로 옮기려면 보통 사람이 모은 대규모 영상-행동 데이터가 필요합니다. MIT CSAIL 연구팀의 Mirror는 사전 행동 데이터나 수작업 보상 없이, 계획 영상을 따라 최선의 추측 행동을 해보고 그 결과로 생긴 영상-행동 쌍으로 다시 학습하며 스스로 나아집니다. Atari·OGBench·DeepMind Control에서 기존 관찰 학습법을 앞섰고, 마인크래프트에서는 보상·전문가 라벨 없이 자기개선만으로 철 곡괭이를 얻은 첫 방법이 됐습니다.
- 📄ai model🙋 능동학습#37 · 2026. 10. 17.
질문 수는 줄이고 빠진 보상만 묻는다, MIT 표적형 선호 학습
사람이 로봇에게 시연을 보여줄 때는 모든 측면을 한 번에 신경 쓰기 어려워 빠지는 부분이 생깁니다. MIT 연구팀은 시연에서 전달되지 않은 특징(feature)에만 선호 질문을 집중시키는 정보 기반 사전분포(informed prior)와, 질문마다 무엇을 봐야 할지 알려주는 설명을 결합했습니다. 질문 수가 적은 구간에서 표준 액티브 선호 학습(active preference learning)보다 최대 30.8% 높은 성능을 냈고, 사용자 연구에서도 두 요소가 각각 효과를 보였습니다.
- 📄ai model♾️ 지속학습#37 · 2026. 10. 17.
기능별 서브네트워크만 골라 갱신해 망각을 막는 하얼빈공대 CiMEO
LLM에 새 지시문을 계속 학습시키면 기존 능력을 덮어쓰는 파국적 망각(catastrophic forgetting)이 생깁니다. 하얼빈공대(선전) 연구팀의 CiMEO는 그래디언트 귀속으로 코딩·수학 같은 기능별 서브네트워크를 찾고, 예제마다 해당 영역의 파라미터와 옵티마이저 상태만 갱신합니다. 140만 지시문 순차 학습 후 Qwen3-1.5B 기준 5개 벤치마크 평균 38.92로 전체 파인튜닝(24.23)·LoRA(27.84)를 앞섰고, GSM8K는 67.55를 유지했습니다.
- 📄ai model♾️ 지속학습#37 · 2026. 10. 17.
어텐션 헤드를 태스크별로 나눠 RL 망각을 줄이는 워싱턴대 연구
수학→지시이행→코딩처럼 RL 파인튜닝을 연달아 하면 새 업데이트가 이전 능력을 덮어쓰곤 합니다. 워싱턴대 등 공동연구팀은 헤드별 그래디언트 노름(gradient norm)으로 어텐션 헤드 순위를 매기고, 태스크마다 다른 헤드 집합을 배정하는 헤드 분할(head partitioning)을 제안했습니다. Qwen3-1.7B·4B, Mistral-7B에서 상위 50% 헤드만 학습해도 전체 튜닝에 근접했고, 이전 태스크 성능 하락은 줄이면서 새 태스크 적응력은 유지했습니다.
 ai model📚 커리큘럼 학습#37 · 2026. 10. 17.
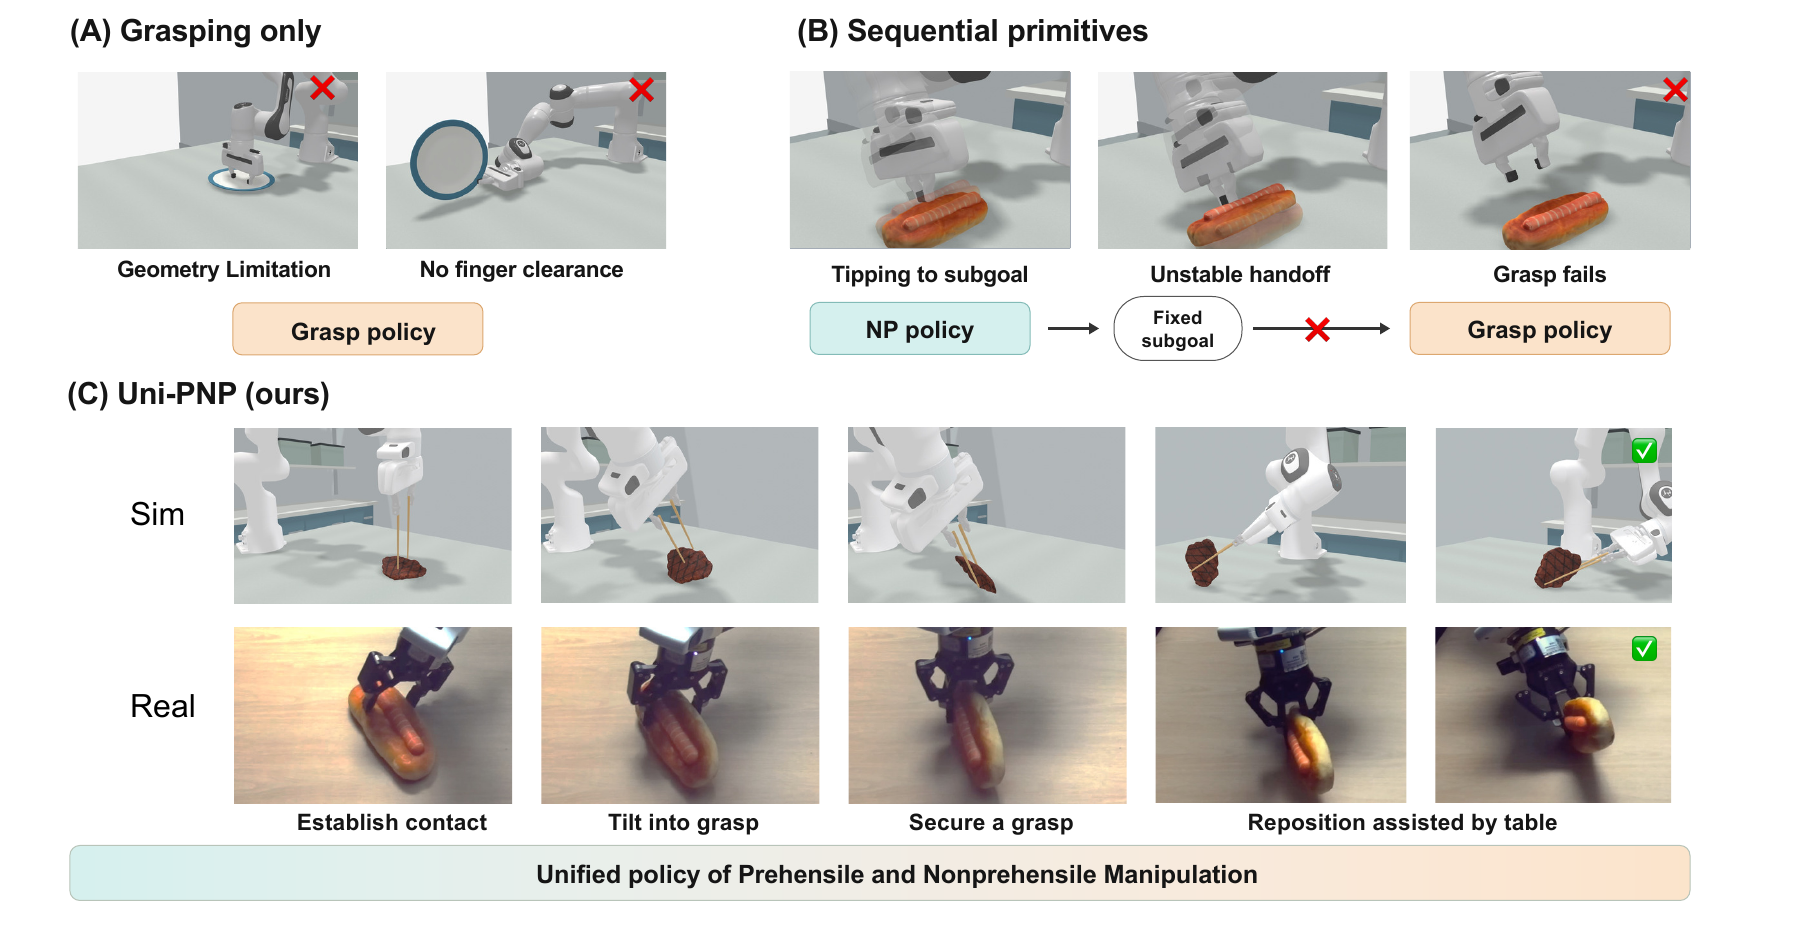
잡히는 물체부터 못 잡는 물체로, 북경대 2단계 RL 커리큘럼 조작
로봇의 잡기(prehensile)와 밀기·넘기기 등 비파지(non-prehensile) 동작은 보통 따로 만들어 이어붙여 협응이 부족했습니다. 북경대·Galbot 연구팀의 Uni-PNP는 접촉에 따른 물체 움직임을 예측하는 기하 인코더 위에서, 잡을 수 있는 물체→잡을 수 없는 물체 순서의 2단계 강화학습 커리큘럼(curriculum)으로 하나의 정책을 학습합니다. 학습 물체 성공률 76.39%, 처음 보는 물체 57.91%로 최강 기준선보다 각각 20.52%포인트, 17.79%포인트 높았습니다.
- 📄ai model🎯 소량학습#37 · 2026. 10. 17.
예시 하나로 여러 곳을 동시에 고친다, 확산 LM 다중 타깃 퓨샷
포맷 변경이나 API 마이그레이션처럼 예시 하나를 여러 곳에 적용하는 편집은 좌우 문맥이 모두 필요해, 왼쪽부터 생성하는 자기회귀 모델에는 어색합니다. UT 오스틴 연구팀은 확산 언어모델(diffusion LM)로 여러 마스킹 구간을 예시에 맞춰 동시에 채우는 다중 타깃 퓨샷 프롬프팅(few-shot prompting)을 제안했습니다. 예시를 따르는 채움에 가점을 주는 가이던스를 더해, 퓨샷 벤치마크와 리팩터링 사례에서 채움 정확도를 높였습니다.
- 📄ai model🧬 메타학습#37 · 2026. 10. 17.
병목을 진단해 개선 방법까지 고르는 메타 에이전트, 베이항대 RSIFlow
기존 자기개선(self-improvement)은 모델·하네스·산출물 중 하나만 정해진 방식으로 고쳐, 바뀌는 병목에 대응하지 못했습니다. 베이항대·칭화대·BAAI 연구팀의 RSIFlow에서는 메타 에이전트가 궤적과 피드백으로 병목을 진단하고, 어느 구성요소를 어떤 워크플로로 개선할지 고른 뒤 결과를 스킬과 원칙으로 증류해 자기 하네스를 진화시킵니다. 6개 벤치마크에서 평균 SOTA를 기록했고, HumanEval+ pass@1은 Qwen3-4B에서 14.02%포인트 올랐습니다.
- 📄ai model🔁 자가교정#37 · 2026. 10. 17.
정답 없이 자기 풀이끼리 비교해 배운다, 상하이교통대 SRD 자기증류
정답 라벨·검증기·교사 모델이 없으면 모델이 만든 풀이가 맞는지 알 수 없어 자기개선이 막힙니다. 상하이교통대 연구팀의 SRD(Shared Residual Distillation)는 같은 문제에 대한 미검증 풀이 여러 개가 예측 분포를 바꾸는 방향 중, 서로 일치하고 크기가 보수적인 조정만 학습 신호로 씁니다. AIME24~26 avg@12 기준 Qwen3-4B는 19.07→45.46, Qwen3-8B는 21.39→54.44로 올랐고, 일반 능력 벤치마크 저하는 없었습니다.
- 📄ai model🔁 자가교정#37 · 2026. 10. 17.
틀린 다수결로도 학습이 되는 이유, 그래디언트 분해로 밝힌 연구
모델이 뽑은 여러 답의 다수결을 보상으로 쓰는 자기라벨 강화학습은 정답 정보를 더하지 않는데도 정답 보상 RL(RLVR)의 효과 대부분을 회복합니다. 다트머스대·워싱턴대 세인트루이스 연구팀은 이를 배치 단위 그래디언트 분해로 설명했는데, 다수결 오류의 방향이 프롬프트마다 제각각이면 배치가 커질수록 오도가 사라집니다. 5개 모델에서 두 업데이트의 노이즈 보정 코사인은 약 1이었고, 정답 라벨 30%를 무작위로 뒤집어도 방향이 유지됐습니다.
- 📄ai model🙋 능동학습#36 · 2026. 10. 16.
이미지당 픽셀 1개 라벨로 세그멘테이션 학습, 워털루·애플 TEAL
세그멘테이션(segmentation) 데이터는 픽셀 단위 라벨링 비용이 큽니다. 워털루대·애플 연구팀의 TEAL은 고정된 ViT(DINOv3) 백본의 토큰 격자 위에서 다양성 기준으로 라벨링할 픽셀을 고르고, 불확실성(margin)으로 한 번 더 걸러내는 ViT 표현 기반 최초의 픽셀 단위 액티브러닝(active learning) 프레임워크입니다. 이미지당 1픽셀 라벨로 최강 기준선보다 최대 24.36 mIoU 높았고, 10픽셀만으로 완전지도학습 성능의 최대 97%에 도달했습니다.
 ai model♾️ 지속학습#36 · 2026. 10. 16.
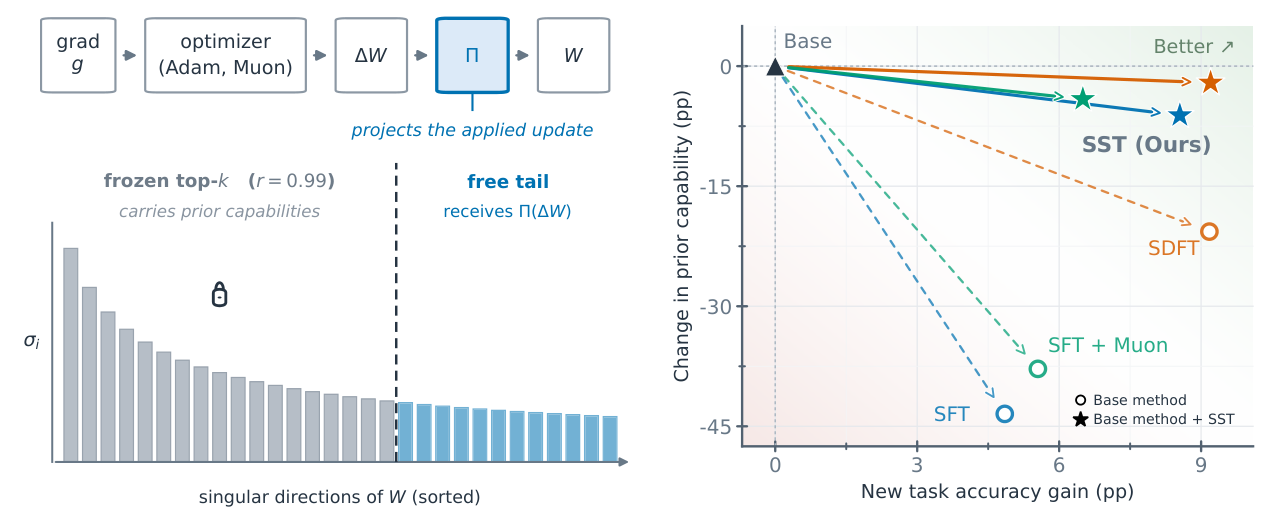
파인튜닝해도 기존 능력은 그대로, 버클리·구글 서브스페이스 튜닝
LLM을 도메인 데이터로 파인튜닝(SFT)하면 원래 갖고 있던 능력이 무너지는 파국적 망각(catastrophic forgetting)이 생깁니다. UC 버클리·구글 등 공동연구팀의 SST는 가중치 업데이트를 하위 특이값 부분공간으로만 제한해 주요 방향을 보호합니다. Qwen3-8B에서 일반 SFT는 기존 능력 점수가 25~57점 떨어졌지만, SST를 얹으면 변화가 -3.8~+1.3점에 그쳤습니다. 베이스 모델 대비 분포 이탈(KL drift)도 2~4배 줄었습니다.
 ai model📚 커리큘럼 학습#36 · 2026. 10. 16.
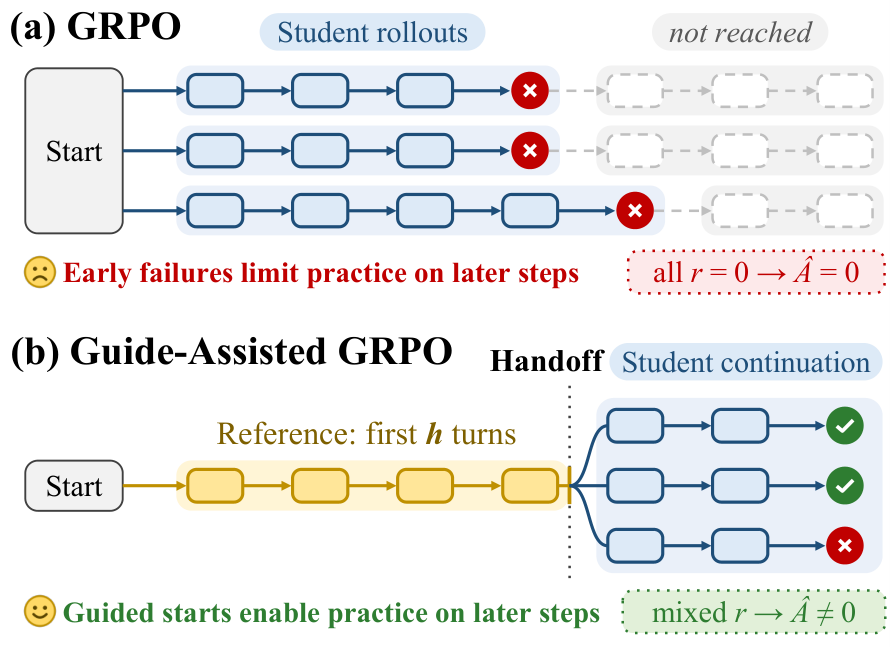
정답 궤적 끝부분부터 이어받아 배우는 에이전트 RL, 서울대 커리큘럼
보상이 완주 시에만 나오는 장기 과제에서는 롤아웃이 전부 실패해 GRPO 학습 신호가 0이 되기 쉽습니다. 서울대·건국대 연구팀은 성공 궤적 앞부분을 재생해 주고 모델이 이어받는 Guide Assisted GRPO에서 시작 위치·인계 단위·이동 규칙을 체계적으로 비교했습니다. 과제 끝 근처에서 시작할 때 가장 좋아 BFCL 8B에서 59.0점으로 GRPO(52.0점)를 앞섰고, AppWorld도 43.1→47.2로 올랐습니다. 설정에 따라 GPU 시간도 약 21% 줄었습니다.
 ai model🎯 소량학습#36 · 2026. 10. 16.
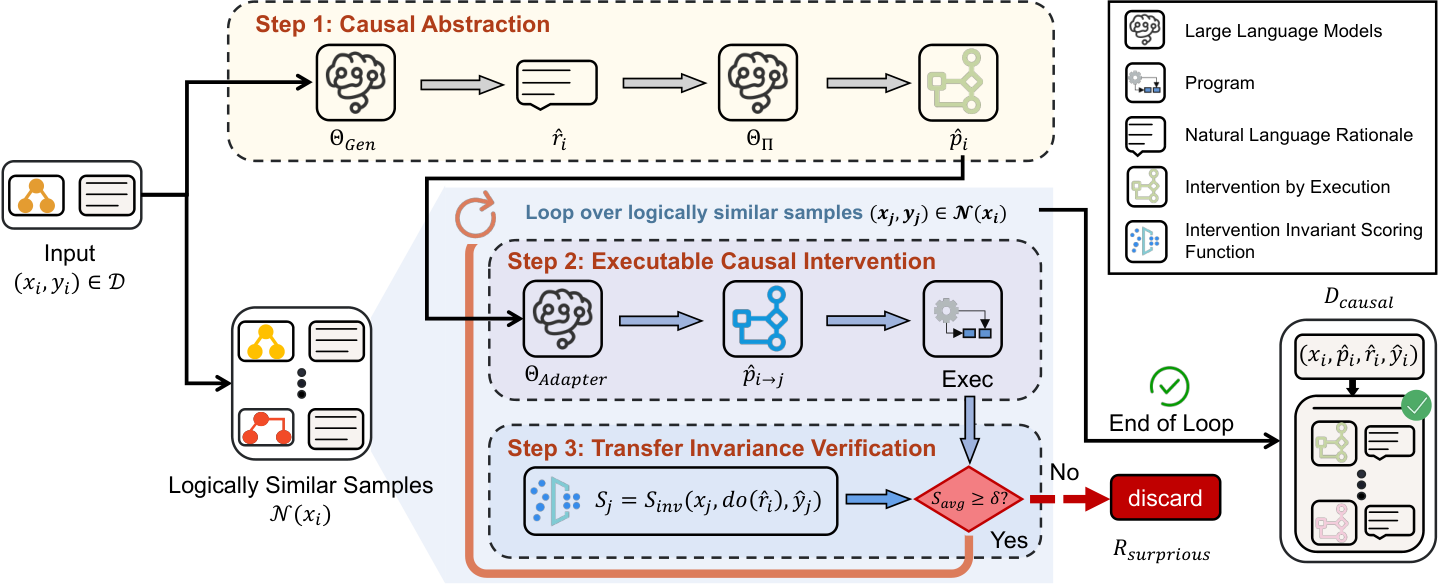
모델이 만든 퓨샷 예시를 인과 개입으로 검증, 예시 줄이고 정확도 올린 ECI2D
모델이 스스로 만든 퓨샷 예시는 보통 '정답을 맞혔는가'로만 거릅니다. 하지만 끼워 맞춘 풀이도 정답을 낼 수 있어 관찰만으로는 구별이 안 됩니다. 상하이자오퉁대 등 중국 연구팀의 ECI2D는 예시의 풀이 근거를 실행 가능한 프로그램으로 바꾼 뒤, 비슷한 다른 문제에 개입(do-intervention)을 걸어도 통하는 예시만 남깁니다. 남기는 예시는 39~57% 줄었고, GSM-Symbolic-P2(Qwen2.5-7B) 정확도는 58.12→65.28로 올랐습니다.
- 📄ai model🎯 소량학습#36 · 2026. 10. 16.
필요한 예시를 스스로 찾아 넣는 멀티모달 에이전트, UT 오스틴 ActICL
멀티모달 ICL은 어떤 예시를 넣느냐에 성능이 좌우되지만, 기존 방식은 유사도 점수로 정해진 개수를 한 번에 뽑아 중복과 노이즈가 섞였습니다. UT 오스틴·럿거스대의 ActICL은 멀티모달 LLM을 에이전트로 사후학습해, 지금 무엇이 부족한지 판단하고 도구로 예시를 반복 검색·필터링하게 합니다. 7개 벤치마크·3개 모델에서 유사도 검색보다 평균 11.6%포인트, 최강 기존 기법보다 4.4점 높았습니다.
- 📄ai model🧬 메타학습#36 · 2026. 10. 16.
재학습 없이 경험만 쌓아 나아지는 에이전트, 알리바바 등 MetaExp
에이전트가 피드백을 재사용 가능한 경험으로 바꾸는 능력은 보통 특정 과제나 외부 스캐폴드에 묶여 새 과제로 옮겨 가지 못합니다. 마카오대·알리바바 등 공동연구팀의 MetaExp는 공유 도구·워크플로는 유지하고 과제만 바꾼 1,000개 검증 가능 과제군의 궤적 4,956개로 Qwen3.5-122B-A10B를 파인튜닝해, '경험에서 배우는 능력' 자체를 학습시켰습니다. 파라미터를 고정한 채 경험만 쌓아 SpreadsheetBench +8.5점, AutomationBench +14.8점을 기록했습니다.
뉴스레터 구독
매일 아침, 놓친 AI 소식을 메일로 받아보세요
가입 없이 이메일만으로 구독됩니다. 언제든 메일 하단에서 해지할 수 있어요.