ai model🙋 능동학습#22 · 2026. 8. 26.
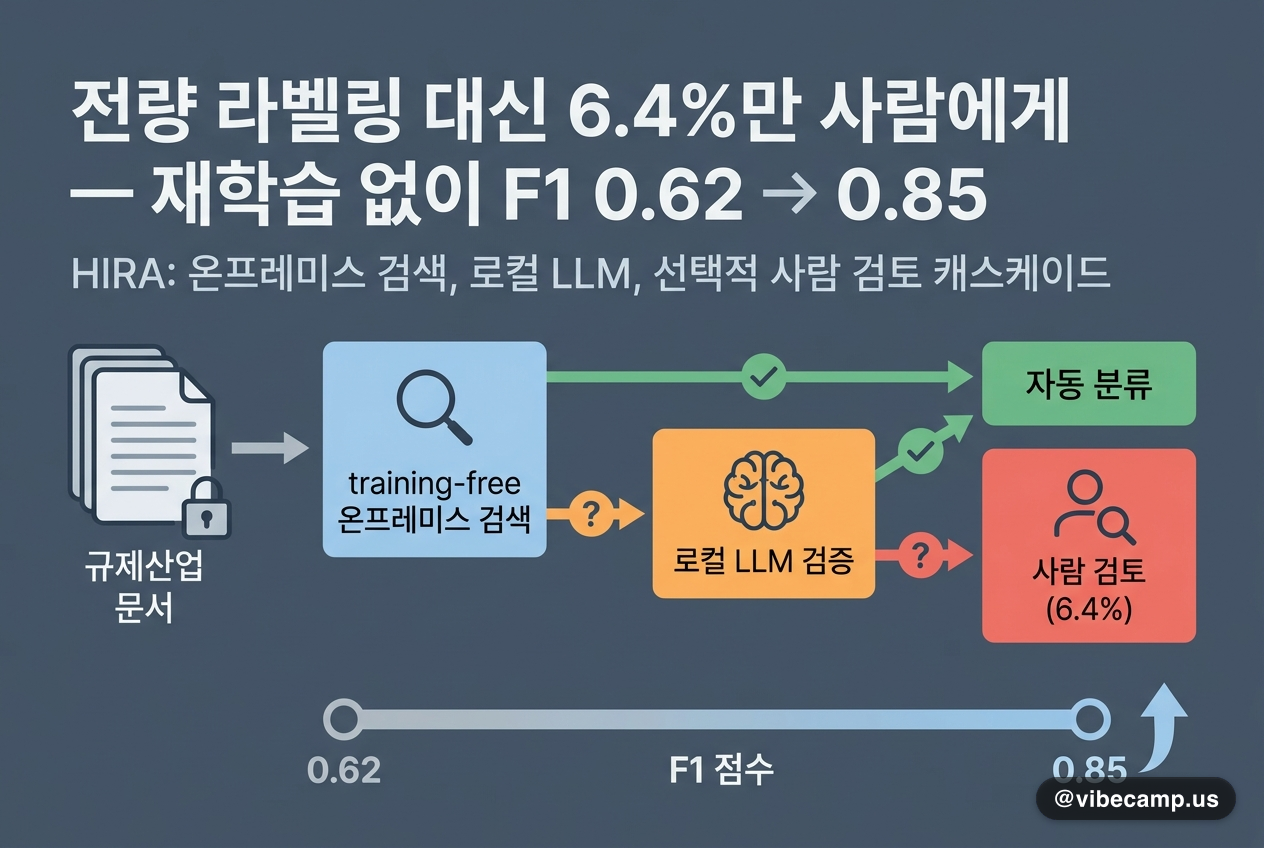
전량 라벨링 대신 6.4%만 사람에게 — 재학습 없이 F1 0.62 → 0.85
규제산업 문서 분류는 데이터 반출 금지, 콜드스타트 라벨 부족, 검토 인력 희소, 모델 거버넌스 비용이 겹쳐 '전량 라벨링 후 재학습' 방식을 쓸 수 없습니다. HIRA는 학습 없이(training-free) 동작하는 온프레미스 검색 캐스케이드로 먼저 분류하고, 확신이 낮은 건만 로컬 LLM 검증자에게, 그래도 애매한 건만 사람에게 올리는 선택적 human-in-the-loop 구조입니다. 핵심은 사람이 고친 건을 가중치 재학습 없이 마진 가중 검색 예시로 저장해 다음 판단에 곧바로 쓴다는 점입니다. 80개 클래스 무역금융 실사용 스트림 30,233건을 처리하면서 사람 교정 요청은 1,945건(6.4%)뿐이었는데 Macro-F1이 0.6218 → 0.8548로 올랐고, 풀의 24.8%인 518건만 고쳤을 때 이미 2,086건 전량을 정답 라벨로 색인한 oracle과 동등했습니다. 8월 25일 arXiv 리스팅으로 공개된 CIKM 2026 채택 논문입니다.