ai model🙋 능동학습#21 · 2026. 8. 25.
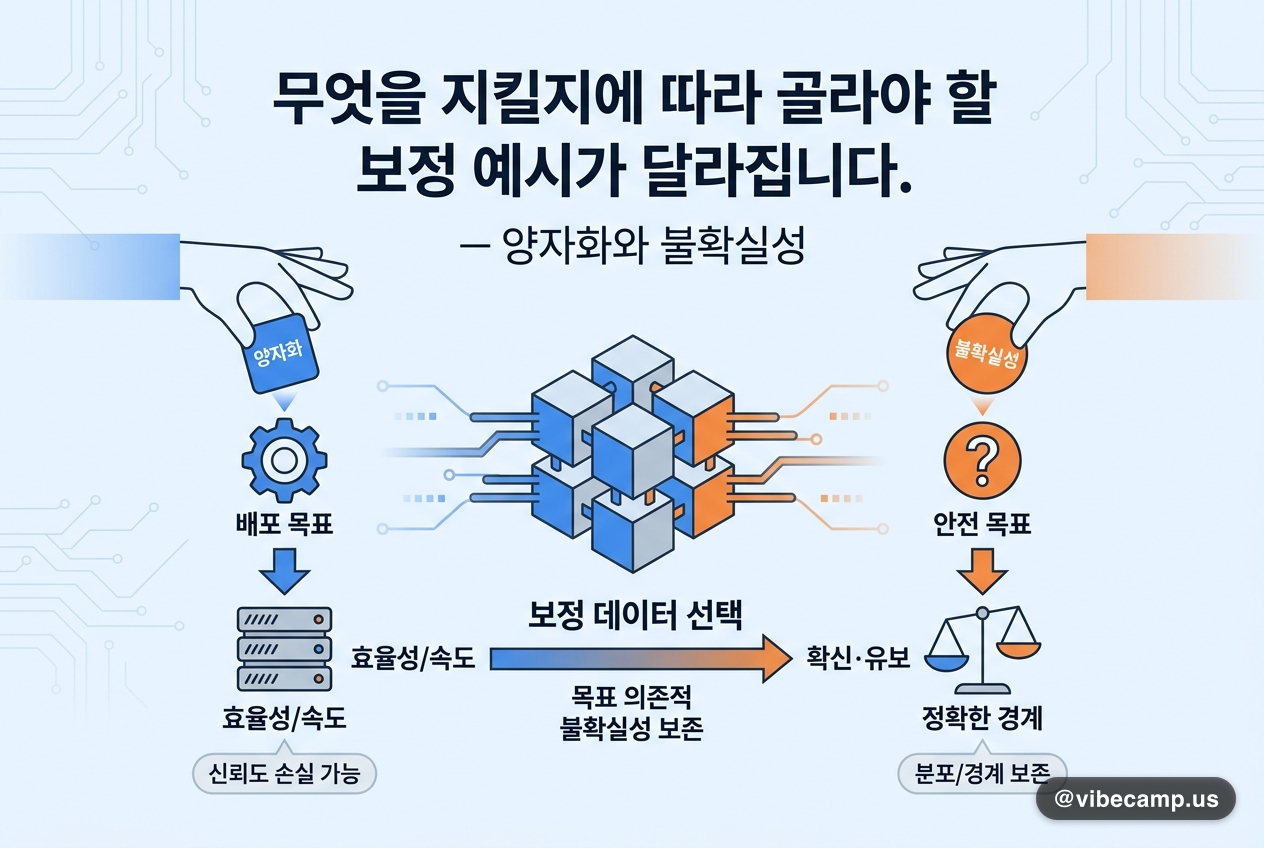
무엇을 지킬지에 따라 골라야 할 보정 예시가 달라집니다 — 양자화와 불확실성
양자화는 LLM 배포에 널리 쓰이지만 confidence·margin·abstention 같은 불확실성 행동에 미치는 영향은 좀처럼 1차 목표로 다뤄지지 않았습니다. 연구진은 보정(calibration) 데이터 선택을 '목표 의존적 불확실성 보존' 문제로 재정의하고, 분포 보존·경계 보존 리스크를 정식화한 뒤 단 하나의 보정 레시피가 모든 목표에 맞을 수는 없다는 mixture-mismatch 논증을 제시했습니다. 제안 기법 DPQ는 full-precision 예측을 이용해 confidence·entropy가 높은 '의심스러운(high-doubt)' 예시와 범용 앵커를 목표에 맞춰 섞는 경량 사전 양자화 레시피군입니다. 언어모델 8종·NLP 벤치마크 9종·비교기법 22개 실험에서 최고 고정 레시피는 보존 목표에 따라 갈렸습니다 — SQuAD2 답변가능성 경계 보존은 DPQ-r75가, 광범위한 객관식 QA 행동 보존은 DPQ-r50이나 confidence-only·entropy-only 같은 완만한 단일 신호 변형이 앞섰습니다. EMNLP Findings 2026 채택 논문입니다.