ai model🔁 자가교정#22 · 2026. 8. 26.
자가수정이 오히려 오류를 키울 때 — 추론 오류를 연산자로 만들어 한 단계씩 되돌립니다
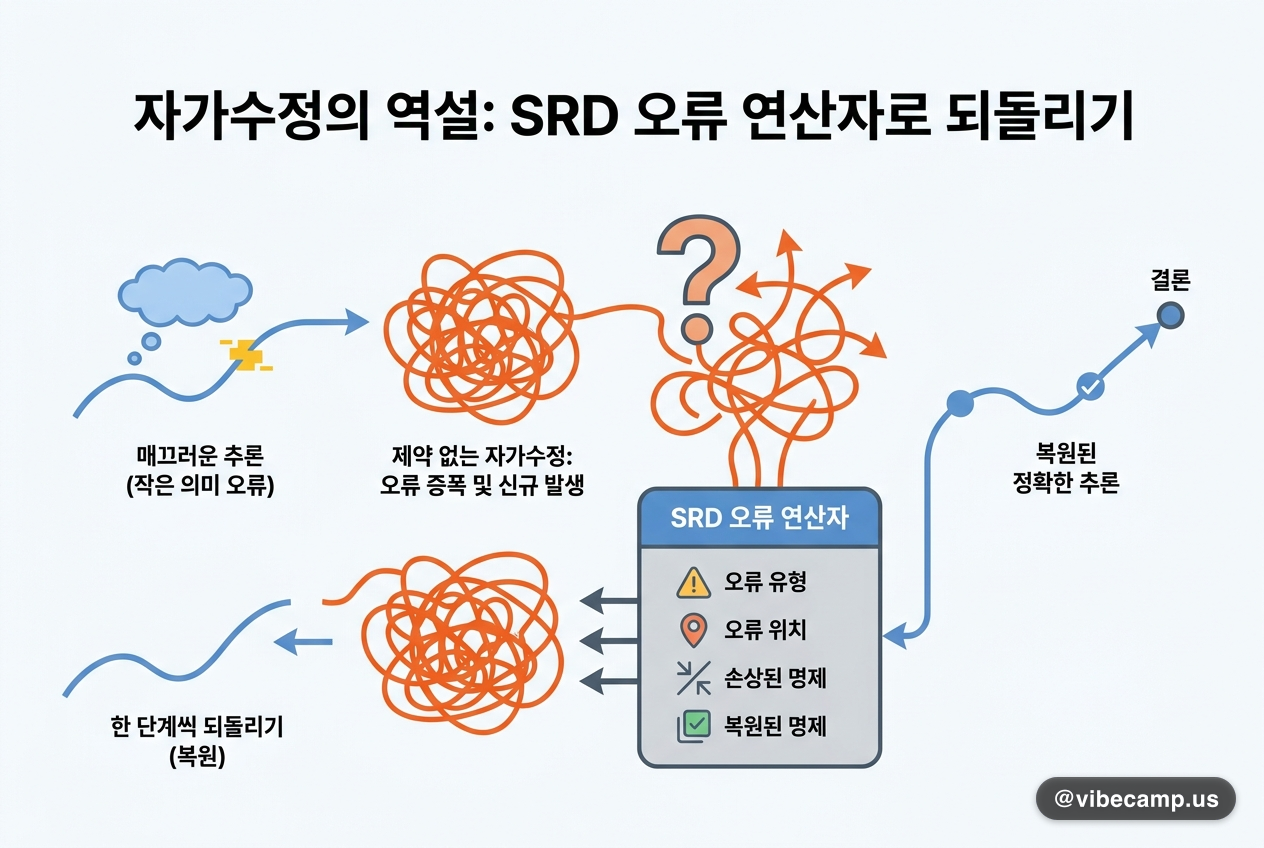
LLM은 매끄러운 추론을 쓰면서도 국소적인 의미 오류를 결론까지 전파합니다. 그런데 제약 없는 자가수정은 그 오류를 그대로 두거나, 오히려 증폭하거나, 없던 오류를 새로 만들기도 합니다. SRD는 오류를 '실행 가능한 오류 연산자'로 표현합니다. 오류 유형, 오류 위치, 손상된 명제, 복원된 명제를 명시한 연산자를 두고, 모델이 현재 궤적에 걸린 의미 노이즈를 스스로 식별해 한 단계 덜 오염된 상태로 되돌리는 마르코프 디노이징 학습법입니다. 기존 디퓨전 언어모델의 반복 정제가 노이즈를 토큰 마스킹·치환으로만 정의해 추론 과정의 오류 자체는 다루지 못했던 지점을 겨냥합니다. 수학·코드·지식·상식 6개 인도메인 벤치마크에서 동일 백본 최강 베이스라인 대비 평균 +3.2점, 7개 교차 데이터셋 전이에서는 Llama-3-8B-Instruct와 대등하고 Qwen3-8B 최강 베이스라인 대비 평균 +2.9점이었습니다. 개선의 핵심이 구조화된 의미 노이즈 예측과 반복적 연산자 실행에 있다는 점도 분석으로 확인했습니다.