ai model🔁 자가교정#22 · 2026. 8. 26.
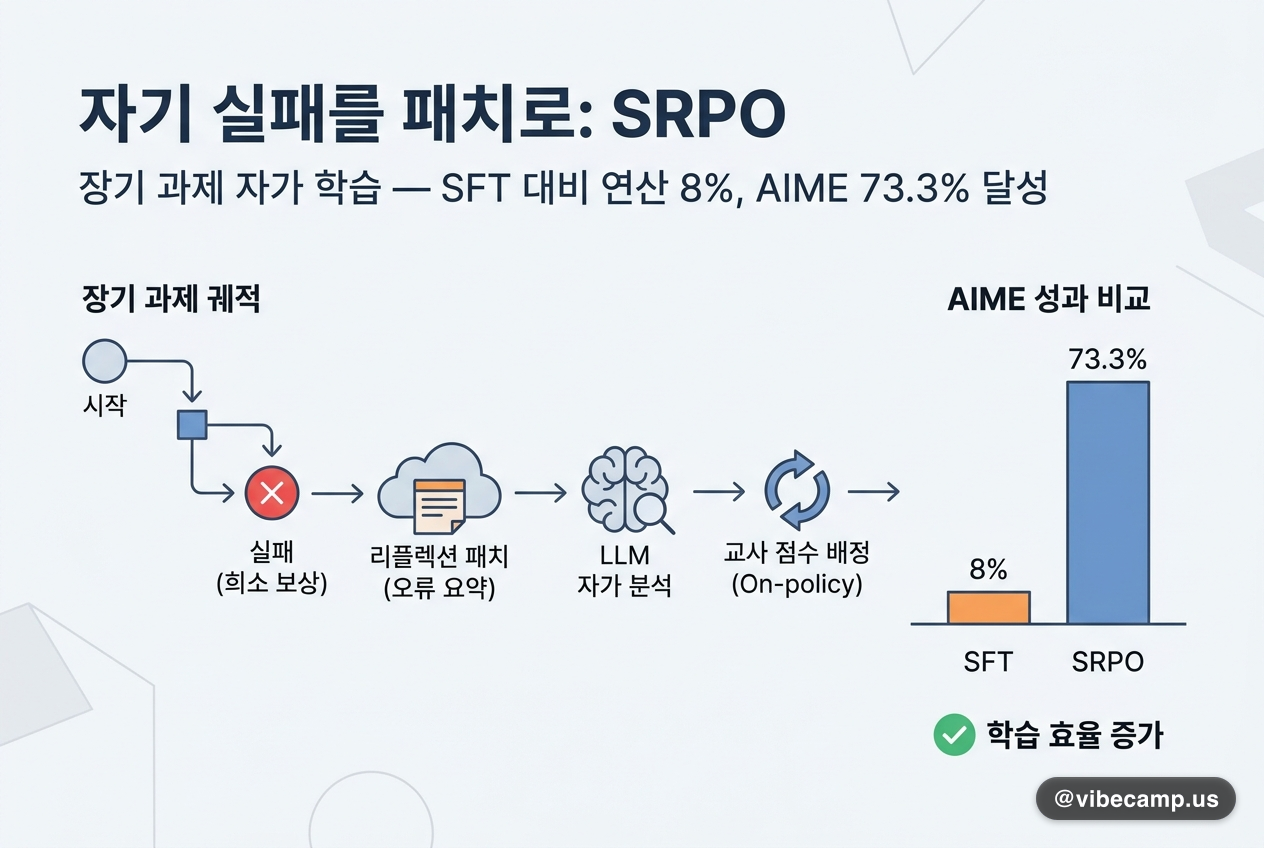
자기 실패를 패치로 요약해 되먹입니다 — SFT 대비 학습 연산 8%로 AIME 73.3%
장기 과제의 보상은 성공/실패라는 희소한 최종 신호뿐이라 어느 단계에서 틀렸는지 크레딧을 배정하기 어렵고, 기존 해법은 외부 크리틱이나 별도 보상모델, 더 큰 교사 모델을 붙여야 했습니다. SRPO는 LLM이 자기가 끝낸 궤적을 스스로 분석해 오류를 짧은 '리플렉션 패치'로 압축하고, 그 패치를 조건으로 매긴 교사 점수를 학생의 on-policy 롤아웃에 토큰 단위 학습 신호로 되먹이는 사후학습 프레임워크입니다. Qwen3-8B 기준 AIME 2024에서 73.3%를 스케일된 SFT 대비 학습 FLOPs 8%만으로 달성했고, WebShop 64.7%, ALFWorld 76.8%, SWE-Bench-Lite 31.2%로 장기 에이전트 벤치마크 성공률도 함께 개선했습니다. 외부 크리틱, 별도 보상모델, 대형 교사 모델 없이 동작한다는 점이 핵심이며, 8월 24일 제출돼 8월 25일 공개된 ICML 2026 채택 논문으로 코드도 GitHub에 공개돼 있습니다.