ai model📚 커리큘럼 학습#24 · 2026. 9. 2.
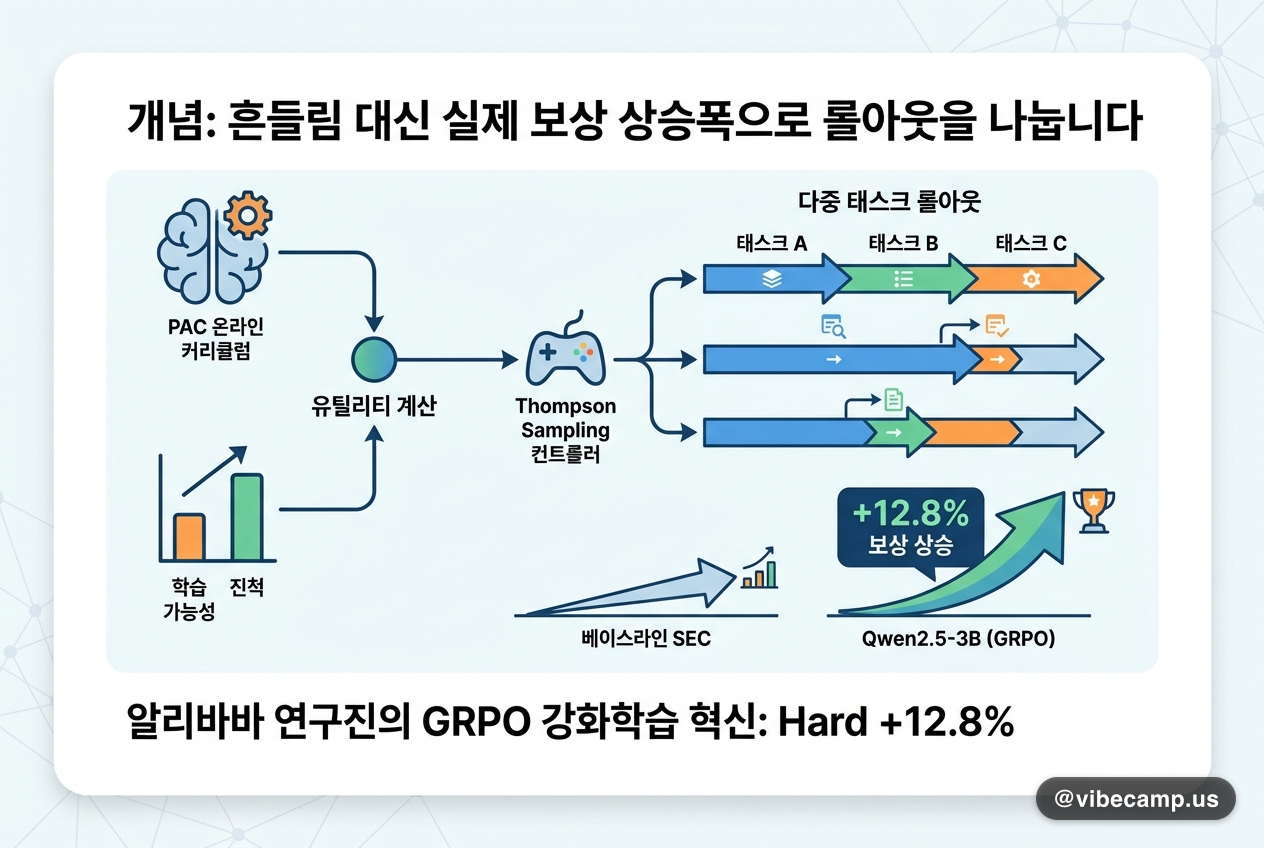
흔들림 대신 실제 보상 상승폭으로 롤아웃을 나눕니다 — Hard +12.8%
알리바바 연구진 11인이 다중 태스크 LLM 강화학습(GRPO)에서 롤아웃 예산 배분을 정하는 온라인 커리큘럼 PAC를 제안했습니다. advantage에서 뽑은 '학습 가능성'과 최근 보상 상승폭인 '진척'을 곱해 유틸리티를 만들고, Thompson Sampling 컨트롤러가 매 배치마다 롤아웃을 나눕니다. 베이스라인 SEC 대비 Qwen2.5-3B 13.1%, 7B 8.5% 상승, Hard는 12.8% 올랐습니다.