본문으로 건너뛰기
vibecamp ai model 목록

vibecamp ai model · #24 · 2026-09-02

vibecamp ai model 2026-09-02 — 참조 문장 없이 이미지만 보고 고릅니다 — 설명 라벨링 최대 1.6배

2026-09-02 AI 모델 일간 호 — 오늘 8개 카드를 정리했습니다.

8개 카드 · 적은 예제로 스스로 깨우치는 학습법 일간

📤 공유하기𝕏@inf💬B
🎯

퓨샷 학습

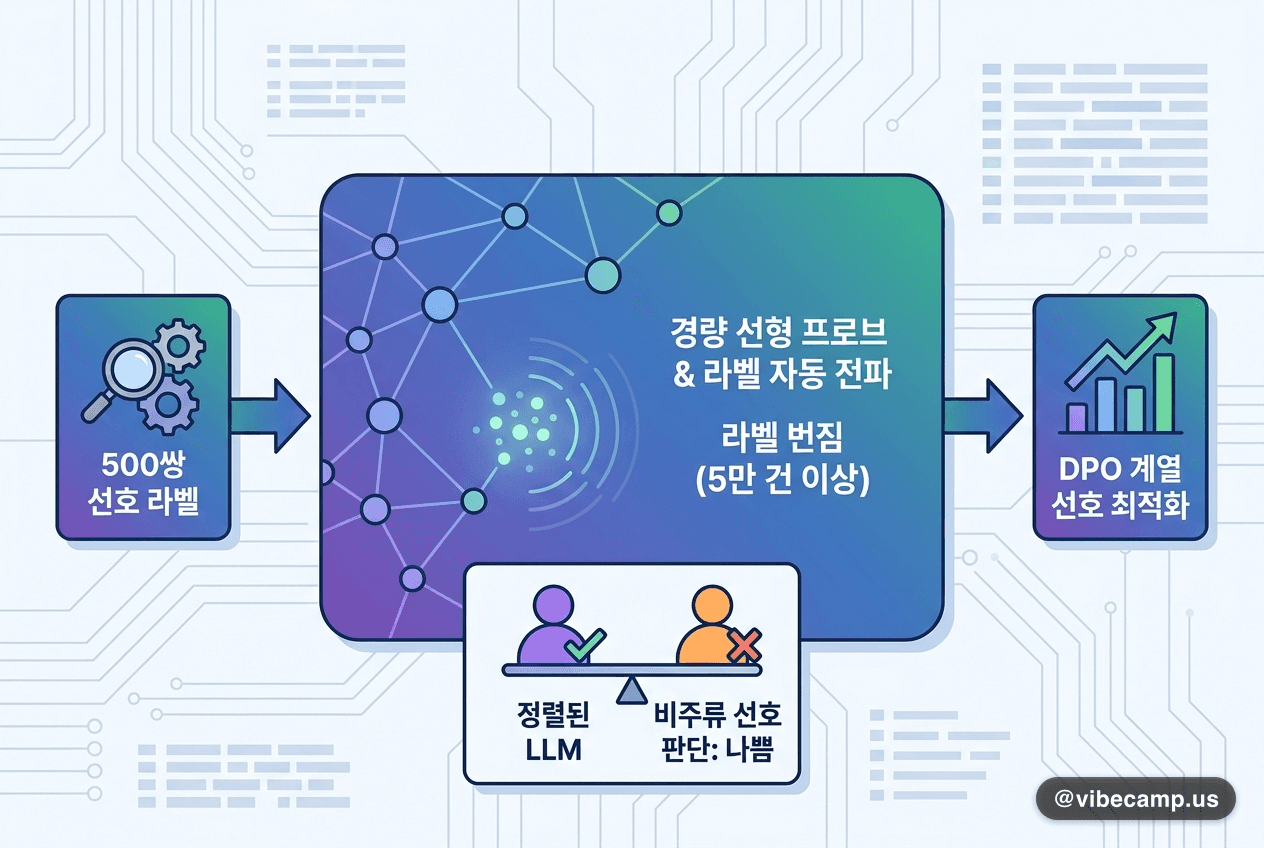
선호 라벨 500쌍으로 5만 건에 라벨을 번집니다 — 예산 50~100배와 대등

선호 라벨 500쌍으로 5만 건에 라벨을 번집니다 — 예산 50~100배와 대등

#
웁살라대학교 연구팀이 선호(preference) 라벨 500쌍 이하로 경량 선형 프로브를 학습시켜 5만 건 이상의 미라벨 데이터에 선호 라벨을 자동 전파하고, 그 데이터로 DPO 계열 선호 최적화를 수행하는 저라벨 적응 기법을 공개했습니다. 활성값 군집 분석으로 정렬된 LLM이 비주류 집단의 선호에서는 오히려 판단자로서 나쁘다는 점도 함께 보였습니다. 같은 라벨링 예산에서 직접 학습보다 일관되게 우수했고, 라벨을 50~100배 더 쓴 베이스라인과도 대부분 설정에서 대등했습니다.
💡문화·주관이 얽힌 선호는 LLM이 스스로 심판할 수 없습니다. 사내 톤이나 소수 집단 정렬을 수백 건 라벨만으로 시작할 수 있는 실무 경로입니다.
원문 →#few-shot-learning#preference-optimization#dpo#label-propagation#alignment
📚

커리큘럼 학습

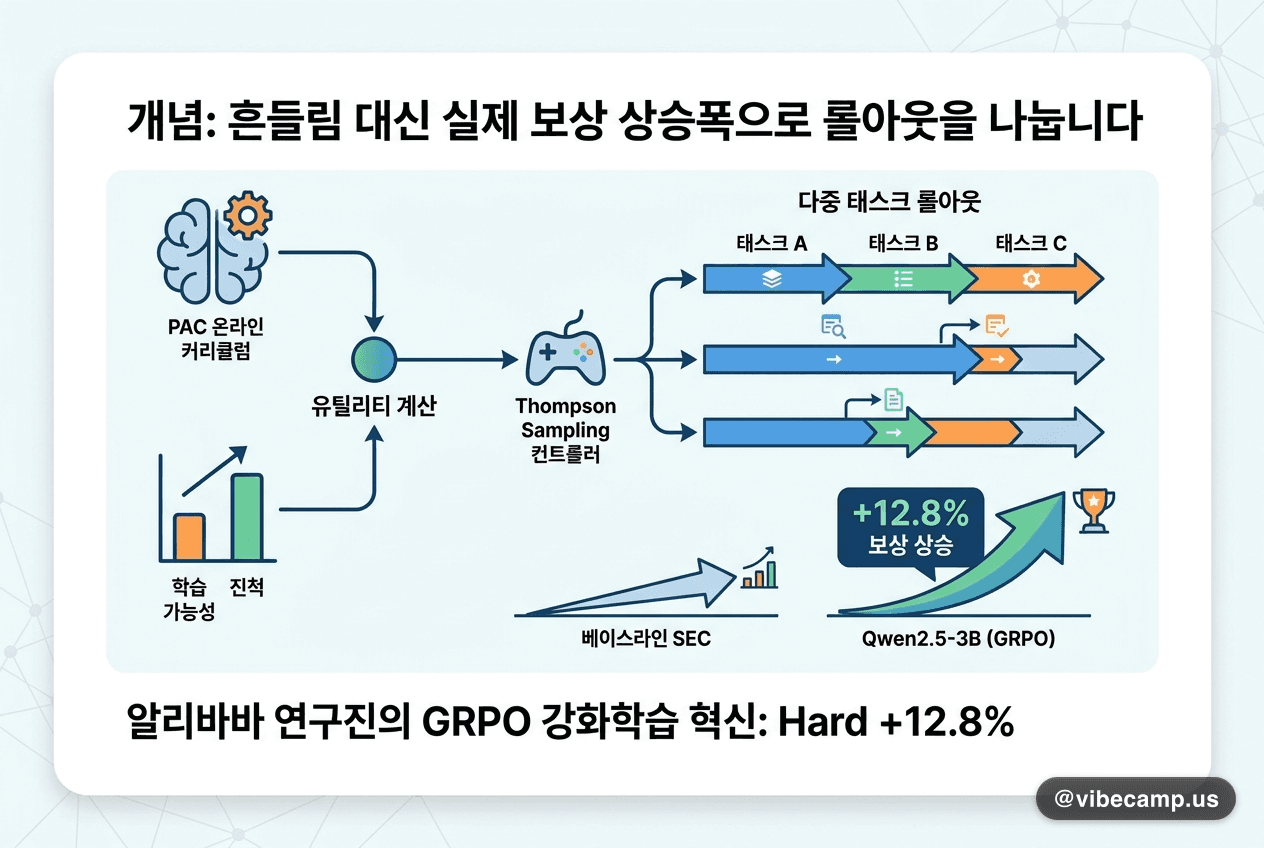
흔들림 대신 실제 보상 상승폭으로 롤아웃을 나눕니다 — Hard +12.8%

흔들림 대신 실제 보상 상승폭으로 롤아웃을 나눕니다 — Hard +12.8%

#
알리바바 연구진 11인이 다중 태스크 LLM 강화학습(GRPO)에서 롤아웃 예산 배분을 정하는 온라인 커리큘럼 PAC를 제안했습니다. advantage에서 뽑은 '학습 가능성'과 최근 보상 상승폭인 '진척'을 곱해 유틸리티를 만들고, Thompson Sampling 컨트롤러가 매 배치마다 롤아웃을 나눕니다. 베이스라인 SEC 대비 Qwen2.5-3B 13.1%, 7B 8.5% 상승, Hard는 12.8% 올랐습니다.
💡정책이 크게 흔들리는 태스크와 실제로 나아지는 태스크는 다릅니다. 진척 신호를 빼면 9.5% 떨어질 만큼, 학습 가능성을 어떻게 정의하느냐가 예산을 좌우합니다.
원문 →#curriculum-learning#reinforcement-learning#grpo#alibaba#emnlp-2026
🪞

자가수정 학습

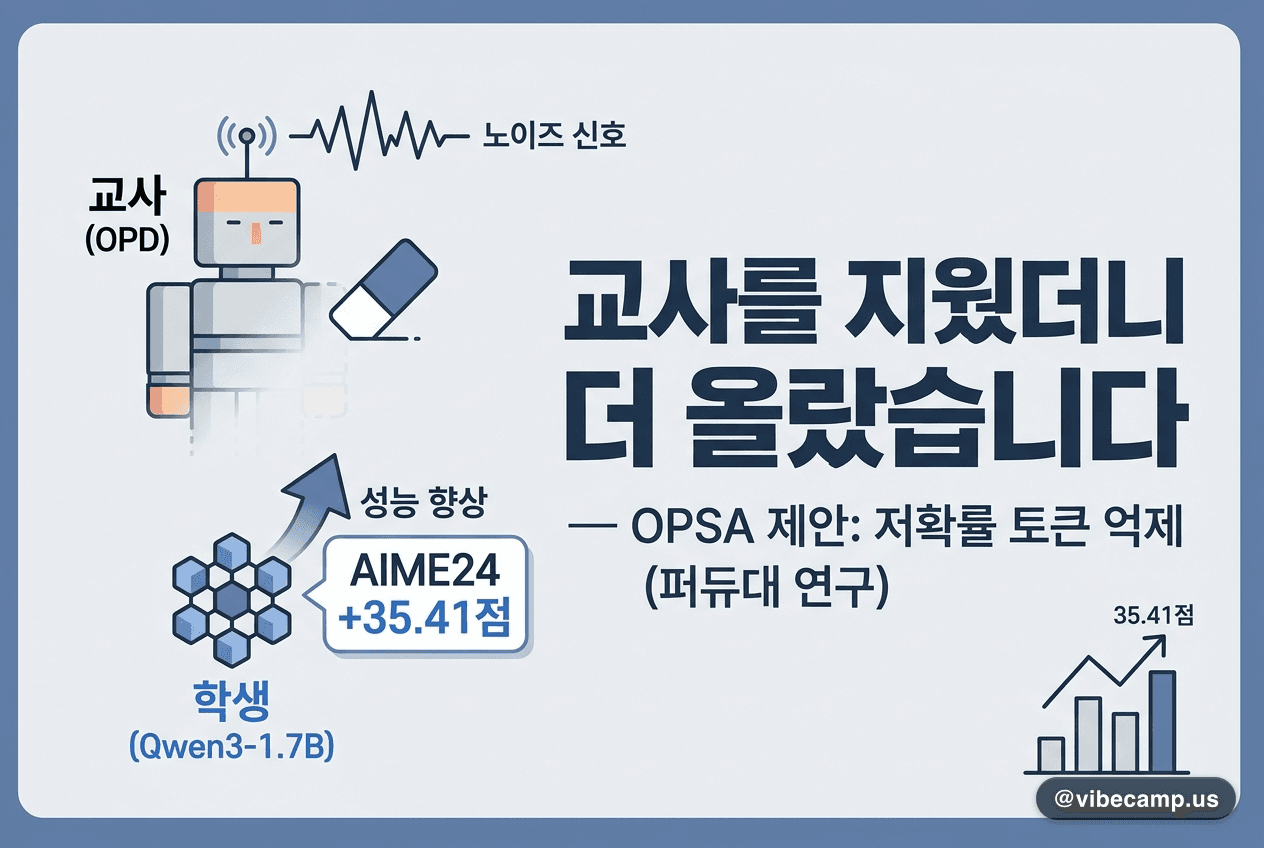
교사를 지웠더니 더 올랐습니다 — AIME24 +35.41점

교사를 지웠더니 더 올랐습니다 — AIME24 +35.41점

#
퍼듀대학교 연구팀이 온폴리시 증류(OPD)가 교사에게서 무엇을 배우는지 해부했습니다. 교사 신호의 노이즈 비율은 교사가 커질수록 늘었는데도 학생 성능은 노이즈 유지 여부와 무관했습니다. 이득의 정체가 지식 전달이 아니라 저확률 토큰 억제라는 결론에서 교사를 제거한 OPSA를 제안합니다. Qwen3-1.7B에서 AIME24가 35.41점(상대 263%) 올랐고, OPD보다도 16.77점 앞섰습니다.
💡비싼 교사 모델을 돌리기 전에, 그 이득이 진짜 지식 전달에서 오는지 아니면 단순한 확률 분포 정리에서 오는지부터 확인해볼 만한 결과입니다.
원문 →#self-correction#distillation#reasoning#qwen3#aime
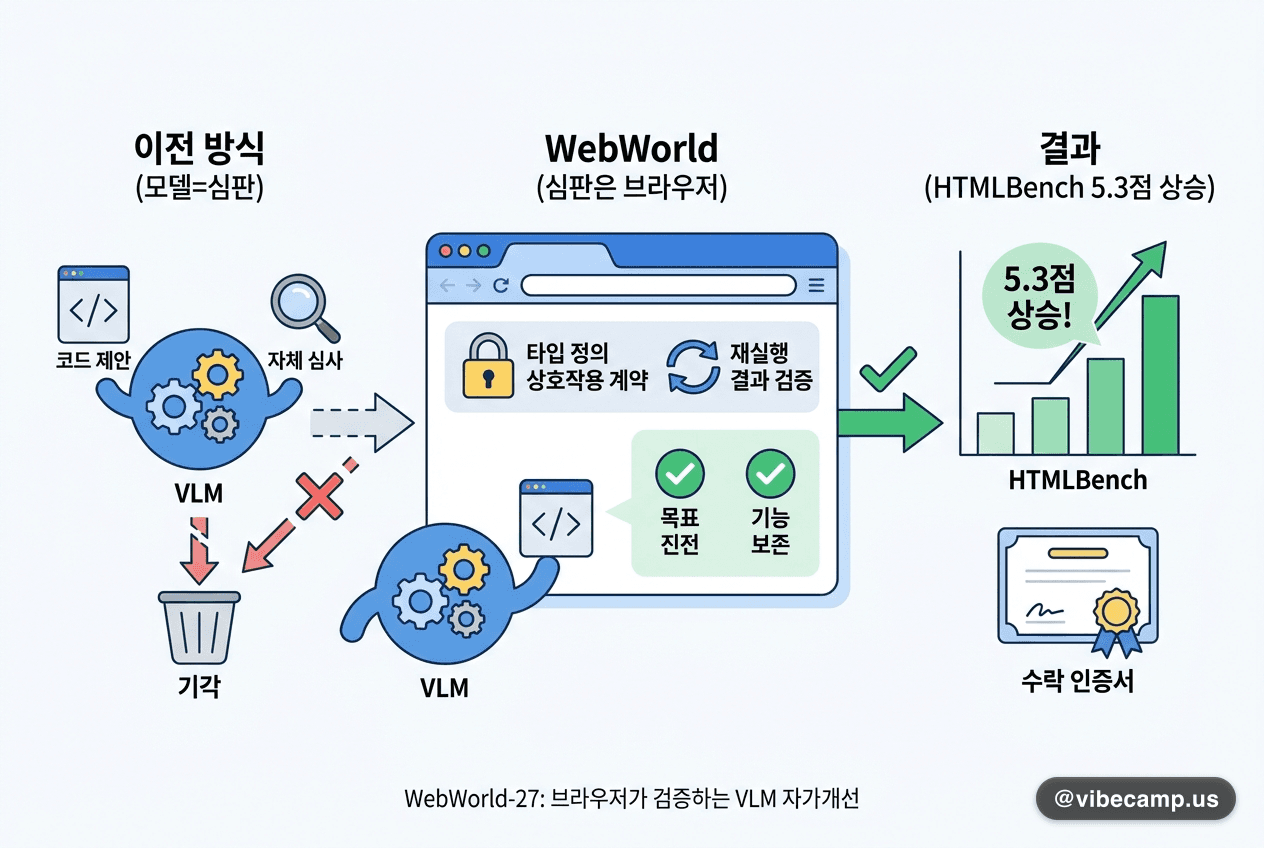
심판을 브라우저에 맡겼습니다 — HTMLBench 5.3점 상승

심판을 브라우저에 맡겼습니다 — HTMLBench 5.3점 상승

#
베이항대·상하이교통대·IQuest·Langboat 공동 연구팀이 VLM의 웹 코드 자가개선에서 '제안한 모델이 심판까지 겸하는' 결함을 지적했습니다. WebWorld는 브라우저를 속일 수 없는 상대로 세워, 비평을 타입이 정의된 상호작용 계약으로 컴파일하고 재실행 결과가 목표 진전과 기능 보존을 모두 만족할 때만 수락 인증서를 냅니다. WebWorld-27B는 HTMLBench-400에서 5.3점, MiniAppBench-Val에서 14.9점 올랐습니다.
💡자가수정이 자기 확신만 강화하고 끝나는 실패는 흔합니다. 실행 결과처럼 속일 수 없는 외부 검증을 루프 안에 넣느냐가 성패의 갈림길이 됩니다.
원문 →#self-correction#vlm#web-code#world-model#emnlp-2026
🧪

액티브러닝

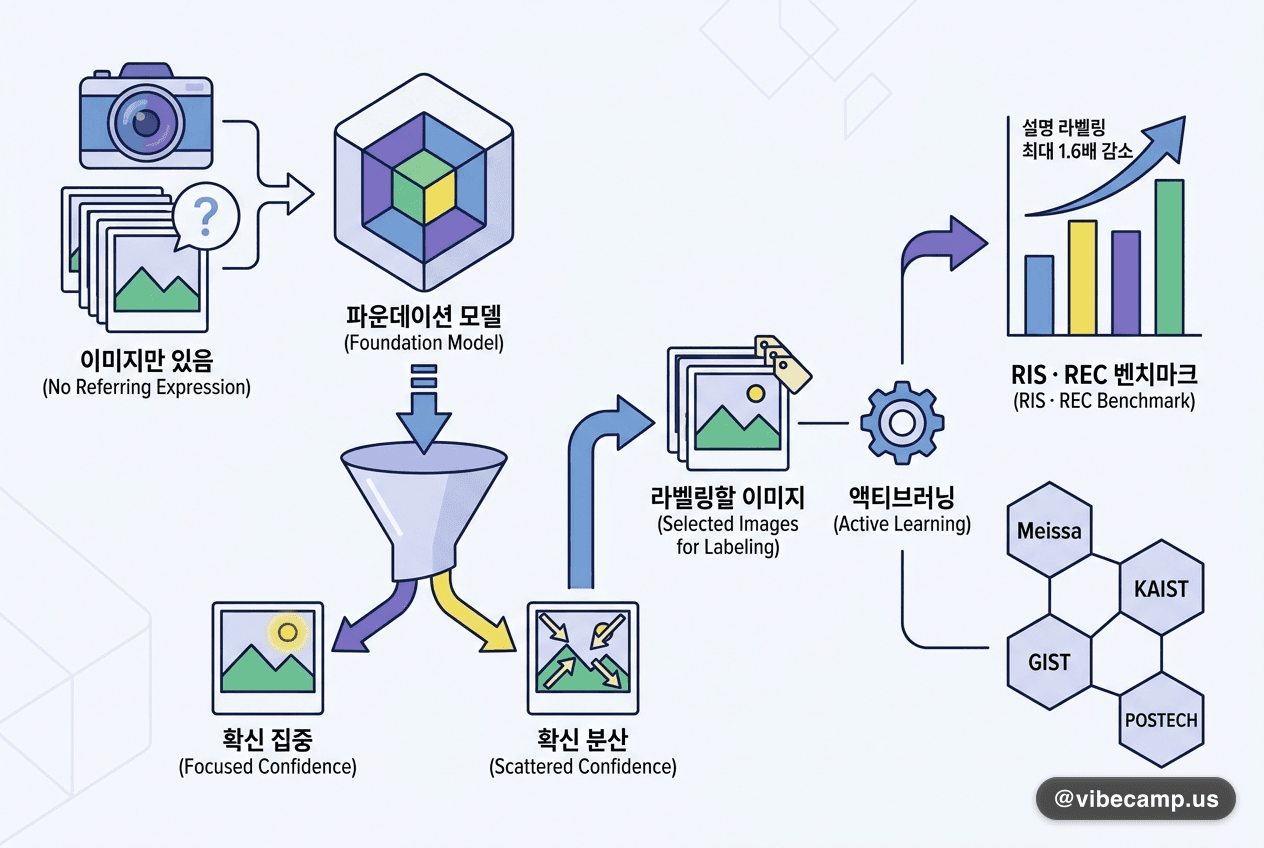
참조 문장 없이 이미지만 보고 고릅니다 — 설명 라벨링 최대 1.6배

참조 문장 없이 이미지만 보고 고릅니다 — 설명 라벨링 최대 1.6배

#
Meissa·KAIST·GIST·POSTECH 공동 연구팀이 이미지만 있고 참조 문장(referring expression)은 없는 조건에서 액티브러닝을 다시 정의했습니다. 파운데이션 모델로 보조 region-text 쌍을 만든 뒤, 모델 확신이 한 영역에 몰리는지 여러 후보로 흩어지는지를 재는 새 획득함수로 라벨링할 이미지를 고릅니다. RIS·REC 벤치마크에서 여러 베이스라인을 일관되게 상회했고, 설명 라벨링 속도는 최대 1.6배 빨라졌습니다.
💡라벨이 비싼 태스크에서는 '무엇을 라벨링할지 고르는 기준'이 모델 구조만큼 성능을 좌우합니다. 데이터 수집 설계도 결국 학습 설계의 일부라는 이야기입니다.
원문 →#active-learning#visual-grounding#data-labeling#emnlp-2026#korea-research
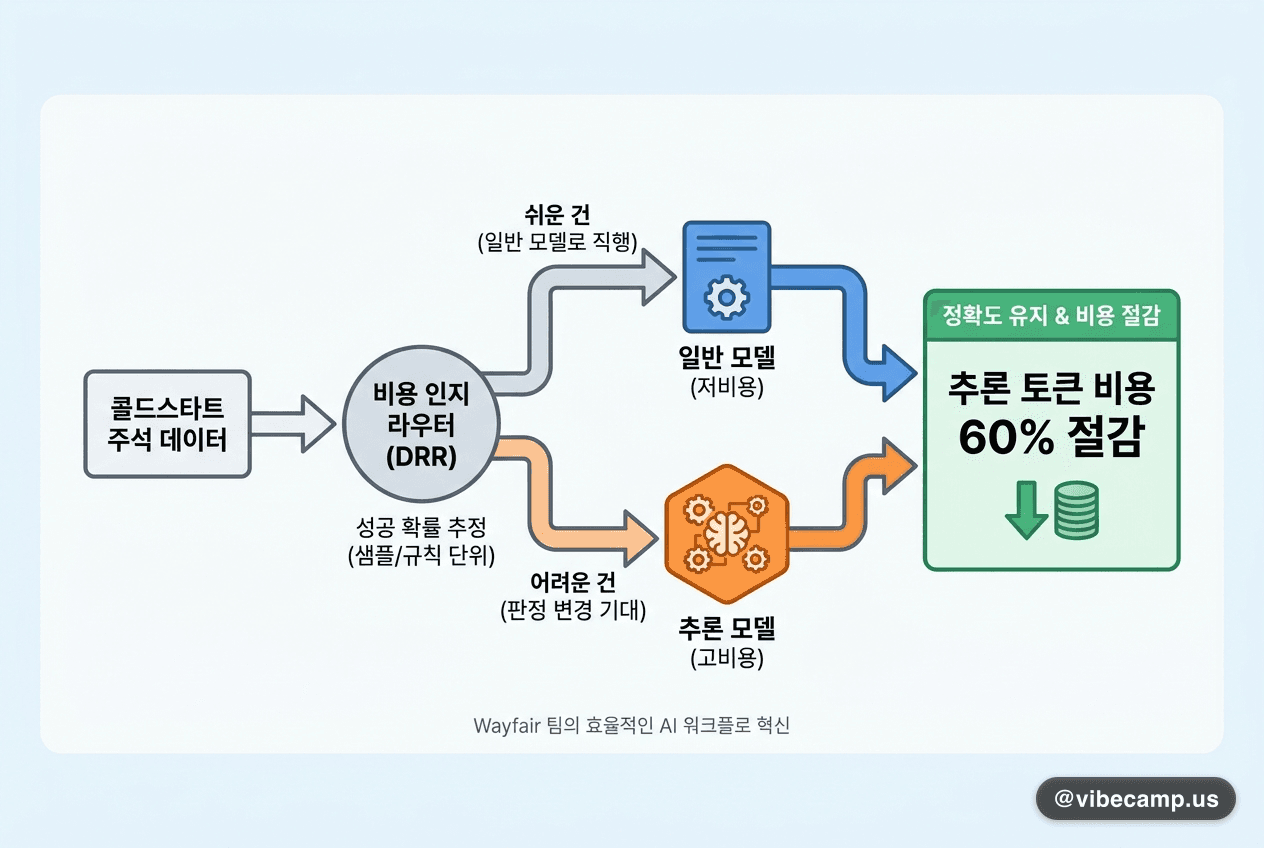
쉬운 건은 일반 모델로 직행 — 추론 토큰 비용 60% 절감

쉬운 건은 일반 모델로 직행 — 추론 토큰 비용 60% 절감

#
이커머스 기업 Wayfair 팀이 콜드스타트 LLM 주석용 비용 인지 라우터 DRR을 공개했습니다. 일반 모델과 추론 모델의 성공 확률을 샘플 단위·규칙 단위로 각각 추정해, 추론이 실제로 판정을 바꿀 것으로 기대되는 건에만 비싼 추론 모델을 붙입니다. 실제 프로덕션 워크플로에서 가장 강한 신뢰도 기반 라우터와 정확도 동률을 지키며 추론 토큰 비용을 60% 이상 줄였습니다.
💡추론 모델을 기본 폴백으로 두는 습관이 비용의 대부분을 만듭니다. '언제 추론이 답을 바꾸는가'를 미리 추정하는 것만으로 절반 넘게 아낄 수 있습니다.
원문 →#active-learning#llm-routing#cost-optimization#annotation#production
🔄

지속학습

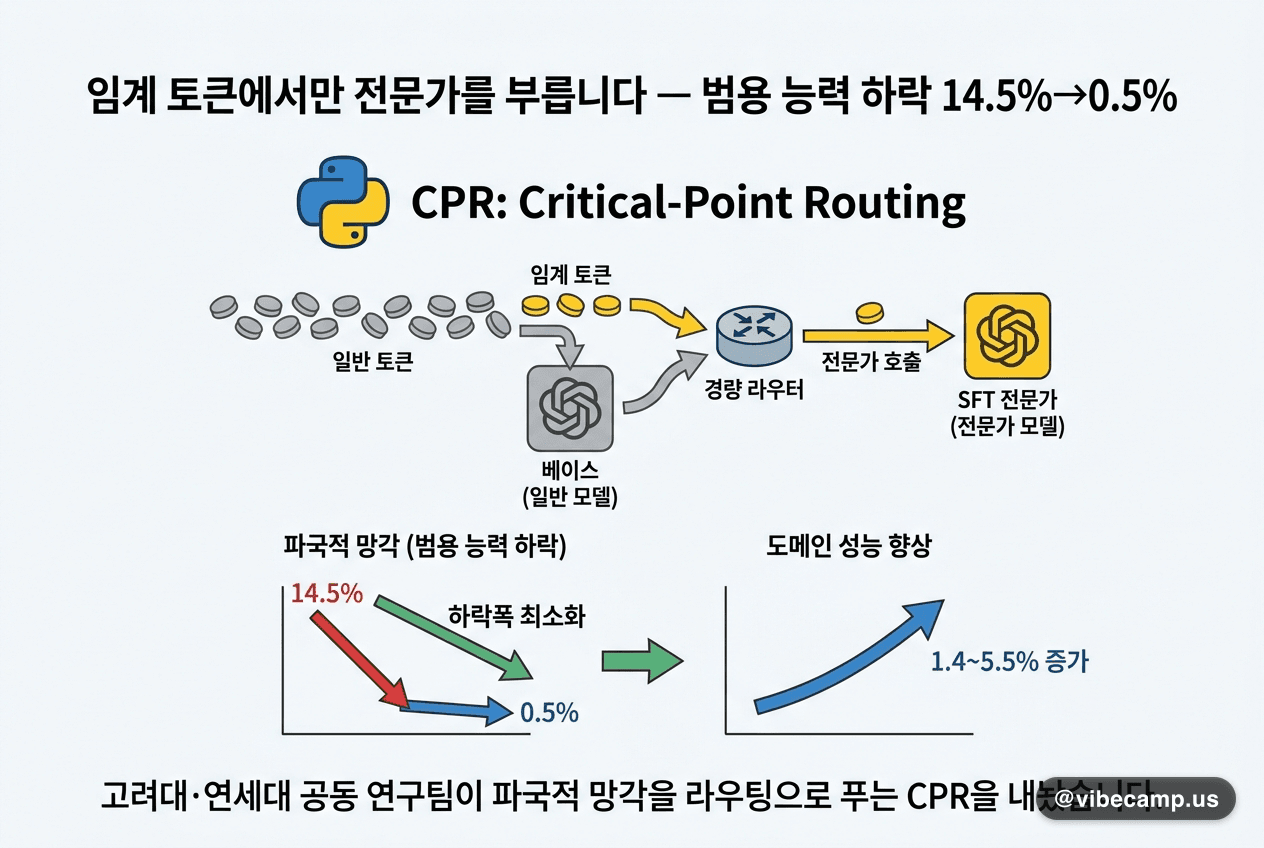
임계 토큰에서만 전문가를 부릅니다 — 범용 능력 하락 14.5%→0.5%

임계 토큰에서만 전문가를 부릅니다 — 범용 능력 하락 14.5%→0.5%

#
고려대·연세대 공동 연구팀이 파국적 망각을 손실함수 대신 라우팅으로 푸는 CPR(Critical-Point Routing)을 내놨습니다. 베이스는 틀리고 SFT 전문가는 맞히는 '임계 토큰'으로 경량 라우터를 학습시켜, 추론 시 토큰마다 전문가 호출 여부를 정합니다. 도메인 성능은 1.4~5.5% 올랐고 범용 능력 하락폭은 3.4~14.5%에서 최대 0.5%로 줄었습니다.
💡두 능력을 하나의 가중치에 욱여넣지 않고 모델 수준에서 분리하면, 도메인 성능과 범용성의 트레이드오프 자체를 우회할 수 있다는 결과입니다.
원문 →#continual-learning#catastrophic-forgetting#routing#fine-tuning#korea-research
🧬

메타러닝

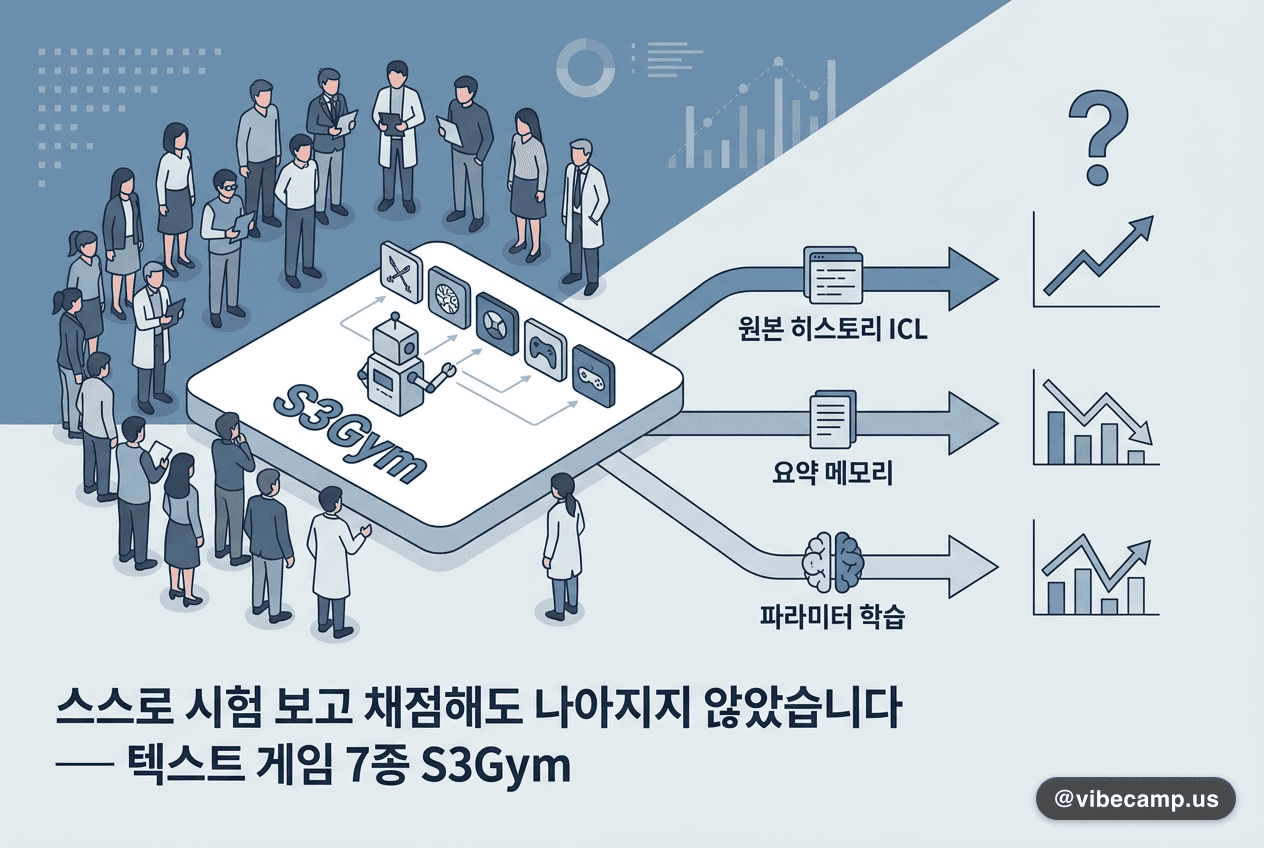
스스로 시험 보고 채점해도 나아지지 않았습니다 — 텍스트 게임 7종 S3Gym

스스로 시험 보고 채점해도 나아지지 않았습니다 — 텍스트 게임 7종 S3Gym

#
연구진 21인이 에이전트가 스스로 시험 보고 스스로 판정한 경험을 실제 성능 향상으로 바꾸는지 재는 인터랙티브 벤치마크 S3Gym을 공개했습니다. 텍스트 게임 7종과 실행 가능한 환경 검증기 위에서 원본 히스토리 ICL, 요약 메모리, 파라미터 학습 세 경로를 같은 조건으로 비교했습니다. 자기개선은 자동도 균일하지도 않았고 최적 경로가 태스크 구조에 좌우됐으며, 파라미터 학습에서는 음의 전이도 관측됐습니다.
💡잘한 행동을 알아보는 것만으로는 부족합니다. 피드백을 실행 가능하고 전이 가능한 정책으로 바꾸는 단계가 자기개선의 진짜 병목이라는 점을 보여줍니다.
원문 →#meta-learning#agent-benchmark#self-improvement#in-context-learning#evaluation

이 호가 도움됐다면 공유해 주세요 — 빌더 한 명이 더 알게 됩니다.

📤 공유하기𝕏@inf💬B
vibecamp ai model 2026-09-02 — 참조 문장 없이 이미지만 보고 고릅니다 — 설명 라벨링 최대 1.6배 | vibecamp ai model