ai model🔁 자가교정#21 · 2026. 8. 25.
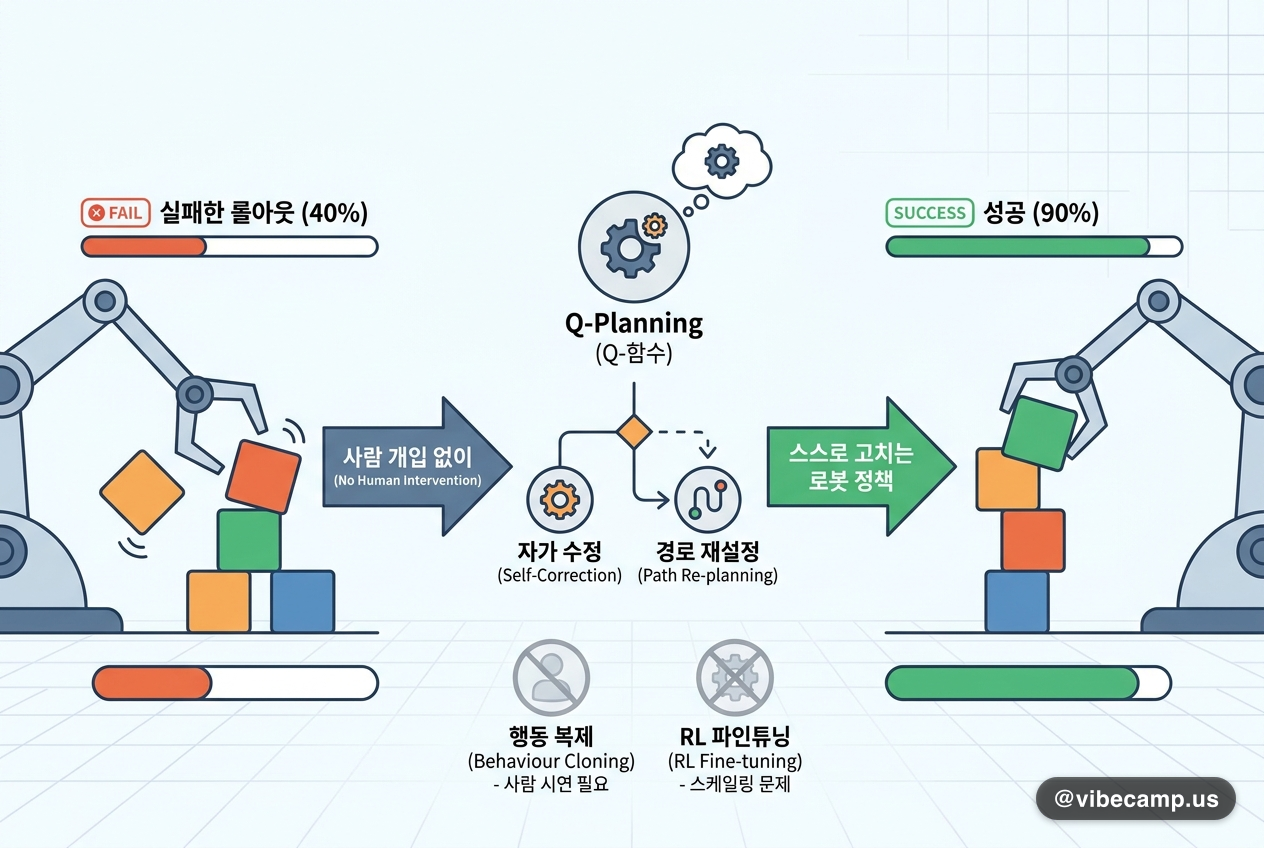
실패한 롤아웃으로 스스로 고치는 로봇 정책 — 사람 개입 없이 40→90%
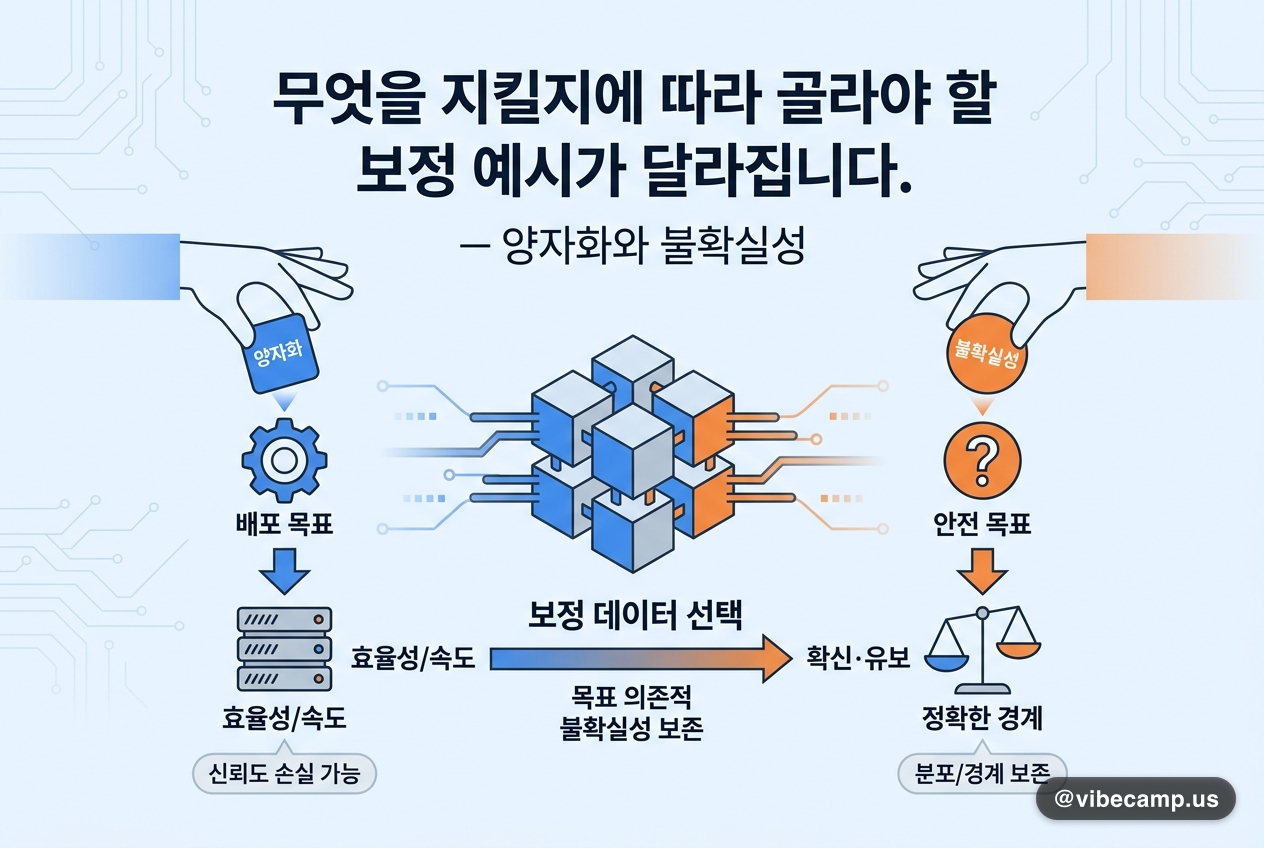
행동 복제(Behaviour Cloning) 정책은 실패해도 사람이 시연을 더 넣어주지 않으면 스스로 고치지 못하고, RL 파인튜닝은 수십억 파라미터 정책에 스케일되지 않습니다. Q-Planning은 대형 visuomotor 행동 복제 정책에 작은 off-policy Q-함수를 붙입니다. Q-함수는 행동을 모방하는 대신 가치를 추정하므로 배포 중 나온 성공·실패 롤아웃을 모두 흡수할 수 있고, 추론 시에는 행동 복제 샘플들에 대한 단일 스텝 Q-가중 평균으로 행동을 고르며 온라인 자가개선 단계에서 행동 복제 가중치는 그대로 두고 Q-함수만 미세조정합니다. 10회 반복 후 LIBERO-10은 93→99%, 양팔 RoboTwin은 83.8→91.4%로 올랐고, 실제 접촉 위주 양팔 과제에서는 사람 개입 없이 stack-cups 40→90%, insert-wallet 25→80%(5회 반복)를 기록한 반면 성공 롤아웃만 쓴 SFT는 각각 55%·30%에서 정체했습니다. 같은 온라인 예산에서 보조 actor 학습 없이 실패로부터 안정적으로 개선한 것은 이 방법뿐이었습니다.