ai model🙋 능동학습#19 · 2026. 8. 22.
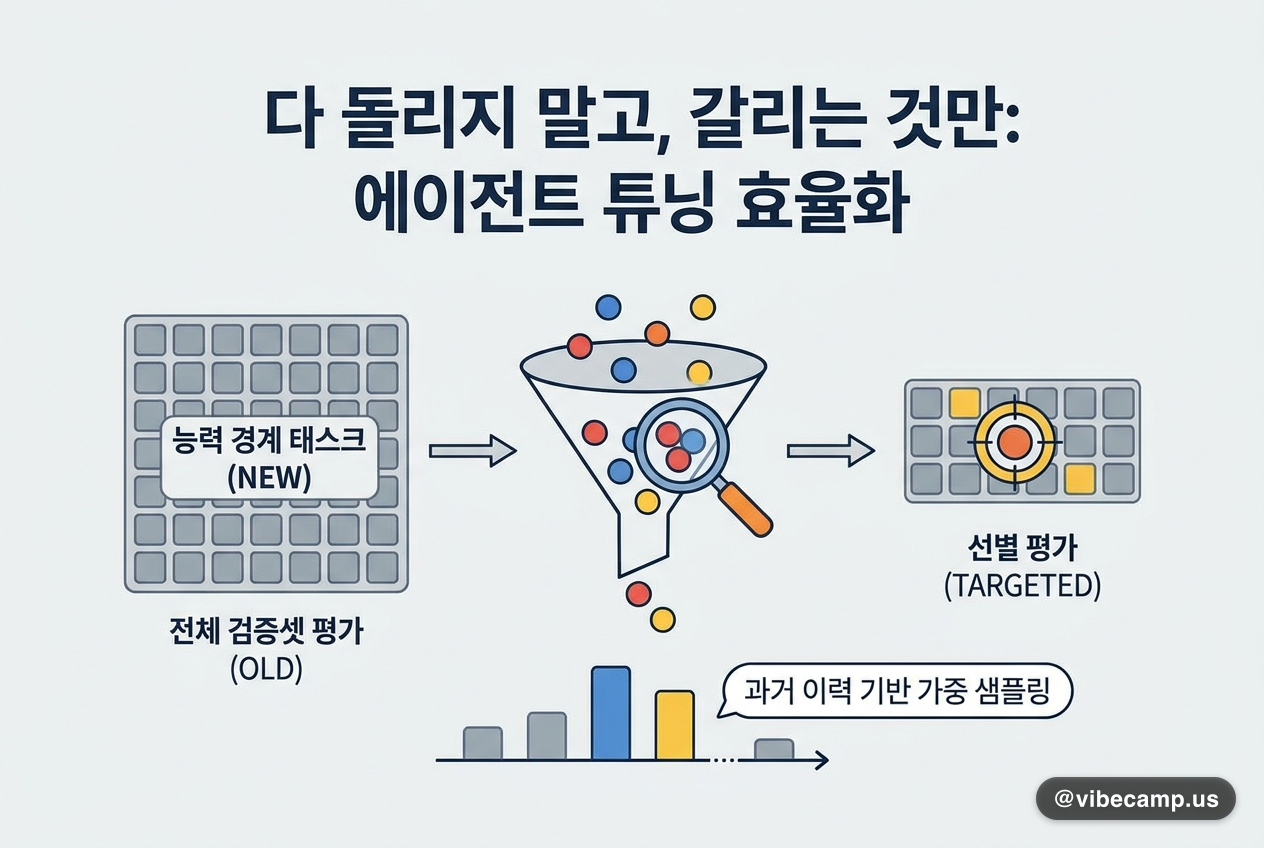
다 돌리지 말고 갈리는 것만 골라 평가하는 에이전트 튜닝
도쿄대 팀이 LLM 에이전트의 하네스(agent harness) 코드를 반복 개선할 때 매 회차 검증셋을 통째로 돌리던 관행을 바꿨습니다. 후보 하네스끼리 답이 엇갈리는 태스크가 항상 맞거나 항상 틀리는 태스크보다 변별력이 크다는 관찰에서, 과거 채점 이력 기반 분산 가중 샘플링으로 능력 경계의 태스크만 골라 평가합니다. 샘플링 확률을 보정해 부분 평가만으로 전체 점수를 추정합니다. Terminal-Bench 2.1 등에서 최종 성능은 전체 탐색과 동등하고 평가 횟수만 80% 줄었습니다.