ai model📚 커리큘럼 학습#22 · 2026. 8. 26.
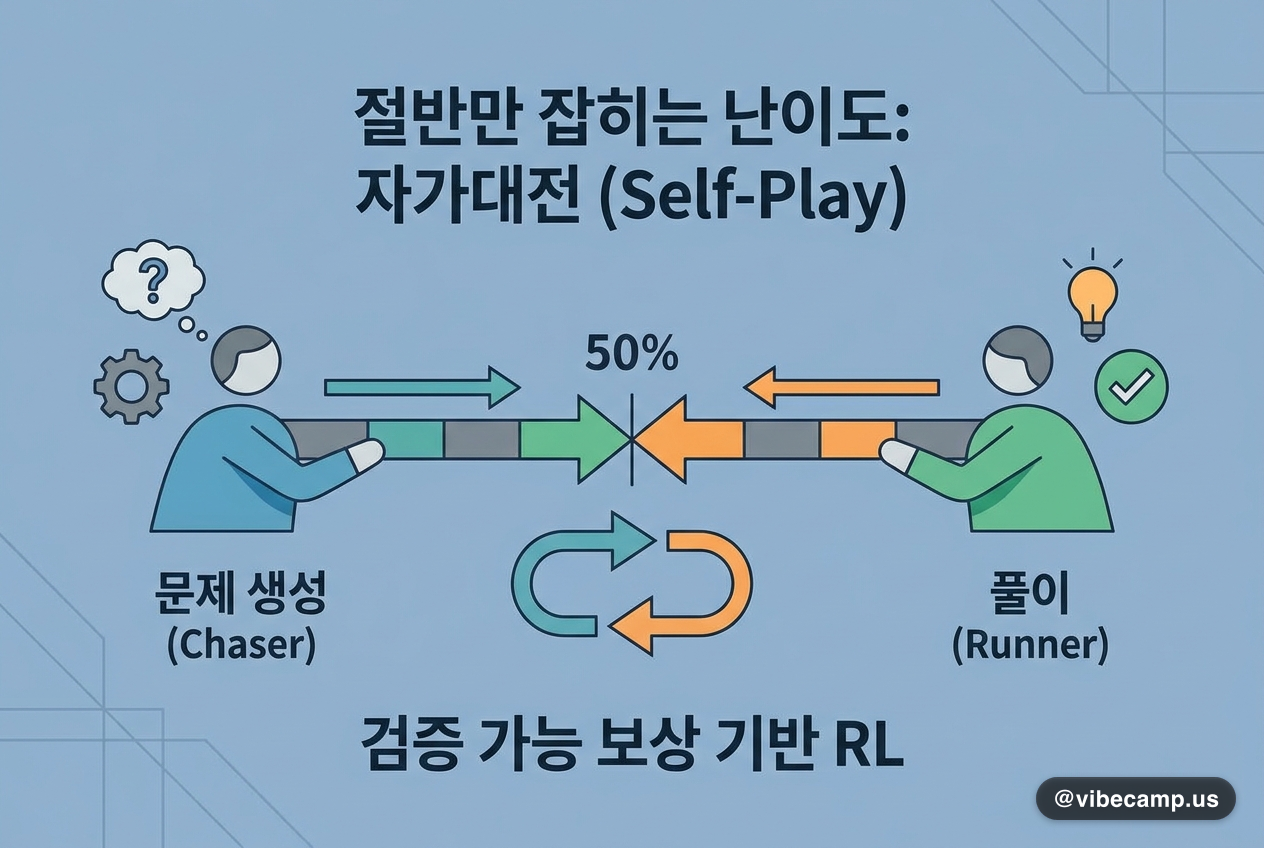
문제를 내는 쪽을 학습시킵니다 — '절반만 잡히는 난이도'를 노리는 자가대전
검증 가능 보상 기반 RL은 사람이 큐레이션한 대규모 문제집을 전제로 합니다. 기존 zero-data 자가대전은 후보 문제를 던져보고 사후에 기각하는 방식으로만 학습 가능성을 걸러서, '난이도 축의 어디에 문제를 놓아야 하는지'는 끝내 학습하지 못했고 풀이자에게는 희소한 종단 보상만 줬습니다. LURE는 자가대전을 추격-도주 게임으로 재정의합니다. LLM 회피자(evader)가 환경의 난이도 축 위에 문제를 배치해 한 발 앞서려 하고, 계획-실행형 추격자(pursuer)가 검증 가능한 상호작용으로 이를 쫓습니다. 회피자는 풀이자가 롤아웃의 정확히 절반에서 자신을 잡을 때 최대가 되는 '포획 경계(capture-frontier)' 보상으로 학습되고, 추격자는 포획에 앵커된 조밀한 과정 크레딧을 받습니다. 검증 가능 추론 환경 3종과 백본 계열 3종에서 통합·전문화 설정 모두 기존 강력 베이스라인을 상회했고, 통합 모델은 3개 과제군에서 뽑은 9개 홀드아웃 벤치마크의 OOD 제로샷 정확도 총합에서 학습된 모든 베이스라인을 앞섰습니다(초록에 정량 개선폭은 없습니다).