ai model📚 커리큘럼 학습#36 · 2026. 10. 16.
정답 궤적 끝부분부터 이어받아 배우는 에이전트 RL, 서울대 커리큘럼
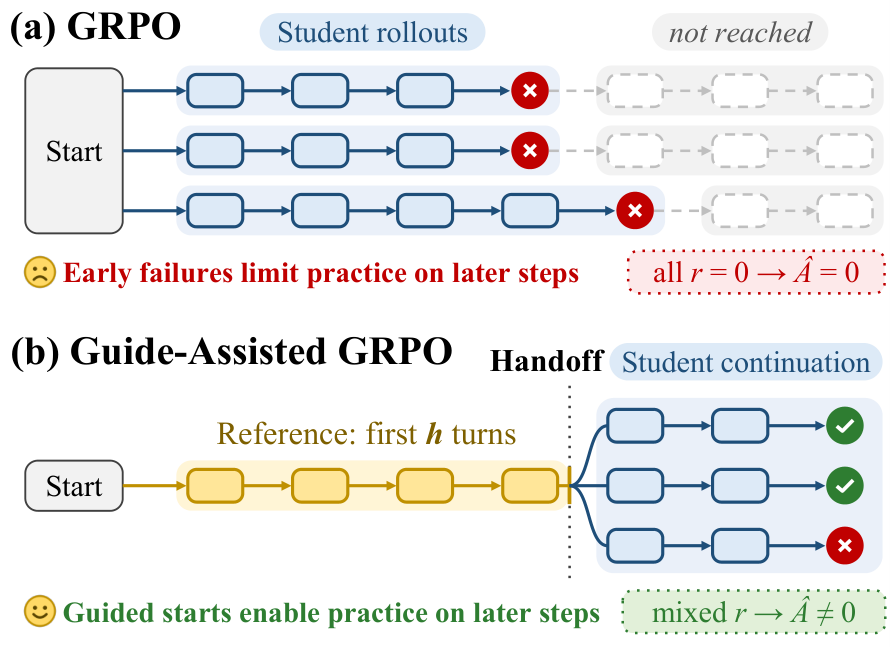
보상이 완주 시에만 나오는 장기 과제에서는 롤아웃이 전부 실패해 GRPO 학습 신호가 0이 되기 쉽습니다. 서울대·건국대 연구팀은 성공 궤적 앞부분을 재생해 주고 모델이 이어받는 Guide Assisted GRPO에서 시작 위치·인계 단위·이동 규칙을 체계적으로 비교했습니다. 과제 끝 근처에서 시작할 때 가장 좋아 BFCL 8B에서 59.0점으로 GRPO(52.0점)를 앞섰고, AppWorld도 43.1→47.2로 올랐습니다. 설정에 따라 GPU 시간도 약 21% 줄었습니다.