ai model🔁 자가교정#38 · 2026. 10. 20.
실패에서 뽑은 교훈으로 즉석 학습, 푸단대·상하이 AI Lab ReTTT
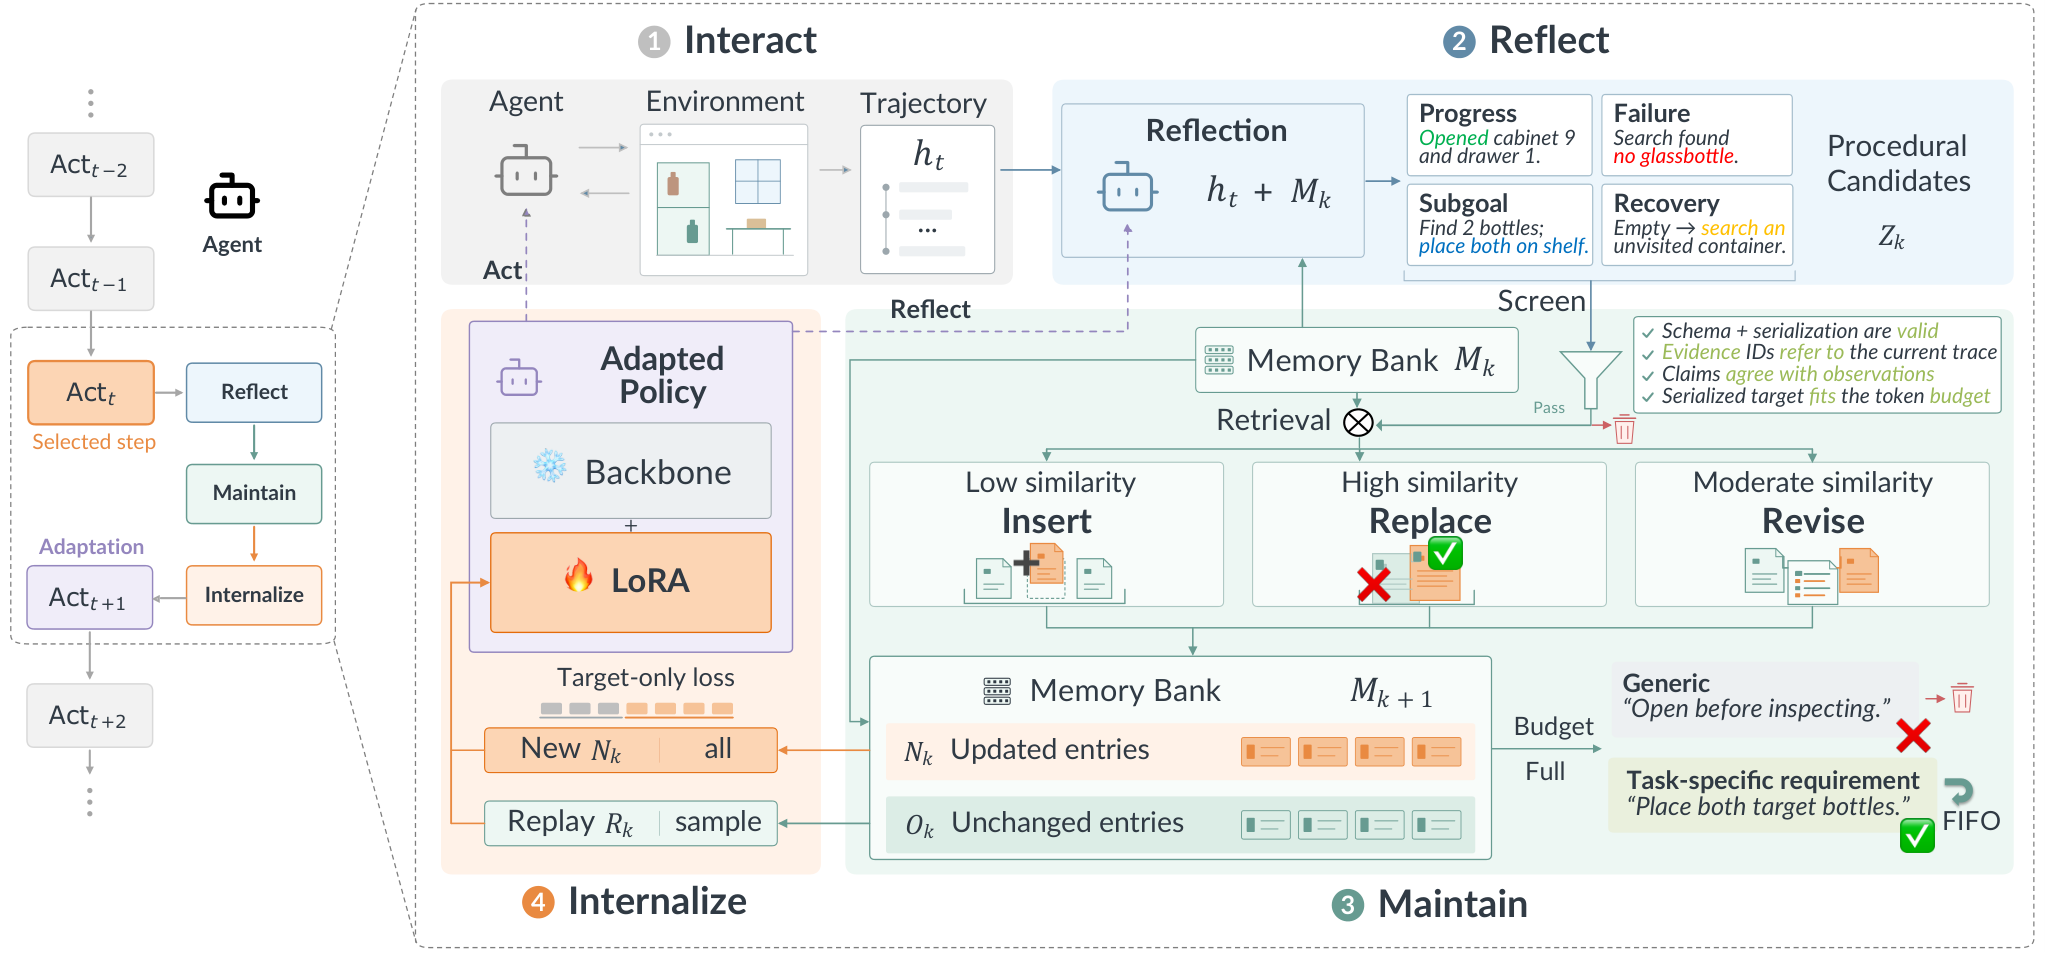
에이전트가 겪은 실패를 바로 다음 결정에 살리기는 어렵습니다. 푸단대·상하이 AI 연구소·홍콩중문대 연구팀의 ReTTT는 환경 피드백을 반성(reflection)해 교훈을 메모리에 쌓고, 그 교훈으로 작업 중 LoRA 어댑터를 즉석 학습합니다(백본 고정). 적응된 모델이 다시 행동하고 반성하는 폐루프입니다. ALFWorld·ScienceWorld·SWE-bench Lite 6개 설정 모두에서 기존 궤적 기반 테스트 타임 학습을 앞섰고, 성공률은 최대 12.14%포인트 올랐습니다.