본문으로 건너뛰기
← vibecamp ai model 목록

vibecamp ai model · #38 · 2026-10-20

vibecamp ai model 2026-10-20 — 고칠수록 잊는다, Mila 연구팀의 자기진화 에이전트 지속학습 점검

2026-10-20 AI 모델 일간 호 — 오늘 8개 카드를 정리했습니다.

8개 카드 · 적은 예제로 스스로 깨우치는 학습법 일간

📤 공유하기𝕏@inf💬✈B✉
🎯

퓨샷 학습

암호로 바꿔야 예시를 본다, IIT 봄베이 희귀어 용어 번역

#
프롬프트에 용어 예시를 넣어줘도 번역 모델이 그 예시를 따르지 않고 기존 지식에 기대는 경우가 많습니다. IIT 봄베이 연구팀의 RareCipherFT는 학습 때 같은 희귀 용어를 공유하는 예시를 붙이고, 그 용어를 문맥과 정답 양쪽에서 문자를 섞은 암호(cipher)로 바꿔 '예시에서 복사해야만' 맞히게 만듭니다. 영어와 타밀·아삼·네팔·하우사어 등 7개 방향, 1B~7B 모델 4종에서 용어 재현율이 5~15%포인트 올랐고 번역 품질(COMET)은 떨어지지 않았습니다.
💡사내 용어집이나 고객사 전문용어를 몇 개 예시로 넣어 반영시키려는 경우, 별도 사전 없이 학습 데이터 변형만으로 퓨샷 반영력을 높이는 방법으로 참고할 만합니다.
원문 →#few-shot#in-context-learning#machine-translation#low-resource
📚

커리큘럼 학습

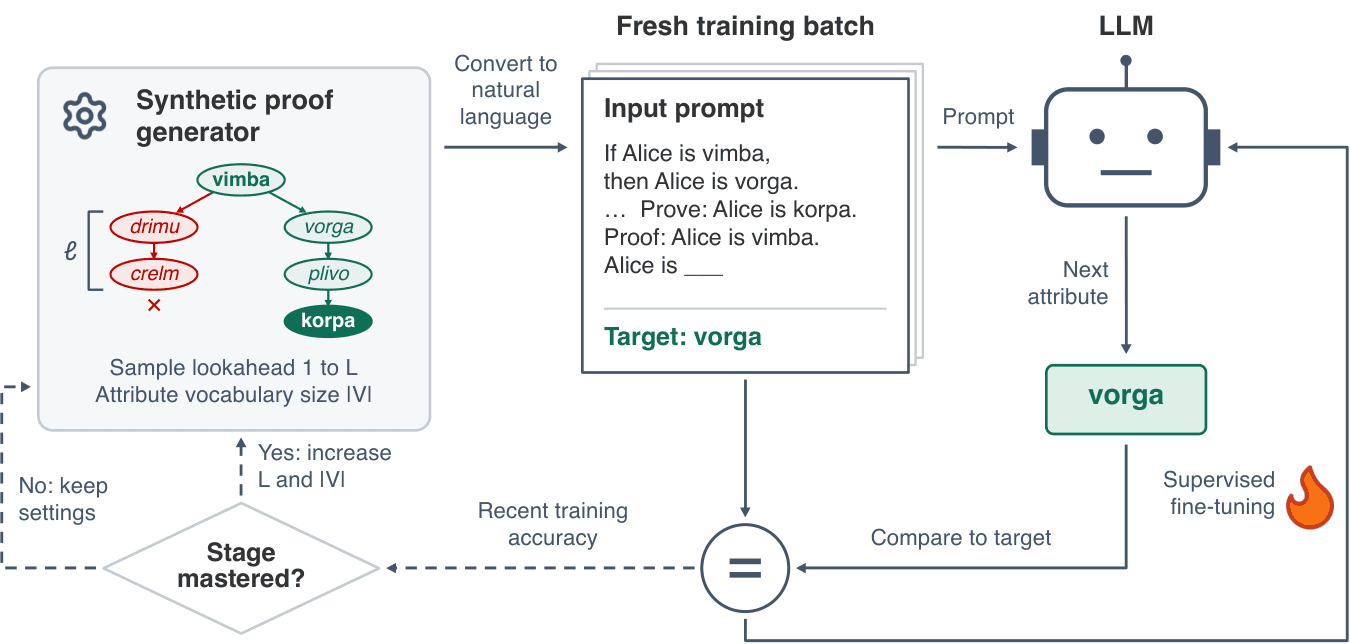
커리큘럼 학습 루프 — 합성 증명 생성기가 만든 추론 문제로 LLM을 미세조정하고, 단계 숙달 시 탐색 깊이와 속성 어휘를 늘리는 흐름

한 번에 256단계를 내다보다, 퍼듀대 커리큘럼 추론 학습

#
LLM은 생각의 사슬(CoT) 없이 한 번에 여러 단계를 내다보는 암묵적 추론(implicit reasoning)이 약합니다. 퍼듀대 연구팀은 어휘 크기와 내다봐야 할 단계 수(lookahead)를 조금씩 늘리는 커리큘럼으로 파인튜닝해, 같은 연산량에서 Qwen3-0.6B가 lookahead 256 문제를 98% 정확도로 풀게 했습니다(커리큘럼 없이 45%). 효과는 11개 자연어 추론 벤치마크로 전이됐지만 향상폭이 포화 곡선을 그려 모델마다 천장이 있고 단계를 너무 크게 올리면 학습이 멈췄습니다.
💡데이터 난이도를 어떤 보폭으로 올리느냐가 결과를 가른다는 점, 그리고 커리큘럼에도 한계가 있다는 점을 함께 보여줘 학습 설계 감각을 기르기 좋습니다.
원문 →#curriculum-learning#implicit-reasoning#fine-tuning#qwen3
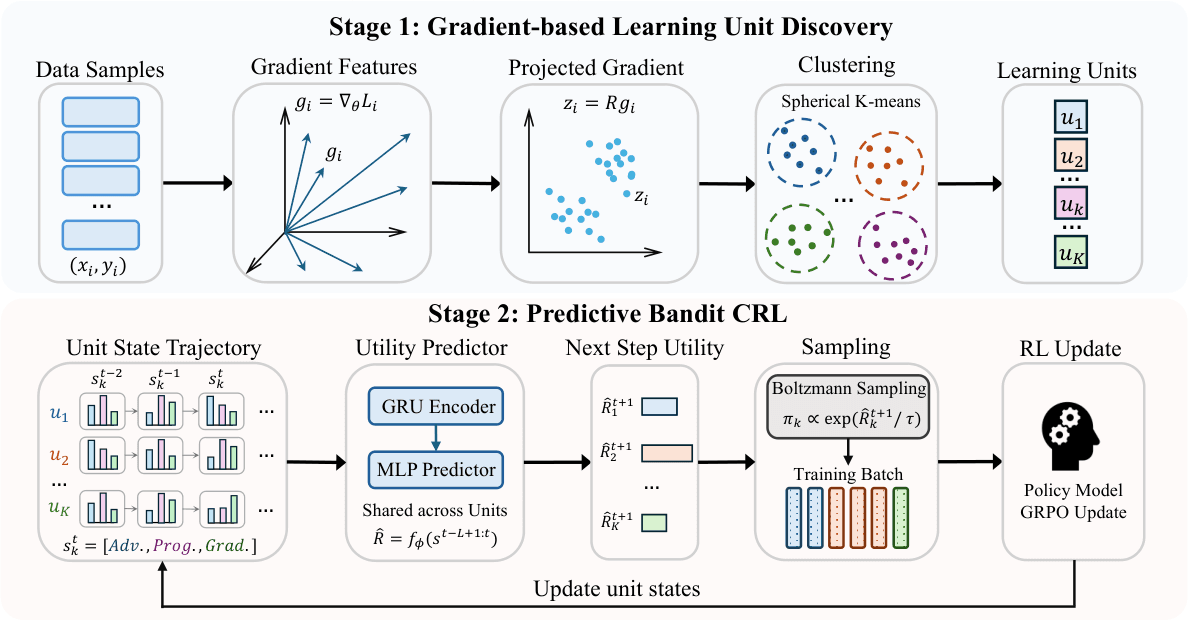
PGB 개요도 — 그래디언트 클러스터링으로 학습 단위를 찾고, 예측형 밴딧이 다음 효용을 추정해 GRPO 학습 배치를 샘플링하는 2단계 구조

난이도 대신 그래디언트로 묶다, 중국과학원·메이퇀 RL 커리큘럼

#
강화학습(RL) 커리큘럼은 보통 난이도 같은 정해진 속성으로 문제를 묶고 최근 성적만 보고 출제 비중을 정합니다. 중국과학원 계산기술연구소·메이퇀 연구팀의 PGB 커리큘럼은 샘플별 그래디언트를 군집화해 '학습 효과가 비슷한' 단위를 찾고, 경량 예측기로 각 단위의 미래 효용을 내다본 뒤 볼츠만 분포로 데이터를 배분합니다. Qwen3 수학 추론 RL에서 표준 GRPO 대비 상대 향상 기준 도메인 안 8.8~14.3%, 도메인 밖 14.7~16.3%를 기록했습니다.
💡GRPO로 추론 모델을 튜닝 중이라면, 어떤 문제를 언제 더 많이 보여줄지 정하는 출제 전략만으로도 성능 차이가 생긴다는 점을 확인할 수 있습니다.
원문 →#curriculum-learning#reinforcement-learning#grpo#data-selection
🪞

자가수정 학습

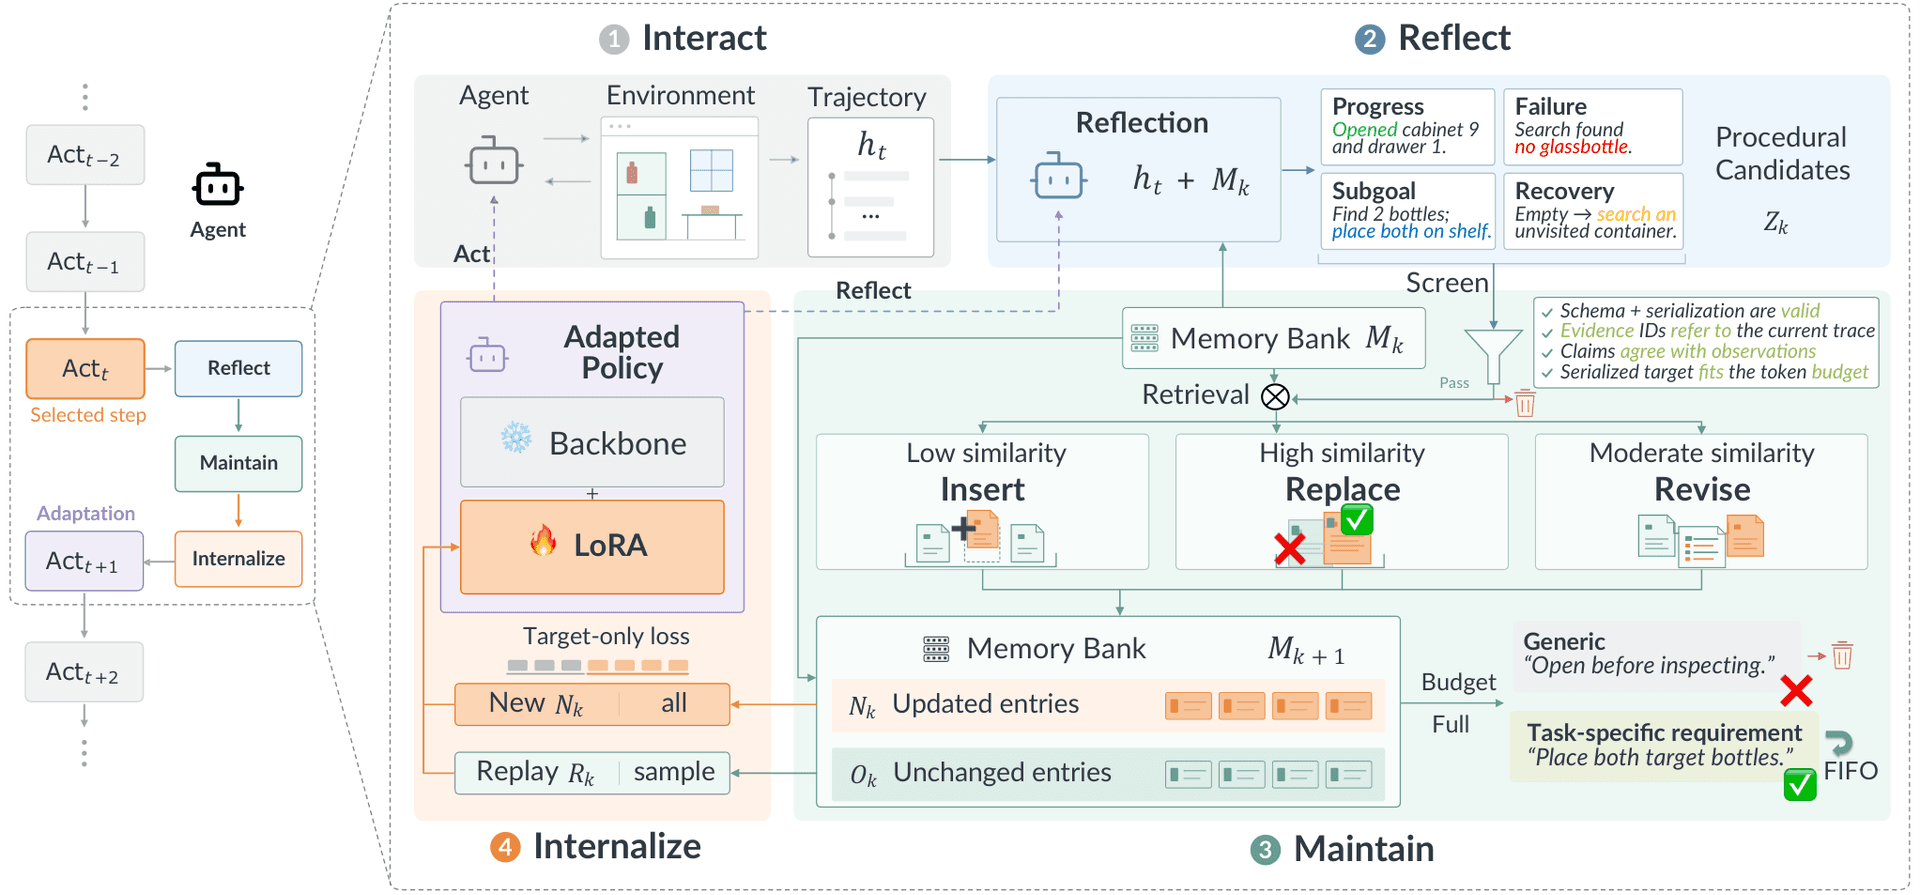
ReTTT 개요도 — 상호작용·성찰·메모리 유지·LoRA 내재화 4단계로 경험을 절차적 지식으로 바꿔 테스트 시점 학습하는 루프

실패에서 뽑은 교훈으로 즉석 학습, 푸단대·상하이 AI Lab ReTTT

#
에이전트가 겪은 실패를 바로 다음 결정에 살리기는 어렵습니다. 푸단대·상하이 AI 연구소·홍콩중문대 연구팀의 ReTTT는 환경 피드백을 반성(reflection)해 교훈을 메모리에 쌓고, 그 교훈으로 작업 중 LoRA 어댑터를 즉석 학습합니다(백본 고정). 적응된 모델이 다시 행동하고 반성하는 폐루프입니다. ALFWorld·ScienceWorld·SWE-bench Lite 6개 설정 모두에서 기존 궤적 기반 테스트 타임 학습을 앞섰고, 성공률은 최대 12.14%포인트 올랐습니다.
💡반성 내용을 프롬프트에만 남기지 않고 가벼운 LoRA 학습으로 연결하는 구조라, 자기수정 에이전트를 설계할 때 메모리와 학습의 경계를 다시 생각해볼 계기가 됩니다.
원문 →#self-correction#test-time-training#lora#llm-agent
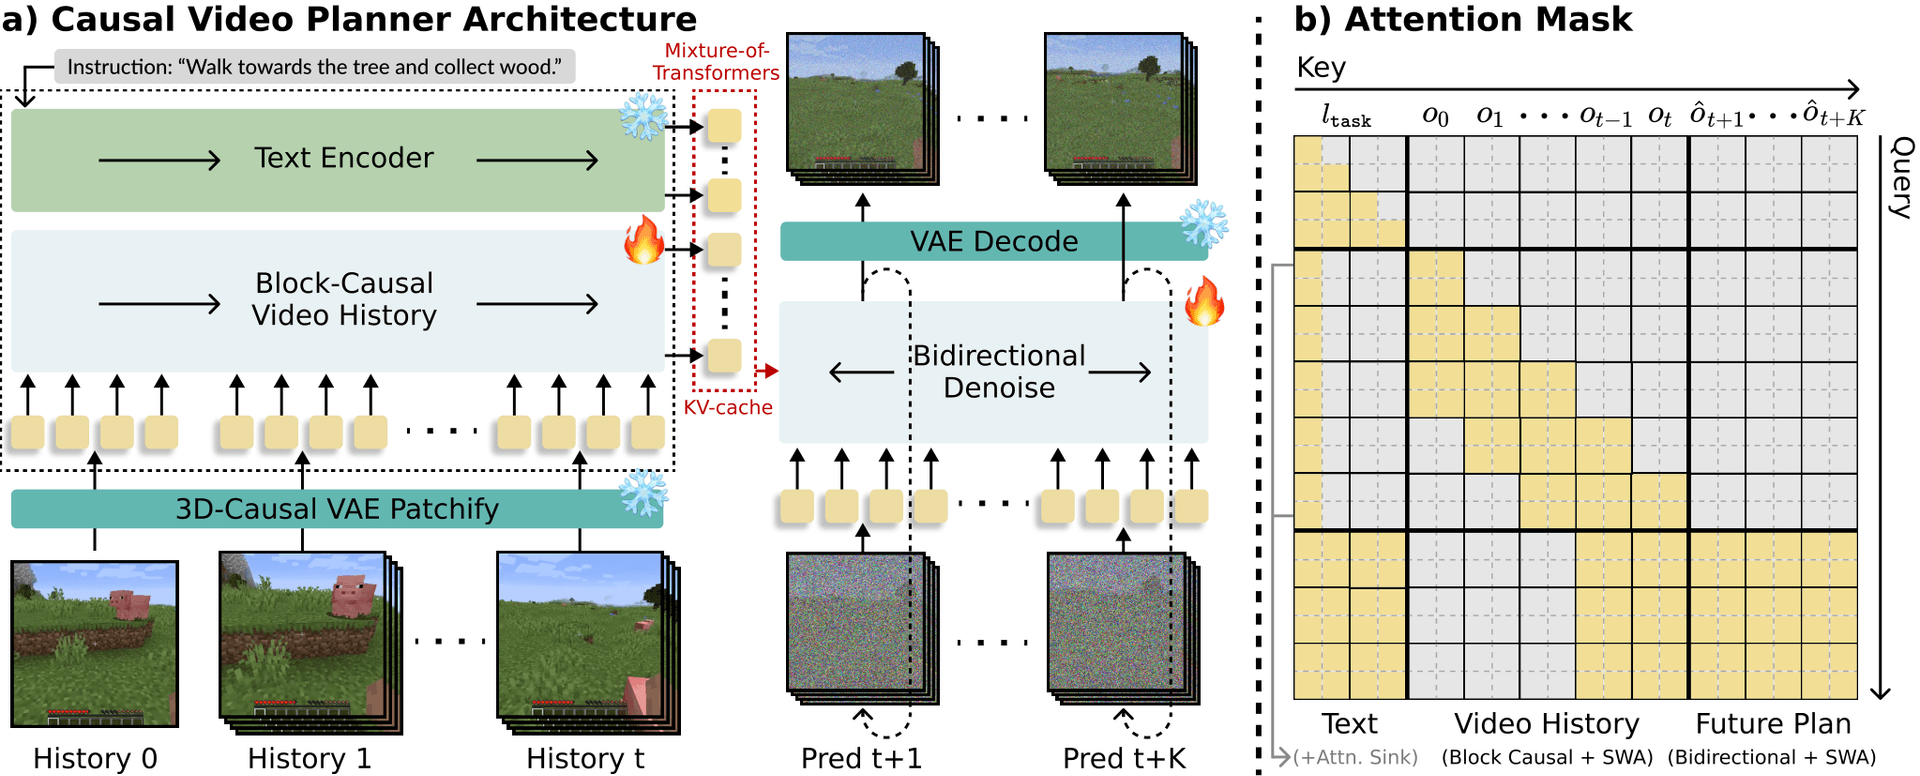
인과적 비디오 플래너 구조도 — 텍스트 지시와 과거 영상 프레임을 KV 캐시로 누적하고 양방향 디노이징으로 미래 프레임을 예측하는 아키텍처와 어텐션 마스크

라벨 없이 해보며 배운다, MIT CSAIL 영상-행동 자기개선 Mirror

#
영상 생성 모델이 그린 시각적 계획을 실제 행동으로 옮기려면 보통 사람이 모은 대규모 영상-행동 데이터가 필요합니다. MIT CSAIL 연구팀의 Mirror는 사전 행동 데이터나 수작업 보상 없이, 계획 영상을 따라 최선의 추측 행동을 해보고 그 결과로 생긴 영상-행동 쌍으로 다시 학습하며 스스로 나아집니다. Atari·OGBench·DeepMind Control에서 기존 관찰 학습법을 앞섰고, 마인크래프트에서는 보상·전문가 라벨 없이 자기개선만으로 철 곡괭이를 얻은 첫 방법이 됐습니다.
💡라벨을 모으는 대신 '직접 해보고 그 결과를 데이터로 쓰는' 루프가 어디까지 통하는지 보여줘, 데이터가 부족한 로봇·게임 프로젝트의 설계 힌트가 됩니다.
원문 →#self-improvement#video-to-action#embodied-ai#minecraft
🔄

지속학습

고칠수록 잊는다, Mila 연구팀의 자기진화 에이전트 지속학습 점검

#
가중치는 그대로 두고 프롬프트·메모리·스킬만 스스로 고쳐 쓰는 자기진화 에이전트(self-evolving agent)가 새 일을 배우면서 예전 일을 잊지 않는지 따져봤습니다. Mila 소속 Xiaoyin Chen 등 7인은 ReasoningBank·GEPA·Meta-Harness를 4개 변화형 태스크 스트림에 돌렸습니다. 전체 성능은 대체로 올랐지만, 공유 프롬프트를 통째로 고치는 방식은 이전 지식을 덮어썼고 유사도 기반 메모리 검색은 엉뚱한 기억을 끌어왔습니다.
💡에이전트에 '스스로 배우는' 메모리를 붙이려는 팀이라면, 새 태스크 성능만이 아니라 예전 태스크가 무너지지 않는지도 함께 회귀 테스트해야 한다는 점을 보여줍니다.
원문 →#continual-learning#self-evolving-agent#catastrophic-forgetting#agent-memory
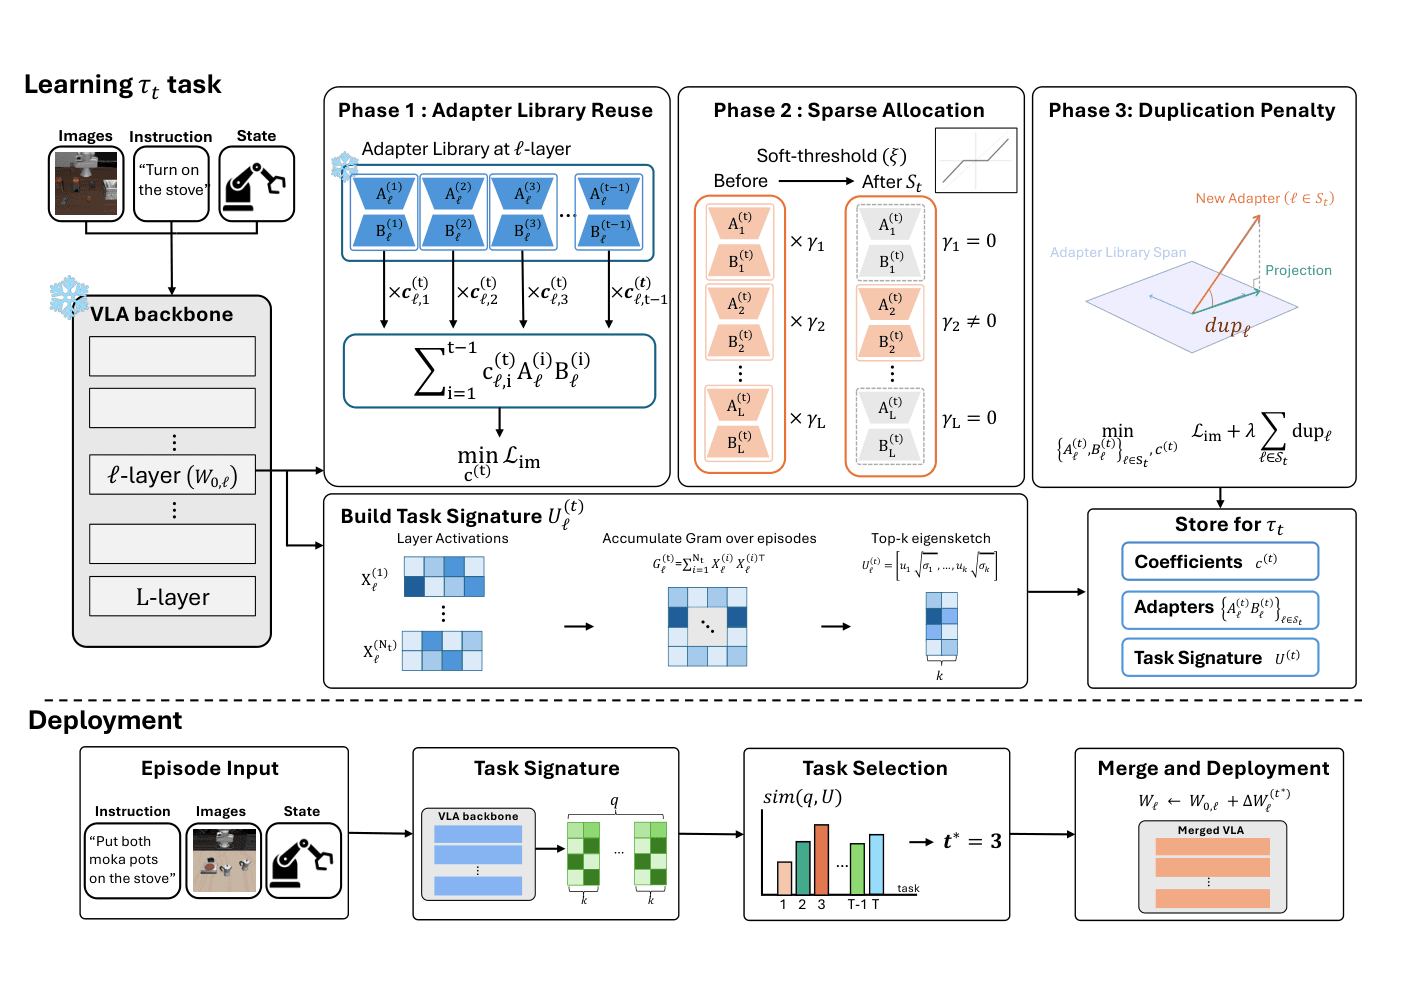
SARAM 개요도 — 어댑터 라이브러리 재사용, 희소 레이어 할당, 중복 페널티 3단계 학습과 태스크 시그니처 기반 선택·병합 배포 흐름

어댑터는 재사용하고 저장량은 4.5배 줄인, 서울대·아주대 SARAM

#
로봇이 새 작업을 배울 때마다 어댑터(adapter)를 추가하면 망각은 줄지만 온보드 저장공간이 계속 불어납니다. 서울대·아주대 공동연구팀(교신 장병탁)의 SARAM은 이전 태스크의 고정 어댑터를 재사용하고, 일부 레이어에만 희소하게 새 어댑터를 붙이며, 중복 페널티로 기존에 없는 정보만 담게 합니다. 배포 땐 태스크를 한 번 식별해 백본에 병합합니다. LIBERO 4개 스위트에서 기존 기법과 동등 이상이면서 태스크당 디스크 저장량을 최대 4.5배 줄였고, 실제 UR5 로봇팔에서도 검증했습니다.
💡LoRA 같은 어댑터를 태스크마다 쌓아온 팀이라면, '재사용·희소 추가·병합' 세 단계로 저장 비용을 관리하는 설계를 참고할 만합니다. 저장공간이 빠듯한 환경일수록 효과가 큽니다.
원문 →#continual-learning#robotics#vla#adapter
🧬

메타러닝

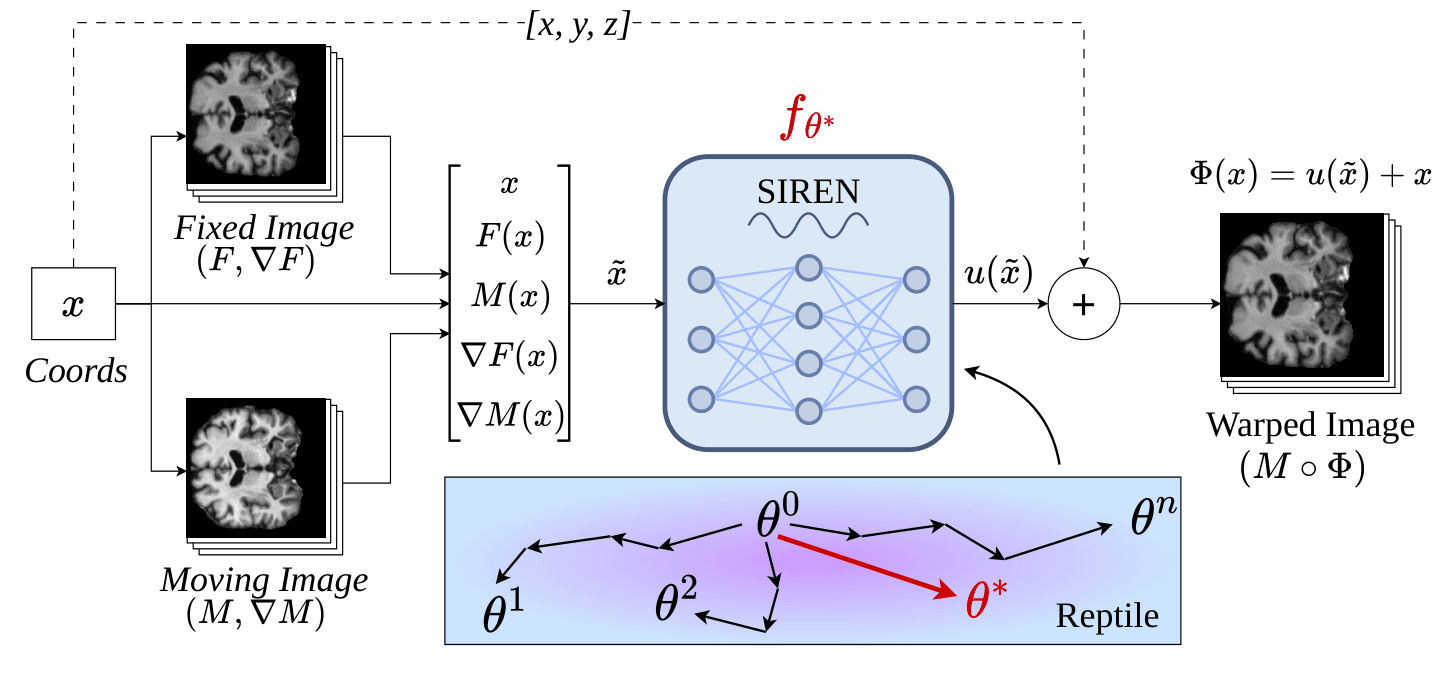
LUMINR 구조도 — 고정·이동 의료 영상의 좌표와 강도 특징을 SIREN 신경망에 입력해 변형장을 예측하고, Reptile 메타학습 초기값으로 정합을 가속하는 흐름

정합 속도 약 10배, 폴란드 AGH의 메타러닝 의료영상 정합

#
암묵적 신경 표현(INR) 기반 의료영상 정합(registration)은 영상 쌍마다 네트워크를 새로 최적화해야 해 느립니다. 폴란드 AGH 크라쿠프과기대·Sano 센터 연구팀의 LUMINR은 좌표에 국소 밝기·그래디언트 특징을 더해 입력하는 INR의 초기값을 메타러닝으로 학습해, 처음 보는 영상 쌍도 몇 번의 반복만으로 맞춥니다. OASIS 3D 뇌 MRI에서 처음부터 학습한 같은 모델과 동일한 정확도에 그래디언트 스텝과 실제 소요 시간을 각각 약 10분의 1로 줄였습니다.
💡'좋은 출발점을 미리 배워두면 새 문제는 몇 스텝이면 된다'는 메타러닝 초기화의 핵심을 의료영상이라는 구체적 사례로 익힐 수 있습니다. 반복 최적화가 병목인 다른 문제에도 응용할 만합니다.
원문 →#meta-learning#medical-imaging#implicit-neural-representation#registration

이 호가 도움됐다면 공유해 주세요 — 빌더 한 명이 더 알게 됩니다.

📤 공유하기𝕏@inf💬✈B✉