본문으로 건너뛰기
← vibecamp ai builder 목록

vibecamp ai builder · #90 · 2026-10-20

vibecamp ai builder 2026-10-20 — Inception Mercury 3, 초당 1,068토큰 확산 LLM 공

2026-10-20 AI 빌더 일간 호 — 오늘 11개 카드를 정리했습니다.

11개 카드 · AI Agent 를 만드는 사람의 일간

📤 공유하기𝕏@inf💬✈B✉
🛠

빌더 신호

Inception Labs 'Diffusion at scale — Introducing Mercury 3' 공식 발표 배너

Inception Mercury 3, 초당 1,068토큰 확산 LLM 공개

#
Inception이 10/19 확산(diffusion) 방식 LLM Mercury 3를 공개했습니다. Mercury 1보다 40배 이상 큰 모델로 NVIDIA GPU에서 초당 1,068토큰을 내고, 컨텍스트는 1M 토큰으로 늘었습니다. 회사는 자체 벤치마크에서 GPT-6 Luna·Claude Haiku 5.5보다 4~8배 빠르면서 품질은 앞선다고 주장합니다. 가격은 입력 $0.20·출력 $0.70 per 1M 토큰이며 출시 기념 50% 할인 중입니다.
💡음성 에이전트·실시간 튜터처럼 지연시간이 승부인 서비스라면 자기회귀(autoregressive) 모델 대신 확산 모델을 후보에 올려 직접 속도와 품질을 재 볼 만합니다.
원문 →#diffusion-llm#inference-speed#mercury#low-latency
OpenAI MultiLangBench GitHub 레포 대표 이미지

OpenAI, COBOL 등 저자원 언어 코딩 벤치마크 공개

#
OpenAI가 10/19 COBOL·Fortran 같은 저자원 언어(low-resource language) 코딩 평가를 공개했습니다. MultiLangBench는 SQLite 호환 DB 엔진을 20개 언어로 처음부터 만드는 과제로, 평균 통과율이 GPT-5.6 Sol 26.8% → GPT-6 Astra 87.4%였습니다. COBOL 마이그레이션 평가에서 GPT-6.1 Sol은 86.6~97.9%를 기록했고, 평가셋은 GitHub에 오픈소스로 풀렸습니다.
💡레거시 현대화나 언어 전환 프로젝트를 맡았다면 공개된 MultiLangBench로 쓰는 모델을 직접 돌려 보고 에이전트 투입 범위를 정하는 근거로 삼을 수 있습니다.
원문 →#benchmark#cobol#legacy-migration#openai
MiniMax M3.1 Flash 공식 발표 키비주얼

MiniMax M3.1 Flash 출시, 추론 3배 빠르고 70% 저렴

#
MiniMax가 10/19 M3.1 Flash를 정식 출시했습니다. 익명 모델 'Space Bunny'로 200조 토큰 넘게 실사용 검증을 거친 모델로, 추론은 약 3배 빨라지고 비용은 70% 줄었다고 밝혔습니다. DeepSWE 73.7%, OSWorld V2 61.7을 기록했고 가격은 입력 $0.15·출력 $0.60 per 1M 토큰입니다. 모델 가중치는 추후 공개 예정이라 아직 직접 내려받을 수는 없습니다.
💡코딩·컴퓨터 사용(Computer Use) 에이전트의 토큰 비용이 부담이라면 Vercel AI Gateway 무료 기간(10/22까지)에 기존 모델과 나란히 돌려 비교해 보세요.
원문 →#minimax#flash-model#agent-cost#computer-use
🏆

해커톤·대회

NEAR HACKATHON(11월 1~14일) 공식 X 아티클 커버 배너

NEAR 해커톤 $250K, 사전 등록 없이 레포만 내고 AI가 함께 심사

#
NEAR Protocol이 총상금 $250K 온라인 해커톤을 발표했습니다. 사전 등록 없이 11/1~14 사이 공개 레포와 X 데모 포스트만 올리면 됩니다. Agent Economy·AI Swarms·Autonomous Business 등 13개 트랙에서 돈을 다루는 에이전트를 만드는 것이 주제입니다. 참가 가이드는 코딩 에이전트용 HACKATHON.md로 제공되고, 사람 심사위원과 함께 Claude Code·Codex가 AI 심사위원으로 참여합니다 🏆
💡README에 'X를 하면 Y가 보인다'는 재현 경로를 쓰는 심사 기준은 어떤 데모에도 통하는 습관이고, 에이전트로 만들고 제출하는 흐름을 직접 겪어 볼 기회입니다.
원문 →#hackathon#near#agent-payments#ai-judge
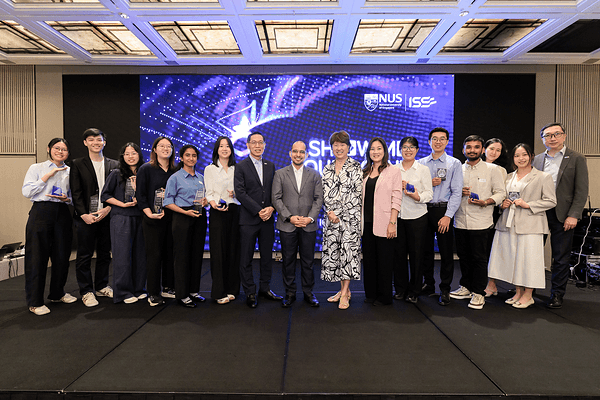
NUS-ISS·AWS 'Show Me Your Agents' 해커톤 시상식 수상자 단체 사진(보도자료 사진)

NUS-ISS·AWS 에이전트 해커톤, 114팀이 중소기업 실무 문제에 도전

#
싱가포르 NUS-ISS가 AWS와 연 'Show Me Your Agents' 해커톤 시상이 10/19 열렸습니다. 440명·114팀이 중소기업(SME)이 낸 실제 과제인 행정 자동화·고객응대·공급망 등을 AI 에이전트로 풀었고, 64팀이 최종 제출해 10팀이 결선에 올랐습니다. 1위는 SME 부문 Team Interns, 일반 부문 Questbond로 각각 US$3,000 AWS 크레딧을 받았습니다. 이미 끝난 대회의 결과 보도입니다.
💡배포·파일럿 가능성과 측정 가능한 비즈니스 효과를 심사하는 7개 기준은 내 에이전트 프로젝트를 '데모'가 아닌 '도입 가능한 제품'으로 점검하는 체크리스트로 쓸 만합니다.
원문 →#hackathon#sme#aws#agentic-ai
💰

매출·사례

AI 비서 스타트업 Town의 일러스트 브랜드 이미지(마을 풍경과 TOWN 로고)

Town, 직원별 AI 비서로 출시 4개월 만에 유니콘 등극

#
전 Plaid CTO가 공동창업한 Town이 $108M 시리즈B를 유치하며 유니콘(10억 달러 이상) 기업가치를 인정받았습니다. 6월 출시한 'Townie'는 직원마다 붙는 업무 AI 비서로, 이메일·캘린더·업무 시스템에 연결되고 동료의 문체와 회사 프로세스를 학습합니다. 회사는 출시 수주 만에 ARR 수백만 달러에 도달했다고 주장하지만, 정확한 매출·고객 수는 공개하지 않았습니다. 누적 투자액은 $160M입니다.
💡팀 단위가 아닌 '직원 1명당 에이전트 1개'로 과금 단위를 잡고 이미 쓰는 메일·캘린더에 붙여 도입 마찰을 줄인 설계가 이 성장 속도의 핵심 패턴입니다.
원문 →#unicorn#ai-assistant#per-seat-pricing#series-b
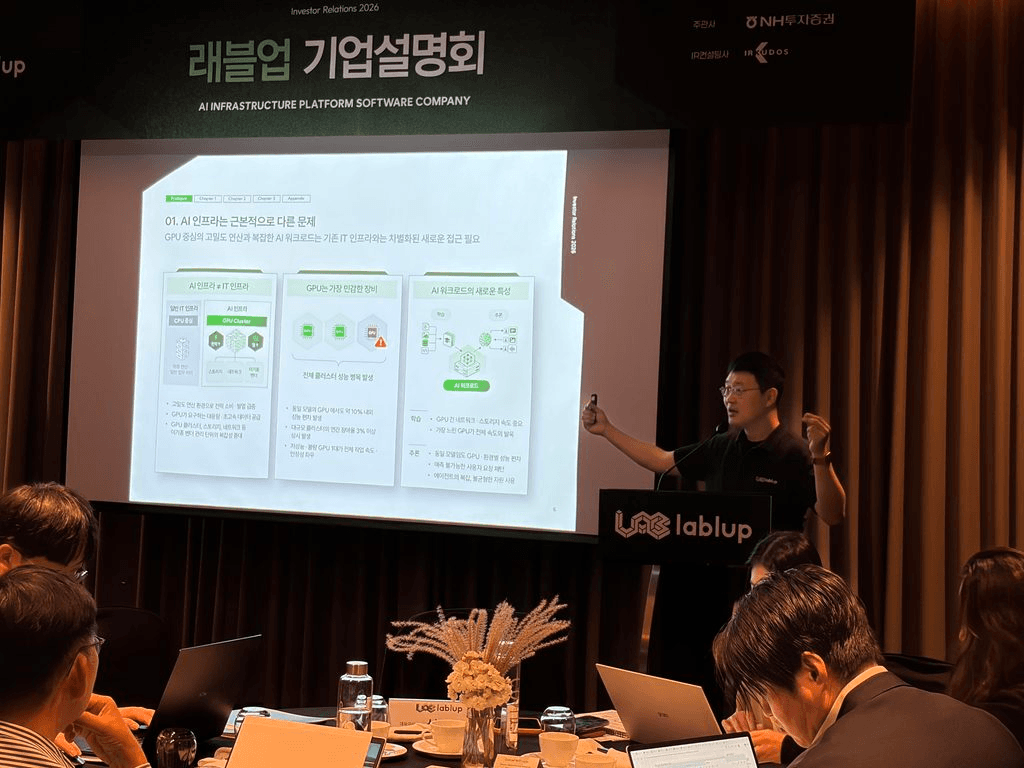
래블업 코스닥 상장 기업설명회 현장에서 AI 인프라 사업을 발표하는 모습

래블업 코스닥 IPO 설명회, 반복매출 94.7%의 GPU 인프라 SW

#
래블업이 10/19 코스닥 IPO 기업설명회를 열었습니다. 주력 Backend.AI는 GPU를 쪼개 여러 작업이 나눠 쓰게 하는 분할 가상화·오케스트레이션 플랫폼으로, 삼성전자·kt·신한은행 등 120개 이상 사이트가 씁니다. 연간 구독형 구조로 2025년 매출의 94.7%가 반복매출이고 순매출유지율(NRR)은 2년 평균 131.9%입니다. 회사는 일부 고객의 GPU 활용률이 30→85%로 올랐다고 설명합니다.
💡고객의 GPU 사용량이 늘수록 라이선스 매출도 커지는 '확장형 구독' 설계가 NRR 130%대를 만든다는 점, 오픈소스 기반 인프라 SW도 상장까지 갈 수 있다는 국내 사례입니다.
원문 →#ipo#gpu-infra#recurring-revenue#korea
🎙

빌더 인터뷰

20VC 에피소드 공식 아트워크 — LangChain 해리슨 체이스

LangChain 해리슨 체이스가 말하는 에이전트 계층의 승자와 비용

#
LangChain 공동창업자 Harrison Chase가 20VC에 출연해 62분간 에이전트 빌딩의 현실을 이야기했습니다. 에이전트 구축이 여전히 어려운 이유, 모델 랩이 에이전트 스택을 흡수할지, 모델 라우팅(model routing)이 사업이 될지 범용재가 될지를 다룹니다. AI 메모리가 아직 풀리지 않은 이유, 토큰 단가는 떨어지는데 AI 청구서는 왜 늘어나는지도 짚습니다. LangChain은 포춘500의 35%와 협업 중입니다.
💡모델이 흡수할 기능과 앱 계층에 남을 기능(메모리·평가·관측성)을 구분하고, 토큰 단가보다 작업당 총 토큰 소모량으로 비용을 보는 관점을 가져갈 수 있습니다.
원문 →#interview#langchain#agent-stack#model-routing
🦅

claw 생태계

akitaonrails/ai-memory GitHub 레포 대표 이미지

ai-memory v3.1, 코딩 에이전트 20여 종이 함께 쓰는 Rust 메모리

#
akitaonrails/ai-memory는 Claude Code·Codex 등 코딩 에이전트 CLI 20여 종이 공유하는 Rust 장기 메모리입니다. 원 발표는 v3.0.0이 10/14, v3.1.1이 10/17이며, clawfit에는 10/19에 L2 하네스로 등재됐습니다. 작업 중 Claude Code를 끄고 같은 폴더에서 Codex를 켜도 설계·실패한 시도·남은 질문을 다시 설명할 필요가 없습니다. 인계는 typed 핸드오프 프로토콜로 처리하며 ⭐11.5k, MIT입니다.
💡메모리를 특정 벤더 밖에 두면 에이전트 선택이 락인이 아니라 언제든 바꿀 수 있는 결정이 되고, 팀원 간 작업 인계에서도 맥락 손실을 크게 줄일 수 있습니다.
Laminar(lmnr-ai/lmnr) GitHub 레포 대표 이미지

Laminar flow-1, 소형 RL 모델로 에이전트의 '조용한 실패' 탐지

#
YC S24 스타트업 Laminar가 10/19 Launch HN에서 오픈소스 에이전트 관측성(observability) 플랫폼을 소개했습니다. 핵심인 트레이스 분석 모델 flow-1은 10/2에 처음 공개됐고, clawfit에는 10/19 L5 관측성으로 등재됐습니다. 모든 호출이 성공해도 엉뚱한 버튼을 누르는 '조용한 실패'를 RL로 학습한 소형 모델이 잡아냅니다. 회사는 GPT-6 Sol급 탐지 품질에 23배 저렴하다고 하지만 자체 벤치마크 결과입니다.
💡에러 로그가 남지 않는 실패는 로그 수집만으로 못 잡으므로, 에이전트 트레이스를 의미 단위로 판정하는 평가 계층을 따로 두는 설계를 고민해 볼 때입니다.

'루프 대신 하네스', 에이전트 기반 3단 프로덕션 모니터링 패턴

#
SRE 엔지니어 Ben Congdon이 10/19 블로그에 에이전트 모니터링 설계 패턴을 공개했고(HN 83점), clawfit에는 10/20 L2 하네스 패턴으로 등재됐습니다. 장애의 약 70%가 변경에서 온다는 근거로, 릴리스·설정 푸시 시점에 계획 에이전트 → 결정론적 러너 → 조사 에이전트 순으로 돌리고 필요하면 사람에게 넘깁니다. 무구조 에이전트 루프의 토큰 비용과 노이즈를 줄이려는 구조입니다. 개인 블로그라 수치는 참고용입니다.
💡비싼 'AI SRE' 제품 없이도 결정론적 실행과 트리거형 조사 에이전트를 나누면 작은 팀도 운영 모니터링을 직접 짤 수 있다는 실무 레퍼런스입니다.

이 호가 도움됐다면 공유해 주세요 — 빌더 한 명이 더 알게 됩니다.

📤 공유하기𝕏@inf💬✈B✉