ai model📚 커리큘럼 학습#38 · 2026. 10. 20.
난이도 대신 그래디언트로 묶다, 중국과학원·메이퇀 RL 커리큘럼
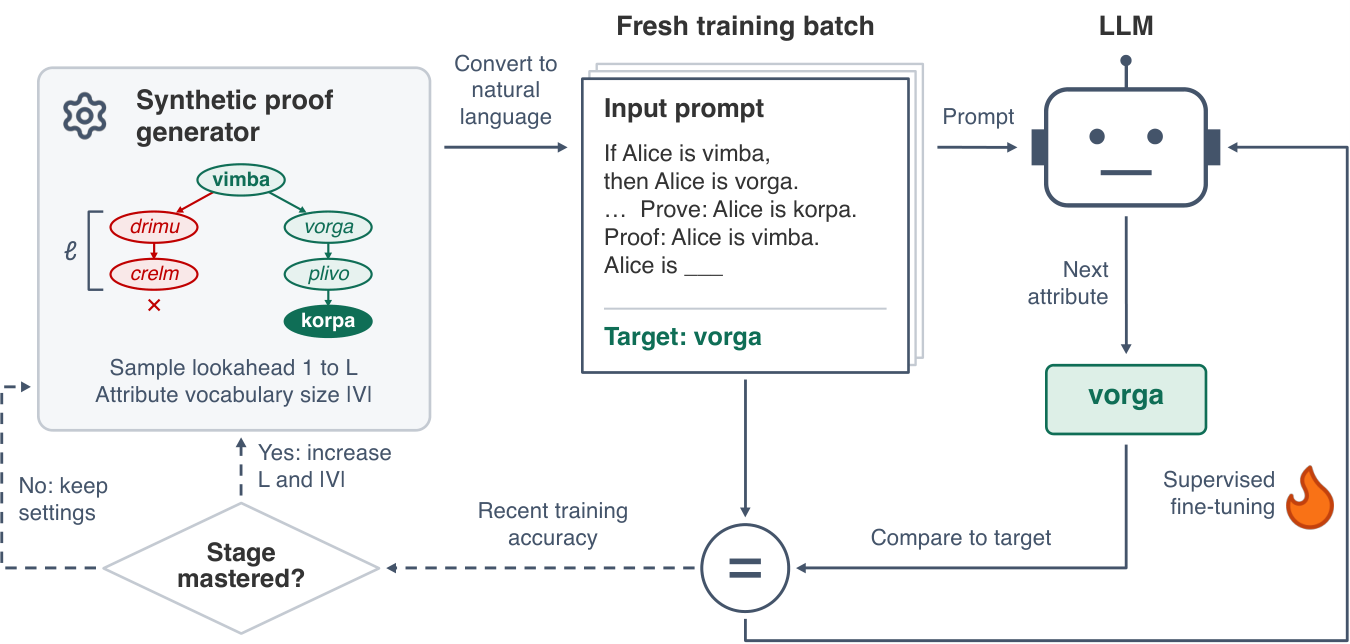
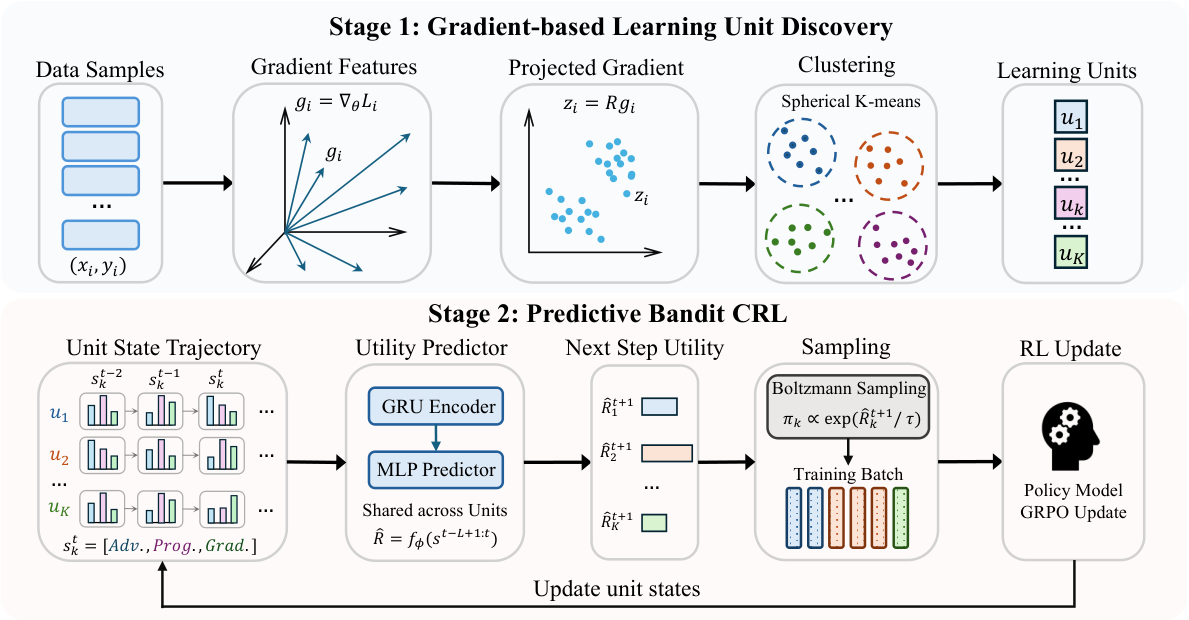
강화학습(RL) 커리큘럼은 보통 난이도 같은 정해진 속성으로 문제를 묶고 최근 성적만 보고 출제 비중을 정합니다. 중국과학원 계산기술연구소·메이퇀 연구팀의 PGB 커리큘럼은 샘플별 그래디언트를 군집화해 '학습 효과가 비슷한' 단위를 찾고, 경량 예측기로 각 단위의 미래 효용을 내다본 뒤 볼츠만 분포로 데이터를 배분합니다. Qwen3 수학 추론 RL에서 표준 GRPO 대비 상대 향상 기준 도메인 안 8.8~14.3%, 도메인 밖 14.7~16.3%를 기록했습니다.