ai model🔁 자가교정#39 · 2026. 10. 21.
맞은 답은 지키고 틀린 답은 더 세게, 고려대·중앙대 APSD
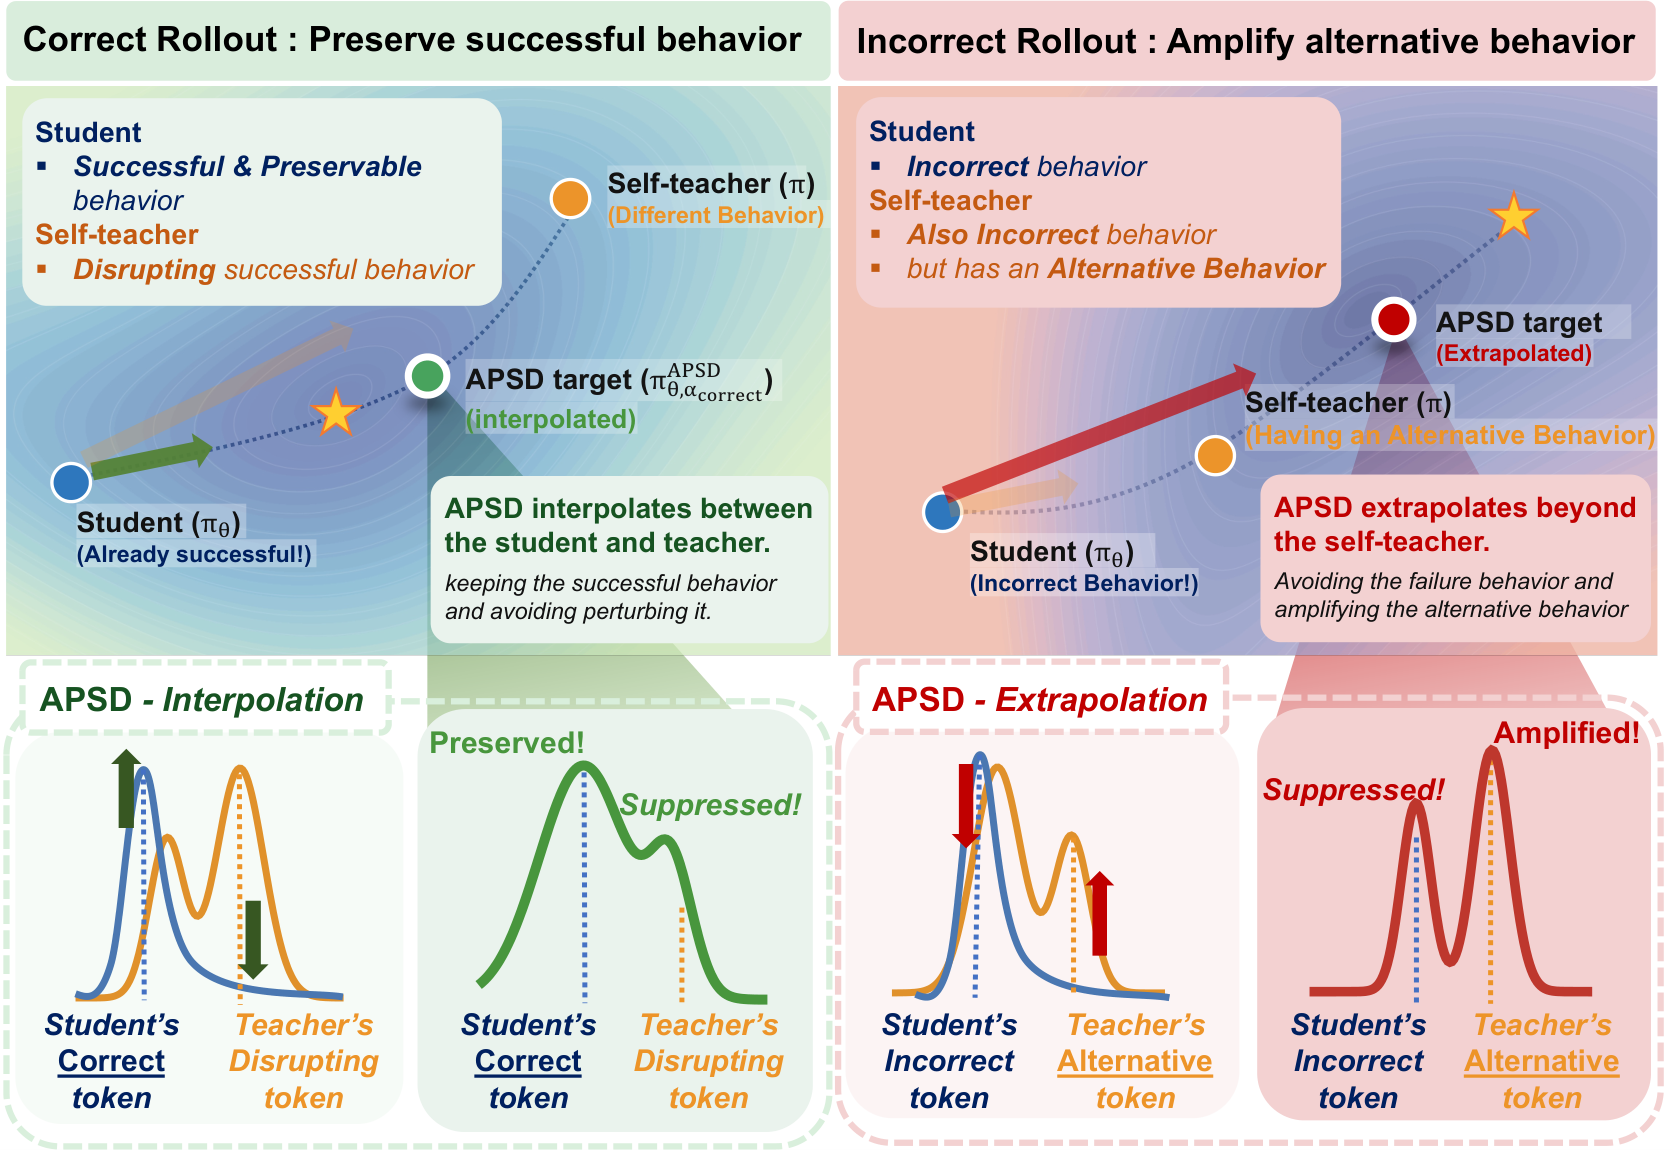
피드백을 본 모델 자신을 교사로 삼는 자기증류(self-distillation)는 그대로 따라 하면 맞은 풀이의 좋은 습관은 흐트러지고 틀린 풀이는 덜 고쳐집니다. 고려대·중앙대 연구팀(윤수완·정성룡·이창희)의 APSD는 정답 여부에 따라 목표 분포를 비대칭으로 만듭니다. 맞은 롤아웃은 학생과 자기교사 분포 사이로 보간해 보존하고, 틀린 롤아웃은 자기교사 너머로 외삽해 교정을 키웁니다. Qwen3 여러 규모에서 SDPO 성능을 평균 2.6배 적은 학습 스텝으로 달성했습니다.