결과가 섞일 문제만 골라 비용을 아낀다, 미시간대 RIDGE
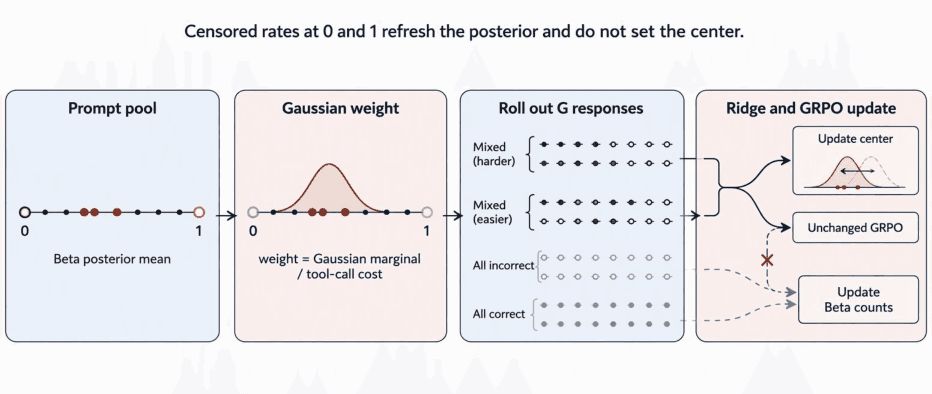
#GRPO는 한 문제의 응답 그룹이 전부 맞거나 전부 틀리면 학습 신호가 0인데, 웹 검색 에이전트는 그때 이미 검색 비용을 다 써버립니다. 미시간대·에든버러대 연구팀의 RIDGE는 문제마다 통과율을 Beta 사후분포로 추적하고, 결과가 섞인 그룹만으로 '맞힐 듯 말 듯한' 난이도 구간을 갱신하며, 예측 툴콜 비용이 큰 문제는 덜 뽑습니다. GRPO 대비 평균 정확도를 3.4pt·2.9pt 올리고, dynamic sampling 대비 롤아웃 29.6%·툴콜 32.7%를 줄였습니다.
💡어제 소개한 PGB가 그래디언트로 '무엇을 함께 배울지'를 묶었다면, RIDGE는 '얼마를 쓰고 배울지'까지 셈합니다. 툴 호출이 비싼 에이전트 RL이라면 출제 단계부터 비용을 넣어 볼 만합니다.