ai model🧬 메타학습#39 · 2026. 10. 21.
예시 흉내 대신 규칙부터 세운다, 칭화대 등 CoDI 메타 귀납
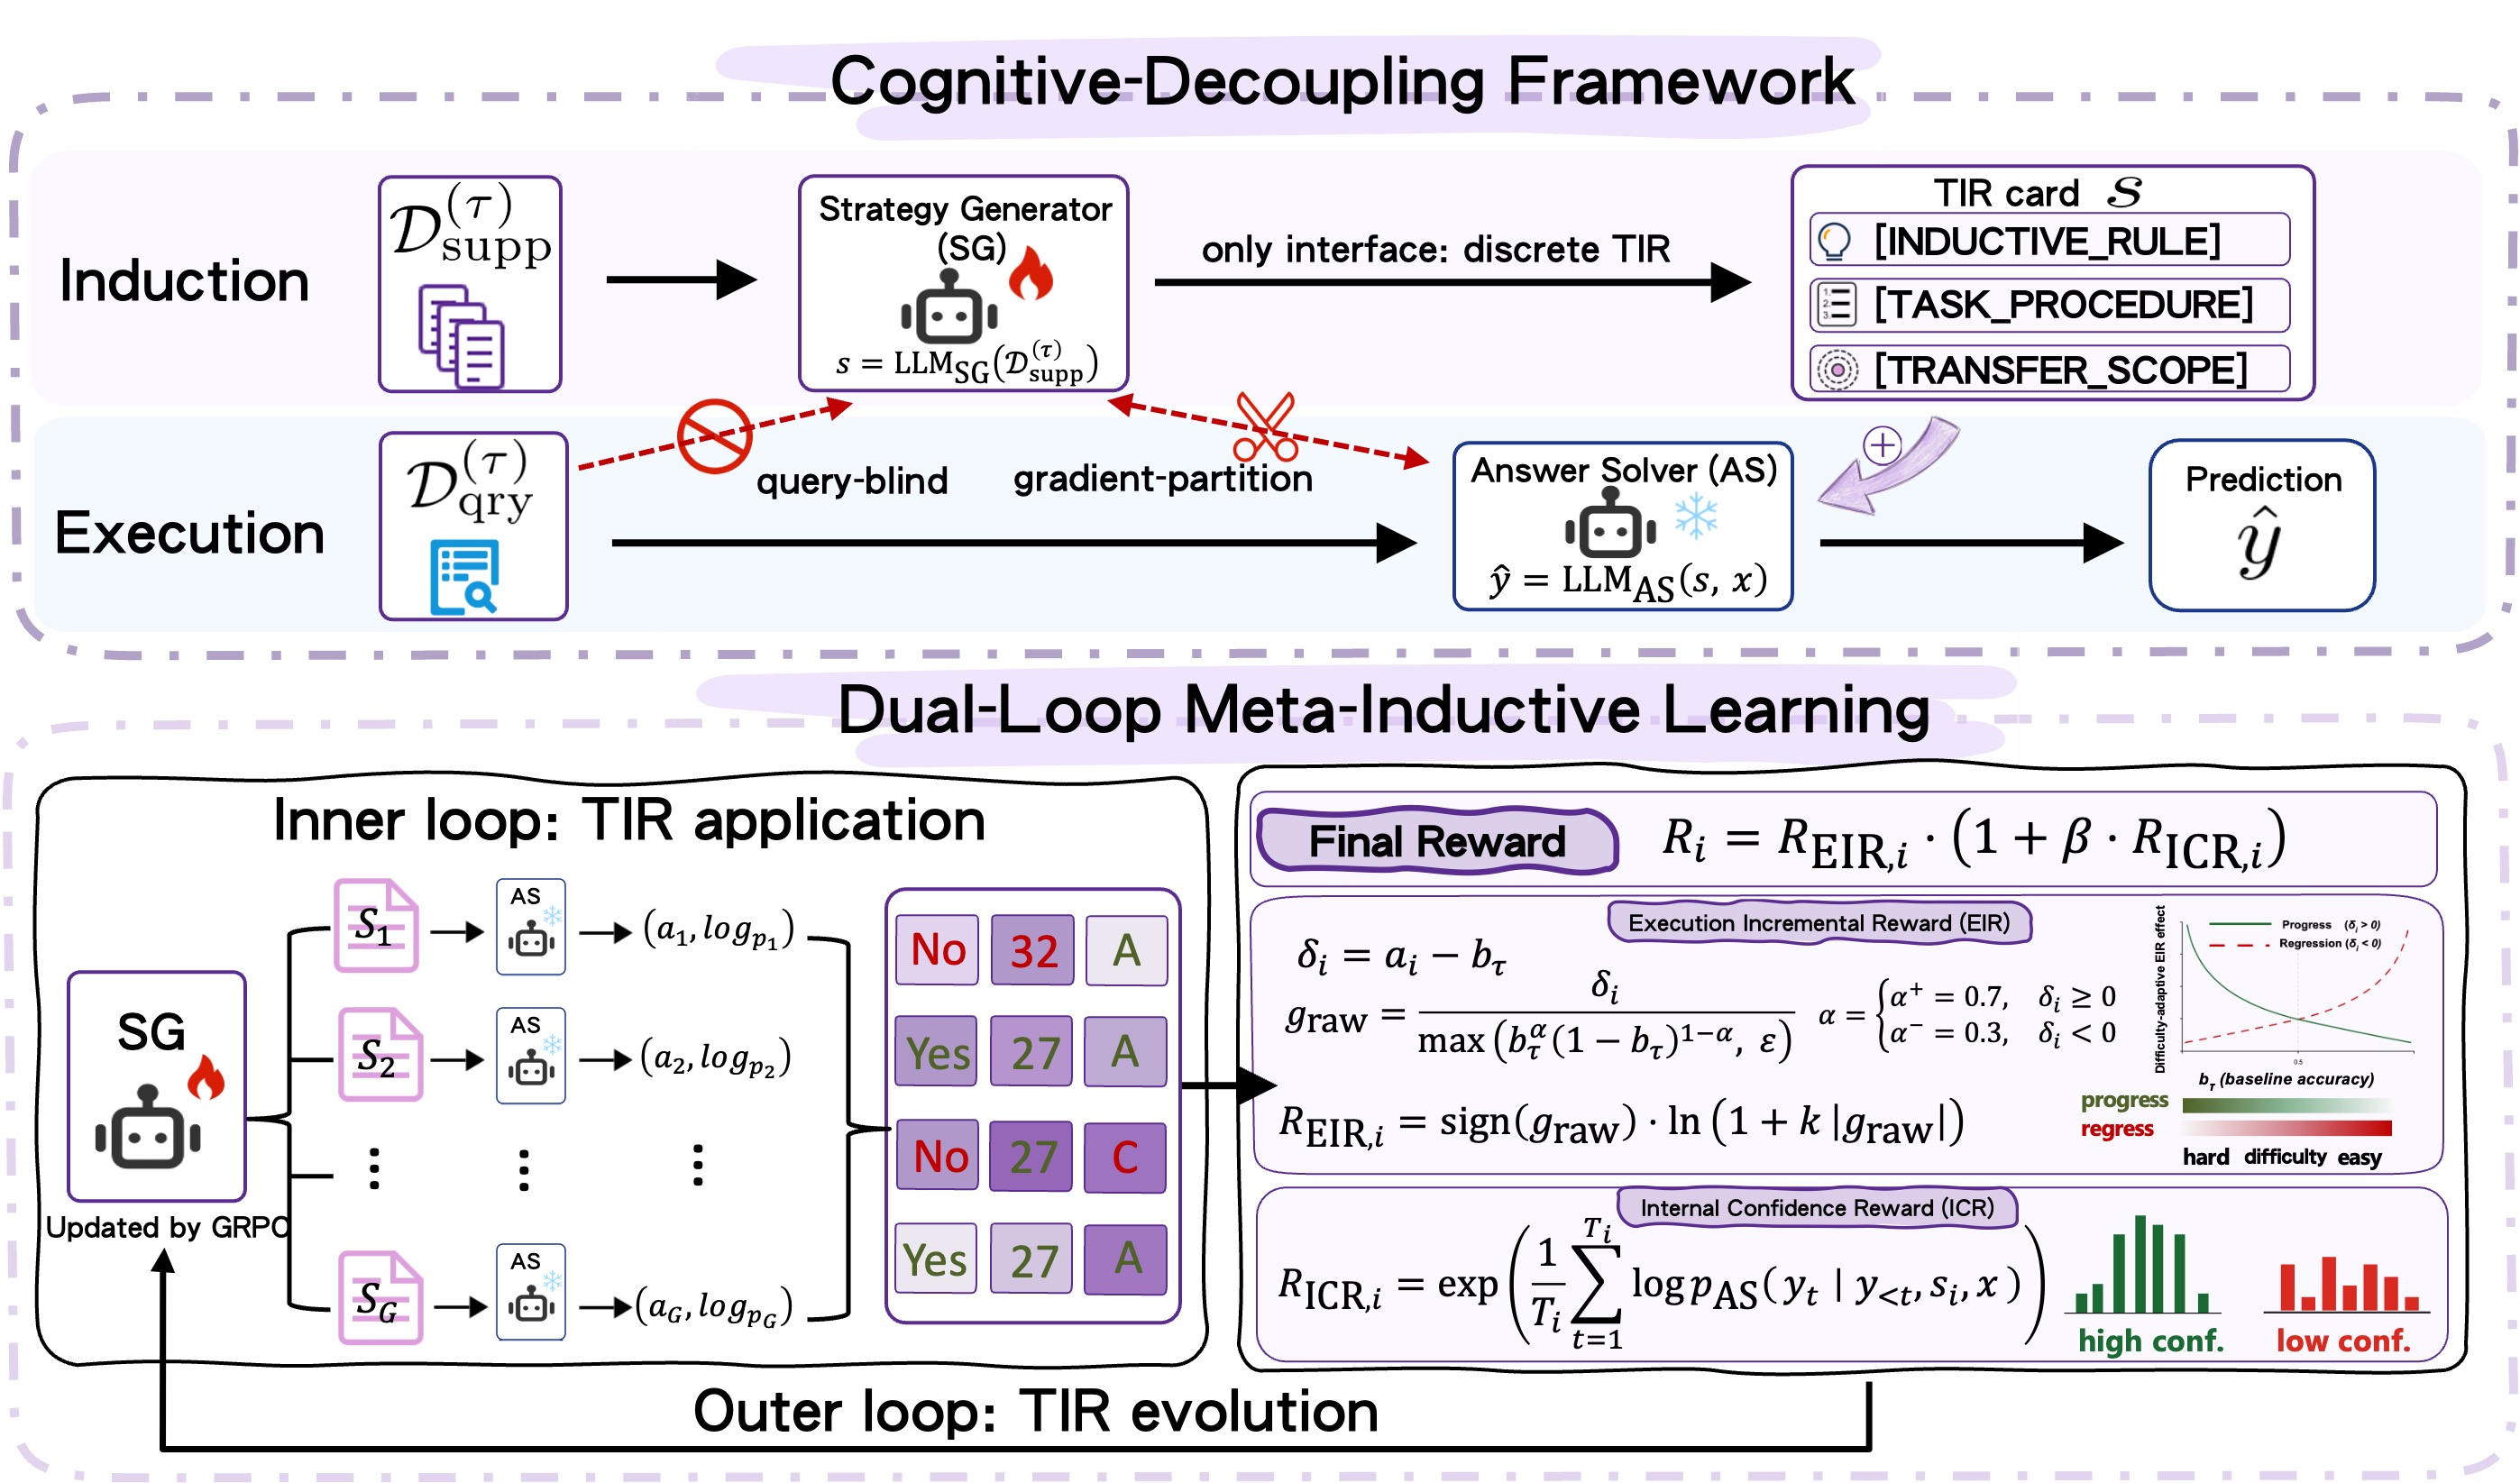
문맥 내 학습(ICL)은 질의와 비슷한 예시를 흉내 내는 데 기대 분포 밖(OOD) 문제에 약합니다. 칭화대 쑨마오쑹 교수팀과 베이징이공대 등 공동연구팀의 CoDI는 질의를 보지 않는 귀납기(inducer)가 예시에서 태스크 규칙을 먼저 뽑고, 실행기(executor)가 그 규칙을 적용합니다. 귀납기는 정답 규칙 라벨 없이 GRPO 기반 메타 강화학습 이중 루프로 훈련합니다. Qwen3-4B 기준 BIG-Bench에서 ICL 대비 분포 안 +120%, 분포 밖 +18%를 기록했습니다.