본문으로 건너뛰기
← vibecamp ai model 목록

vibecamp ai model · #40 · 2026-10-22

vibecamp ai model 2026-10-22 — 데이터가 빈 곳만 골라 묻는 강화학습, UNC·CMU 질의 배분

2026-10-22 AI 모델 일간 호 — 오늘 5개 카드를 정리했습니다.

5개 카드 · 적은 예제로 스스로 깨우치는 학습법 일간

📤 공유하기𝕏@inf💬✈B✉
🎯

퓨샷 학습

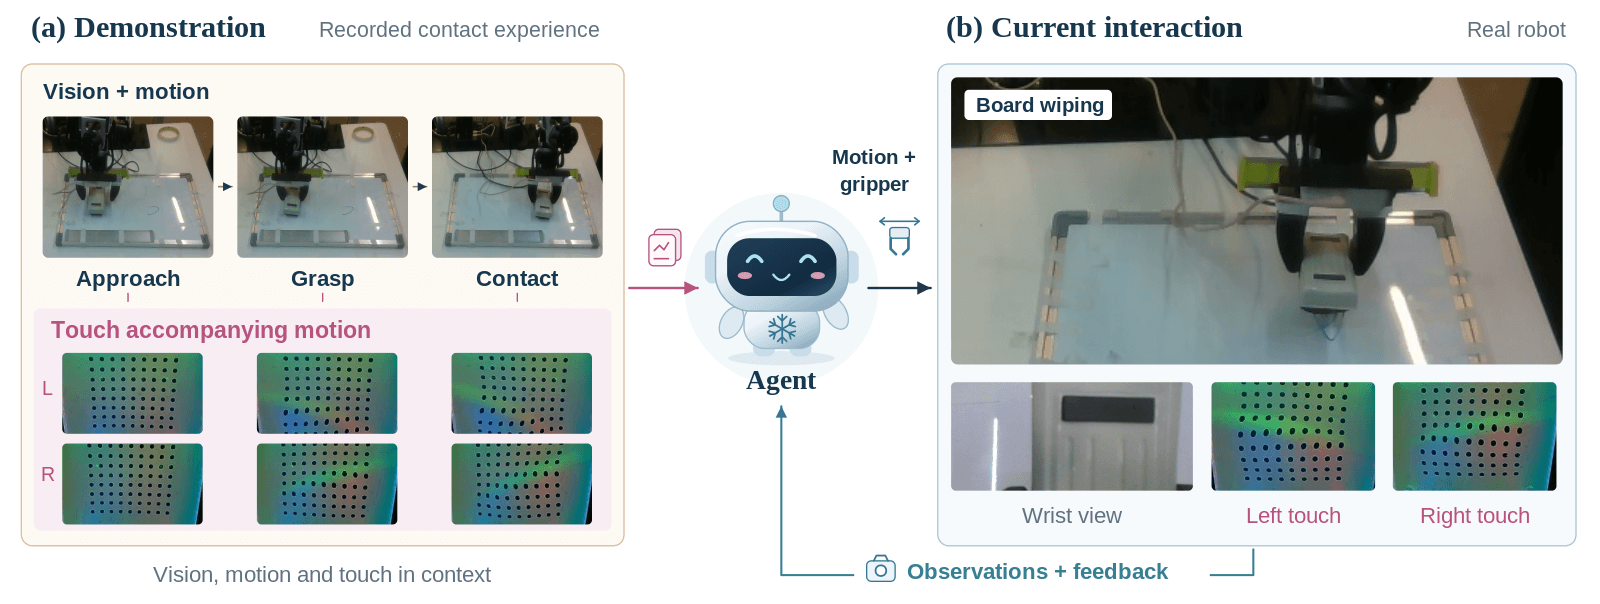
시연(시각·동작·촉각)을 맥락으로 받은 에이전트가 실제 로봇으로 보드 닦기 작업을 수행하는 촉각 인컨텍스트 학습 개요도

시연 2개와 촉각만으로 정밀 조작, 푸단대 Tactile-ETA

#
정밀한 로봇 조작에는 접촉 정보가 필요하지만, 과제마다 모델을 따로 학습하려면 데이터와 비용이 많이 듭니다. 푸단대·상하이혁신연구원·텐센트 등 연구팀의 Tactile-ETA는 전문가 시연의 동작마다 카메라 영상과 양측 촉각 관측을 짝지어 문맥에 넣고, 촉각 프레임은 시작·끝과 변화가 큰 지점만 남깁니다. 시연 2개만으로 파라미터 업데이트 없이 시뮬레이션 평균 성공률은 15.75→24.00%, 실로봇 과제는 0→60%로 올랐습니다.
💡퓨샷 문맥 내 학습(in-context learning)이 텍스트를 넘어 촉각 같은 물리 감각으로 넓어질 수 있다는 신호입니다. 어떤 프레임만 문맥에 남길지 고르는 요령은 멀티모달 프롬프트 설계에도 통합니다.
원문 →#few-shot#in-context-learning#robotics#tactile
이진 분류로만 사전학습해도 다중 분류가 된다, 바이룽 AI

이진 분류로만 사전학습해도 다중 분류가 된다, 바이룽 AI

#
표 형식 파운데이션 모델(TFM)은 합성 데이터로 사전학습해 한 번의 순전파로 제로샷 예측을 합니다. 베이징 바이룽(Bairong) AI 연구팀은 TabICLv2의 사전학습 클래스 수 상한을 10→2로 줄여 모든 과제를 이진 분류로 만들어도 K개 클래스 분류가 된다는 점을 보였습니다. TabArena 분류 38개 데이터셋에서 1590.1 Elo로 공식 기본값(1568.0)과 TabPFN-v2.6(1577.1)을 앞섰고, 실제 신용평가 기관 60곳 중 44곳에서 AUC가 올랐습니다.
💡모델이 문맥 속 클래스 예시와 비교해 답을 고르므로 레이블 공간은 문맥이 정합니다. 추론 비용 증가도 1.5%에 그쳐, 표 데이터 분류라면 사전학습 비용부터 다시 따져 볼 만합니다.
원문 →#few-shot#tabular#in-context-learning#foundation-model
🧪

액티브러닝

데이터가 빈 곳만 골라 묻는 강화학습, UNC·CMU 질의 배분

데이터가 빈 곳만 골라 묻는 강화학습, UNC·CMU 질의 배분

#
오프라인 강화학습(offline RL)은 가진 데이터 범위에 묶이고, 온라인 탐색은 비싸거나 위험합니다. UNC 채플힐·존스홉킨스대·CMU 연구팀은 고정 데이터에서 출발해 어떤 상태·시점을 협력자와 시뮬레이터에 물을지 학습자가 직접 고르는 질의 기반 협력 RL을 제안했습니다. 최적 정책 식별에 필요한 질의 수의 하한을 유도해 그대로 배분하며, 약 1만 회 질의로 멈췄습니다. 균등·커버리지 배분은 5~22배 많은 질의가 필요했습니다.
💡능동 학습(active learning)의 '무엇을 물을지'를 RL 데이터 수집에 옮긴 사례입니다. 시뮬레이션 호출이 비싼 프로젝트라면 판정이 어려운 구간에 예산을 몰아주는 설계를 참고해 보세요.
원문 →#active-learning#offline-rl#query-allocation#sample-efficiency
🔄

지속학습

SGD 대신 지속학습 전용 옵티마이저를, 휴스턴대 SPIN

SGD 대신 지속학습 전용 옵티마이저를, 휴스턴대 SPIN

#
데이터 스트림을 한 번만 보고 배우는 온라인 지속학습(OCL)은 망각에 약한데도, 옵티마이저는 SGD·AdamW 같은 범용 기법을 그대로 써 왔습니다. 휴스턴대 연구팀의 SPIN은 새 데이터를 빠르게 흡수하는 가소성(plasticity) 시퀀스와 닻 역할의 안정성(stability) 시퀀스를 보간해 업데이트합니다. 기존 방법의 옵티마이저만 바꾸면 되고, 11개 SOTA OCL 방법 전반에서 성능이 올랐습니다. ER 기준 Split CIFAR-100 정확도는 27.94→33.31%였습니다.
💡망각 대책을 리플레이나 정규화가 아닌 옵티마이저 층에서 푼 접근입니다. 그래디언트 평가도 1회뿐이라, 지금 돌리는 지속학습 실험에 드롭인(drop-in)으로 바꿔 비교해 보기 좋습니다.
원문 →#continual-learning#optimizer#stability-plasticity#online-learning
새 개념을 배워도 옛 개념은 그대로, ETH 취리히 DyRA

새 개념을 배워도 옛 개념은 그대로, ETH 취리히 DyRA

#
텍스트-이미지 개인화는 참조 이미지 몇 장으로 고유 개념을 확산 모델에 가르치지만, 개념을 따로 배우거나 한꺼번에 주어진다고 가정합니다. ETH 취리히 Thomas Hofmann 그룹의 DyRA는 개념이 하나씩 도착하는 상황을 겨냥해 이전 개념과 간섭하지 않는 잔차 공간(residual space)에서만 업데이트합니다. 경쟁 방법 중 최고 개념 충실도에 망각은 거의 0이었고, 핵심 레이어만 적응시켜 학습 파라미터를 최대 72% 줄였습니다. 다만 SD v1.5·Concept101에서만 검증됐습니다.
💡캐릭터나 스타일을 계속 추가하는 생성 서비스라면 다음 개념이 앞 개념을 덮는 문제를 겪게 됩니다. 어느 레이어만 학습할지 고르는 아이디어는 학습 비용 절감에도 바로 쓸 수 있습니다.
원문 →#continual-learning#diffusion#personalization#parameter-efficient

이 호가 도움됐다면 공유해 주세요 — 빌더 한 명이 더 알게 됩니다.

📤 공유하기𝕏@inf💬✈B✉
vibecamp ai model 2026-10-22 — 데이터가 빈 곳만 골라 묻는 강화학습, UNC·CMU 질의 배분 | vibecamp ai model