본문으로 건너뛰기
← vibecamp ai model 목록

vibecamp ai model · #37 · 2026-10-17

vibecamp ai model 2026-10-17 — 질문 수는 줄이고 빠진 보상만 묻는다, MIT 표적형 선호 학습

2026-10-17 AI 모델 일간 호 — 오늘 8개 카드를 정리했습니다.

8개 카드 · 적은 예제로 스스로 깨우치는 학습법 일간

📤 공유하기𝕏@inf💬✈B✉
🎯

퓨샷 학습

예시 하나로 여러 곳을 동시에 고친다, 확산 LM 다중 타깃 퓨샷

#
포맷 변경이나 API 마이그레이션처럼 예시 하나를 여러 곳에 적용하는 편집은 좌우 문맥이 모두 필요해, 왼쪽부터 생성하는 자기회귀 모델에는 어색합니다. UT 오스틴 연구팀은 확산 언어모델(diffusion LM)로 여러 마스킹 구간을 예시에 맞춰 동시에 채우는 다중 타깃 퓨샷 프롬프팅(few-shot prompting)을 제안했습니다. 예시를 따르는 채움에 가점을 주는 가이던스를 더해, 퓨샷 벤치마크와 리팩터링 사례에서 채움 정확도를 높였습니다.
💡코드 일괄 리팩터링이나 문서 일괄 수정 도구를 만든다면, 규칙을 길게 쓰는 대신 예시 몇 개로 가르치는 방식을 확산 LM으로 시험해볼 근거가 됩니다.
원문 →#few-shot#diffusion-lm#prompting#refactoring
📚

커리큘럼 학습

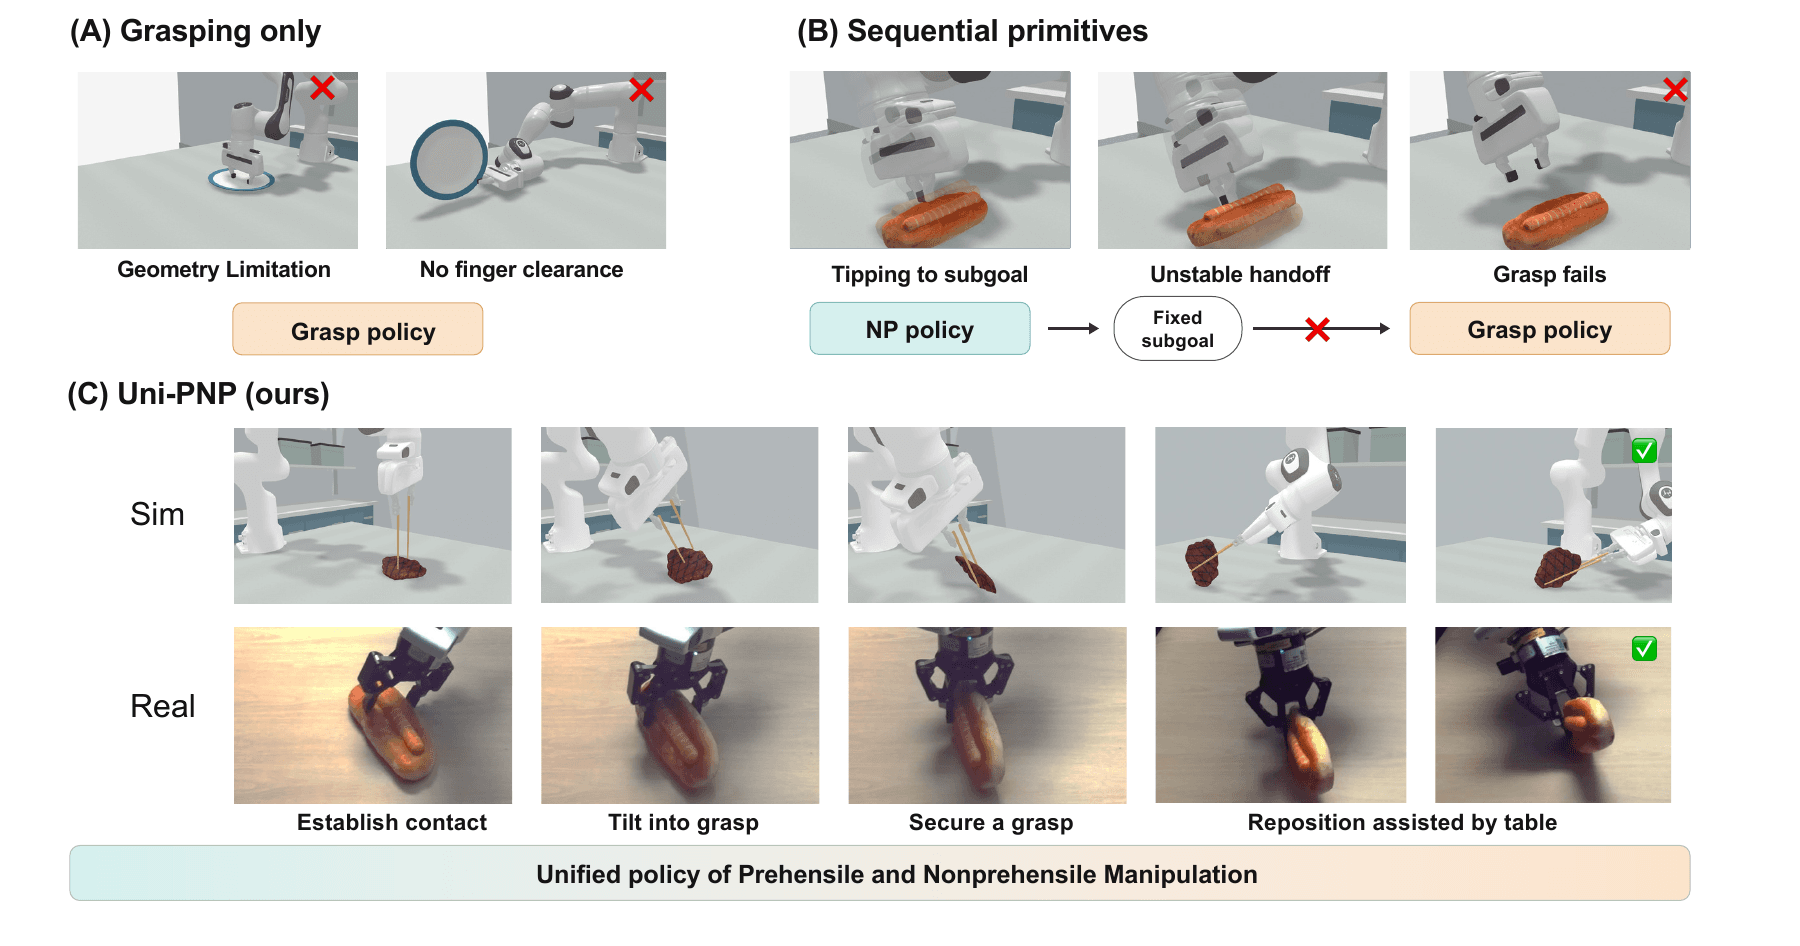
Uni-PNP 프로젝트 티저 그림 — 파지만 쓰는 정책·순차 프리미티브의 실패 사례와, 시뮬레이션·실제 로봇 팔이 물체를 밀고 기울여 집는 통합 조작 정책 과정

잡히는 물체부터 못 잡는 물체로, 북경대 2단계 RL 커리큘럼 조작

#
로봇의 잡기(prehensile)와 밀기·넘기기 등 비파지(non-prehensile) 동작은 보통 따로 만들어 이어붙여 협응이 부족했습니다. 북경대·Galbot 연구팀의 Uni-PNP는 접촉에 따른 물체 움직임을 예측하는 기하 인코더 위에서, 잡을 수 있는 물체→잡을 수 없는 물체 순서의 2단계 강화학습 커리큘럼(curriculum)으로 하나의 정책을 학습합니다. 학습 물체 성공률 76.39%, 처음 보는 물체 57.91%로 최강 기준선보다 각각 20.52%포인트, 17.79%포인트 높았습니다.
💡쉬운 과제로 기본기를 익힌 뒤 어려운 과제로 넘어가자 넘어뜨린 뒤 잡기 같은 행동이 스스로 나타났다는 점에서, 과제 순서 설계의 효과를 보여줍니다.
원문 →#curriculum-learning#robotics#manipulation#reinforcement-learning
🪞

자가수정 학습

정답 없이 자기 풀이끼리 비교해 배운다, 상하이교통대 SRD 자기증류

#
정답 라벨·검증기·교사 모델이 없으면 모델이 만든 풀이가 맞는지 알 수 없어 자기개선이 막힙니다. 상하이교통대 연구팀의 SRD(Shared Residual Distillation)는 같은 문제에 대한 미검증 풀이 여러 개가 예측 분포를 바꾸는 방향 중, 서로 일치하고 크기가 보수적인 조정만 학습 신호로 씁니다. AIME24~26 avg@12 기준 Qwen3-4B는 19.07→45.46, Qwen3-8B는 21.39→54.44로 올랐고, 일반 능력 벤치마크 저하는 없었습니다.
💡틀린 풀이에도 쓸모 있는 중간 추론이 섞여 있다는 관점으로, 정답 데이터가 부족한 도메인에서 자기증류(self-distillation)를 시도할 실마리가 됩니다.
원문 →#self-correction#self-distillation#reasoning#qwen

틀린 다수결로도 학습이 되는 이유, 그래디언트 분해로 밝힌 연구

#
모델이 뽑은 여러 답의 다수결을 보상으로 쓰는 자기라벨 강화학습은 정답 정보를 더하지 않는데도 정답 보상 RL(RLVR)의 효과 대부분을 회복합니다. 다트머스대·워싱턴대 세인트루이스 연구팀은 이를 배치 단위 그래디언트 분해로 설명했는데, 다수결 오류의 방향이 프롬프트마다 제각각이면 배치가 커질수록 오도가 사라집니다. 5개 모델에서 두 업데이트의 노이즈 보정 코사인은 약 1이었고, 정답 라벨 30%를 무작위로 뒤집어도 방향이 유지됐습니다.
💡검증기 없이 자기 보상을 설계할 때는 오류가 무작위인지, 모든 프롬프트에 같은 편향인지를 구분하는 것이 안전성을 가르는 기준이라는 점을 짚어줍니다.
원문 →#self-correction#majority-vote#rlvr#reward-design
🧪

액티브러닝

질문 수는 줄이고 빠진 보상만 묻는다, MIT 표적형 선호 학습

#
사람이 로봇에게 시연을 보여줄 때는 모든 측면을 한 번에 신경 쓰기 어려워 빠지는 부분이 생깁니다. MIT 연구팀은 시연에서 전달되지 않은 특징(feature)에만 선호 질문을 집중시키는 정보 기반 사전분포(informed prior)와, 질문마다 무엇을 봐야 할지 알려주는 설명을 결합했습니다. 질문 수가 적은 구간에서 표준 액티브 선호 학습(active preference learning)보다 최대 30.8% 높은 성능을 냈고, 사용자 연구에서도 두 요소가 각각 효과를 보였습니다.
💡RLHF처럼 사람 피드백을 모으는 프로젝트라면, 무작위로 묻기보다 모델이 아직 모르는 부분을 골라 묻는 설계가 라벨링 부담을 줄이는 출발점이 됩니다.
원문 →#active-learning#preference-learning#rlhf#robotics
🔄

지속학습

기능별 서브네트워크만 골라 갱신해 망각을 막는 하얼빈공대 CiMEO

#
LLM에 새 지시문을 계속 학습시키면 기존 능력을 덮어쓰는 파국적 망각(catastrophic forgetting)이 생깁니다. 하얼빈공대(선전) 연구팀의 CiMEO는 그래디언트 귀속으로 코딩·수학 같은 기능별 서브네트워크를 찾고, 예제마다 해당 영역의 파라미터와 옵티마이저 상태만 갱신합니다. 140만 지시문 순차 학습 후 Qwen3-1.5B 기준 5개 벤치마크 평균 38.92로 전체 파인튜닝(24.23)·LoRA(27.84)를 앞섰고, GSM8K는 67.55를 유지했습니다.
💡replay 버퍼 없이 동작하고 옵티마이저 상태도 일부만 갱신하므로, 메모리가 빠듯한 환경에서 모델을 계속 업데이트해야 하는 팀이 참고할 만한 설계입니다.
원문 →#continual-learning#catastrophic-forgetting#subnetwork#qwen

어텐션 헤드를 태스크별로 나눠 RL 망각을 줄이는 워싱턴대 연구

#
수학→지시이행→코딩처럼 RL 파인튜닝을 연달아 하면 새 업데이트가 이전 능력을 덮어쓰곤 합니다. 워싱턴대 등 공동연구팀은 헤드별 그래디언트 노름(gradient norm)으로 어텐션 헤드 순위를 매기고, 태스크마다 다른 헤드 집합을 배정하는 헤드 분할(head partitioning)을 제안했습니다. Qwen3-1.7B·4B, Mistral-7B에서 상위 50% 헤드만 학습해도 전체 튜닝에 근접했고, 이전 태스크 성능 하락은 줄이면서 새 태스크 적응력은 유지했습니다.
💡RL 후처리를 여러 단계로 진행할 때 어떤 파라미터를 어느 태스크에 맡길지 미리 나누는 것만으로도 태스크 간 간섭을 줄일 수 있다는 실용적인 힌트입니다.
원문 →#continual-learning#reinforcement-learning#attention-heads#sparse-finetuning
🧬

메타러닝

병목을 진단해 개선 방법까지 고르는 메타 에이전트, 베이항대 RSIFlow

#
기존 자기개선(self-improvement)은 모델·하네스·산출물 중 하나만 정해진 방식으로 고쳐, 바뀌는 병목에 대응하지 못했습니다. 베이항대·칭화대·BAAI 연구팀의 RSIFlow에서는 메타 에이전트가 궤적과 피드백으로 병목을 진단하고, 어느 구성요소를 어떤 워크플로로 개선할지 고른 뒤 결과를 스킬과 원칙으로 증류해 자기 하네스를 진화시킵니다. 6개 벤치마크에서 평균 SOTA를 기록했고, HumanEval+ pass@1은 Qwen3-4B에서 14.02%포인트 올랐습니다.
💡에이전트를 운영하며 프롬프트·도구·모델 중 무엇을 손볼지 고민한다면, 그 판단 자체를 진단 단계로 만들어 반복하는 구조를 참고해볼 수 있습니다.
원문 →#meta-learning#self-improvement#agent#harness

이 호가 도움됐다면 공유해 주세요 — 빌더 한 명이 더 알게 됩니다.

📤 공유하기𝕏@inf💬✈B✉