본문으로 건너뛰기
← vibecamp ai model 목록

vibecamp ai model · #35 · 2026-10-06

vibecamp ai model 2026-10-06 — 1B 토큰으로 10B replay 앞선 망각 억제형 지속 사전학습 데이터

2026-10-06 AI 모델 일간 호 — 오늘 8개 카드를 정리했습니다.

8개 카드 · 적은 예제로 스스로 깨우치는 학습법 일간

📤 공유하기𝕏@inf💬✈B✉
🎯

퓨샷 학습

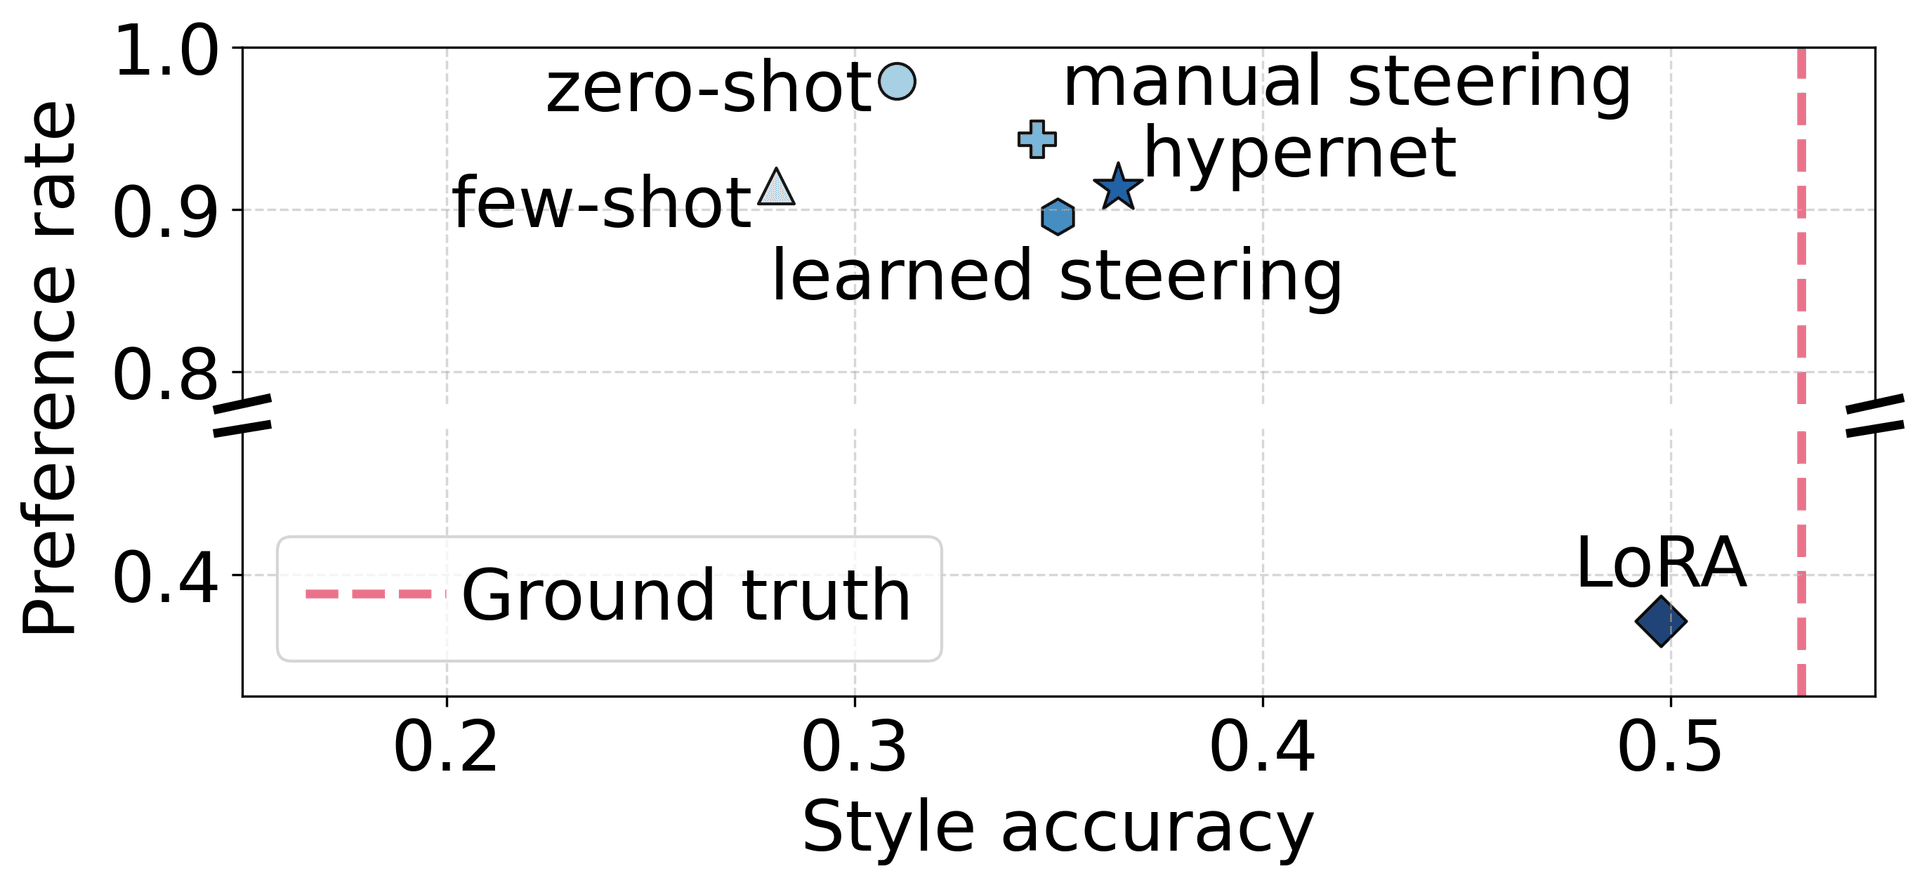
문체 정확도와 선호도 비교 산점도: 하이퍼네트워크가 제로샷·퓨샷·스티어링·LoRA 대비 균형점을 보이는 그래프

예시 몇 개로 저자 문체를 입히는 LoRA 하이퍼네트워크, KIT 연구

#
카를스루에 공대(KIT) 연구팀은 저자당 소수의 예시 초록만 보고 그 문체로 새 초록을 쓰게 하는 세 방법을 비교했습니다. 대조 활성 스티어링(activation steering), 스티어링 벡터 예측 네트워크, LoRA 어댑터 가중치를 직접 예측하는 하이퍼네트워크(hypernetwork)입니다. 파인튜닝은 문체를 잘 잡지만 유창성을 잃는 반면, 하이퍼네트워크는 본 적 있는 저자와 처음 보는 저자 모두에서 문체와 품질의 균형이 가장 좋았습니다. EMNLP 2026 W-NUT 워크숍 채택작입니다.
💡사용자마다 파인튜닝하지 않고 예시 몇 개로 개인화 어댑터를 즉석 생성하는 방향입니다. 개인 맞춤 작문 보조나 브랜드 톤 적용을 저비용으로 구현할 때 참고할 수 있습니다.
원문 →#few-shot-learning#style-transfer#hypernetwork#lora#arxiv
📚

커리큘럼 학습

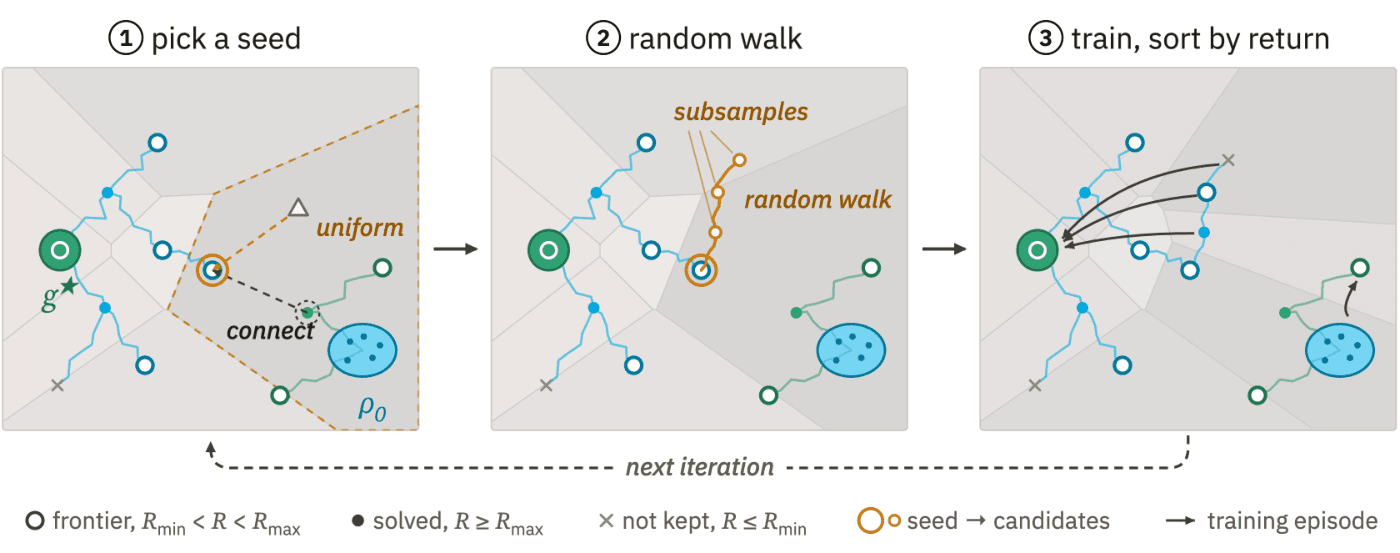
BVER 커리큘럼 3단계 도식: 시드 선택, 랜덤 워크로 후보 확장, 수익 기준 학습·정렬을 반복하는 과정

출발점과 목표를 양쪽에서 넓히는 RL 커리큘럼, ETH 취리히 BVER

#
보상이 드문 장기 과제에서 강화학습(RL) 에이전트는 목표에 거의 닿지 못해 학습 신호를 얻기 어렵습니다. ETH 취리히 Hutter 그룹의 BVER는 양방향 RRT 경로 계획에서 착안해, 목표 쪽에서는 시작 상태를, 시작 쪽에서는 목표를 동시에 넓혀 미탐색 영역에서 만나게 하는 자동 커리큘럼(curriculum)입니다. 4족 로봇 박스 오르기에서 0.4m 박스 95% 성공까지 반복 횟수를 약 65% 줄였고, 0.7m 박스를 학습한 유일한 비교 기법이었습니다.
💡쉬운 문제부터 순서대로 가는 것만이 아니라 양 끝에서 동시에 다가가는 것도 커리큘럼이 됩니다. 시연 데이터 없이 학습 순서 설계만으로 효율을 끌어올린 점이 실무에 유용합니다.
원문 →#curriculum-learning#reinforcement-learning#robotics#sparse-reward#arxiv
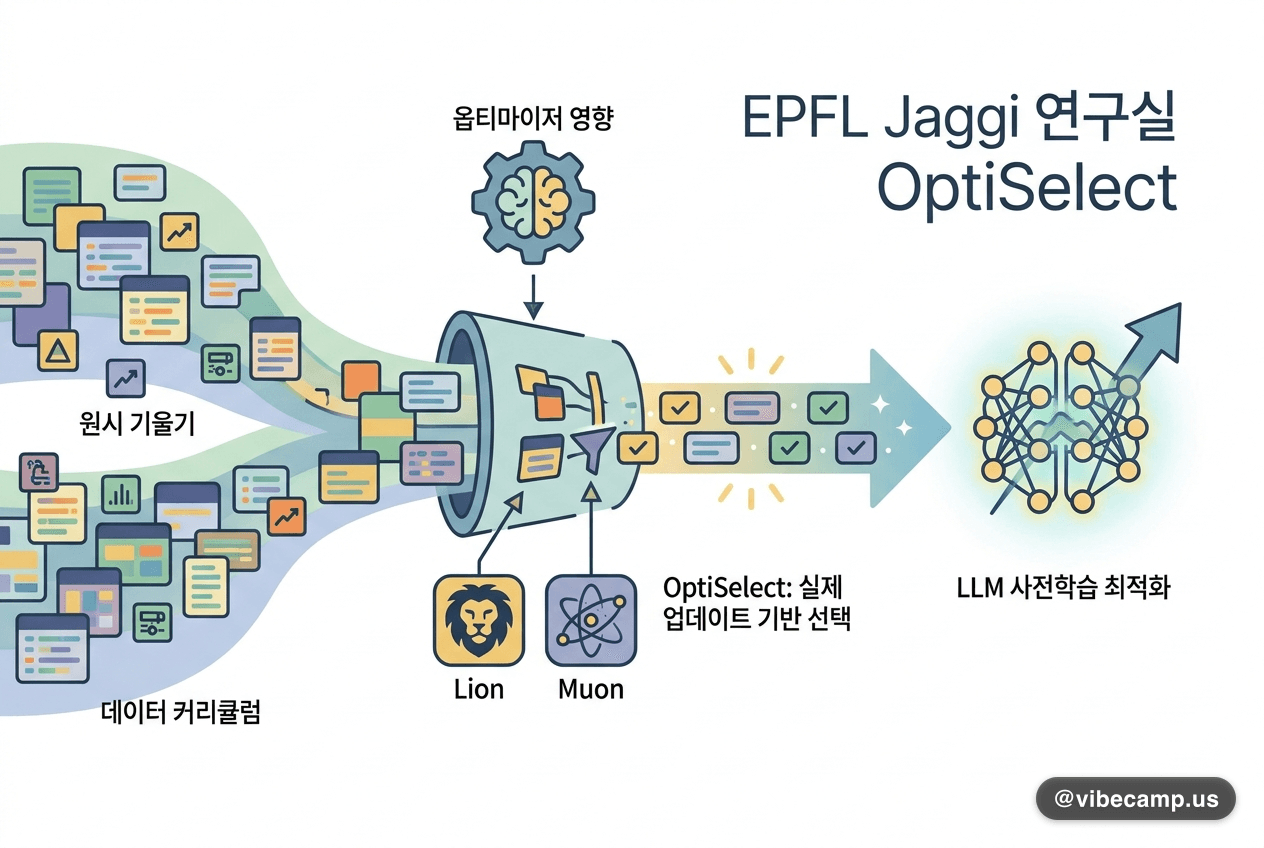
옵티마이저에 따라 효과가 달라지는 데이터 커리큘럼, EPFL OptiSelect

옵티마이저에 따라 효과가 달라지는 데이터 커리큘럼, EPFL OptiSelect

#
LLM 사전학습에서 배치마다 가치 있는 데이터를 골라 쓰는 온라인 데이터 선택(데이터 커리큘럼)은 그동안 원시 기울기로 데이터 가치를 매겨 왔습니다. EPFL Jaggi 연구실의 OptiSelect는 실제 업데이트를 만드는 옵티마이저(optimizer)의 영향을 함께 따진 첫 체계적 연구입니다. Lion·Muon 같은 부호·극분해 기반 방식에서는 선택 이득에 상한이 생김을 증명했고, 124M·720M 모델 실험에서 Muon을 써도 AdamW식 점수가 가장 강했습니다.
💡데이터 선택과 옵티마이저를 따로 고르면 기대한 효율이 나오지 않을 수 있다는 경고입니다. 학습 설정을 바꿀 때 데이터 전략도 함께 점검하라는 실무 체크리스트로 쓸 만합니다.
원문 →#curriculum-learning#data-selection#optimizer#llm-pretraining#arxiv
🪞

자가수정 학습

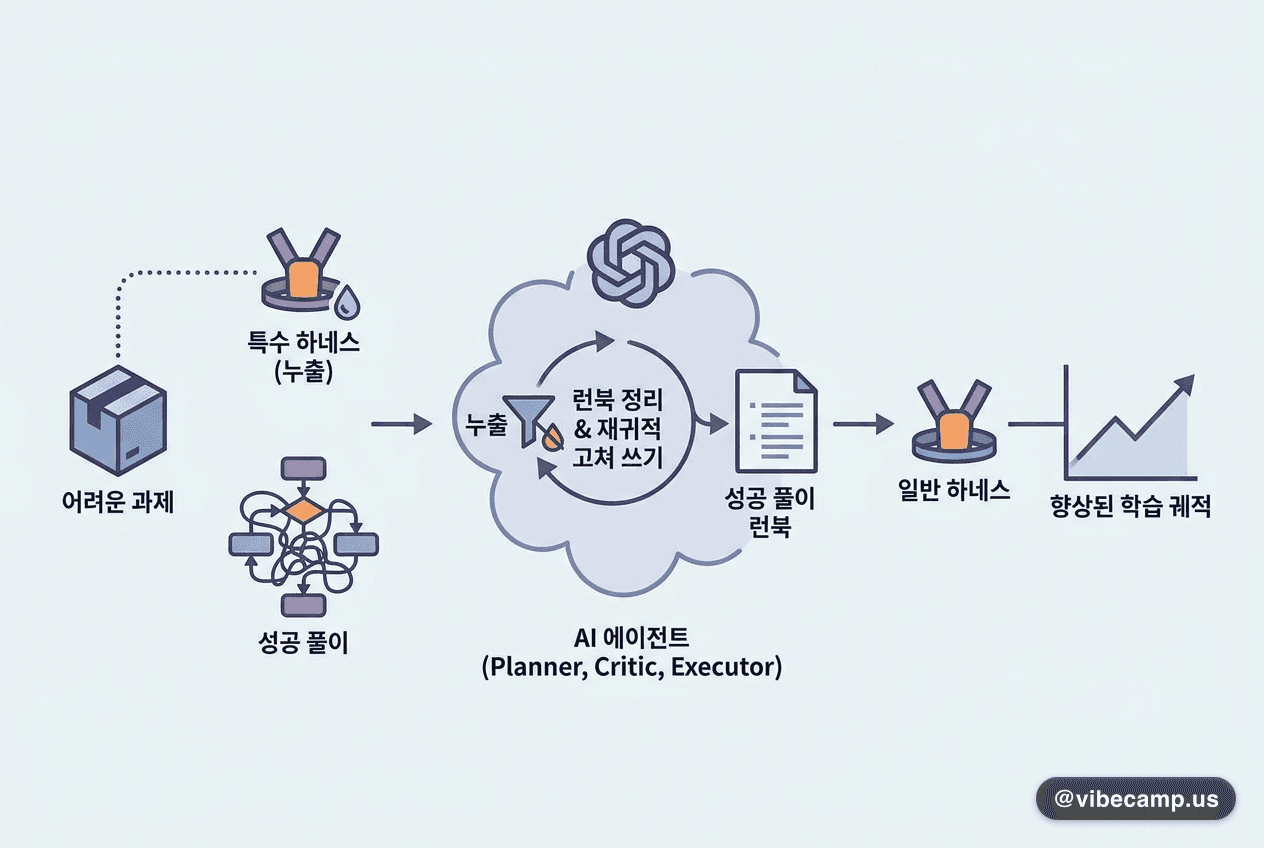
스스로 풀이를 고쳐 써 에이전트 학습 궤적을 늘리는 Tencent RSR

스스로 풀이를 고쳐 써 에이전트 학습 궤적을 늘리는 Tencent RSR

#
어려운 과제의 성공 풀이는 배포 때 못 쓰는 특수 하네스(harness)에 기대는 일이 많아, 그대로 학습하면 실제 환경으로 전이되지 않습니다. Tencent HY·메릴랜드대 등의 RSR은 Qwen-3.8-27B 하나가 planner·critic·executor를 맡아 성공 풀이를 runbook으로 정리하고, 누출을 걸러 재귀적으로 고쳐 쓴 뒤 일반 하네스에서 재실행합니다. 성공 궤적 2,001개를 11,094개로 늘렸고, Terminal-Bench 2 pass@3은 57.0→74.2%로 올랐습니다.
💡모델이 자기 성공 경험을 배포 환경에서도 통하는 절차로 다시 써서 스스로 교재를 만드는 구조입니다. 에이전트 학습 데이터를 직접 만들려는 팀에게 참고가 됩니다.
원문 →#self-correction#agent#synthetic-data#terminal-bench#tencent
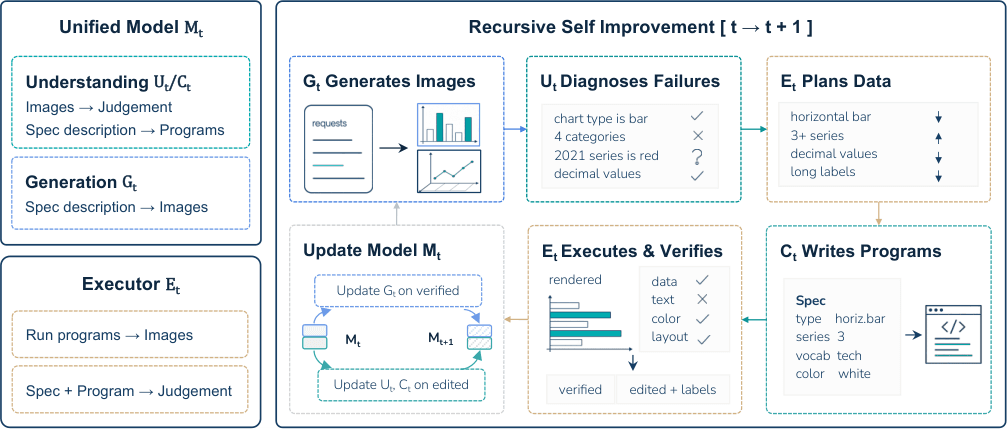
통합 멀티모달 모델의 재귀적 자기개선 루프 도식: 이미지 생성, 실패 진단, 데이터 계획, 프로그램 작성·실행 검증, 모델 갱신 순환

이미지 생성과 코드 실행으로 스스로 약점을 고치는 멀티모달 모델

#
텍스트와 이미지를 함께 다루는 통합 멀티모달 모델(UMM)의 자가개선은 모델이 자기 결과를 채점하다 보니 오류가 라운드마다 쌓이는 문제가 있었습니다. USC·UCSD·CMU 공동연구팀의 RSI는 모델이 이미지를 생성하고 읽어 부족한 지점을 찾은 뒤, 그 약점을 겨냥한 프로그램을 작성하고 실행 결과로 검증해 다시 학습 데이터로 씁니다. 차트 과제에서 4라운드 만에 45.7→60.2%로 올랐고, 단순 추가 학습은 46.3%에 머물렀습니다.
💡자가개선의 핵심은 모델 바깥에 진실원(source of truth)을 두는 것임을 보여줍니다. 코드 실행처럼 자동 검증 가능한 신호를 학습 루프에 넣는 설계에 참고할 만합니다.
원문 →#self-improvement#multimodal#program-verification#chart-understanding#arxiv
🔄

지속학습

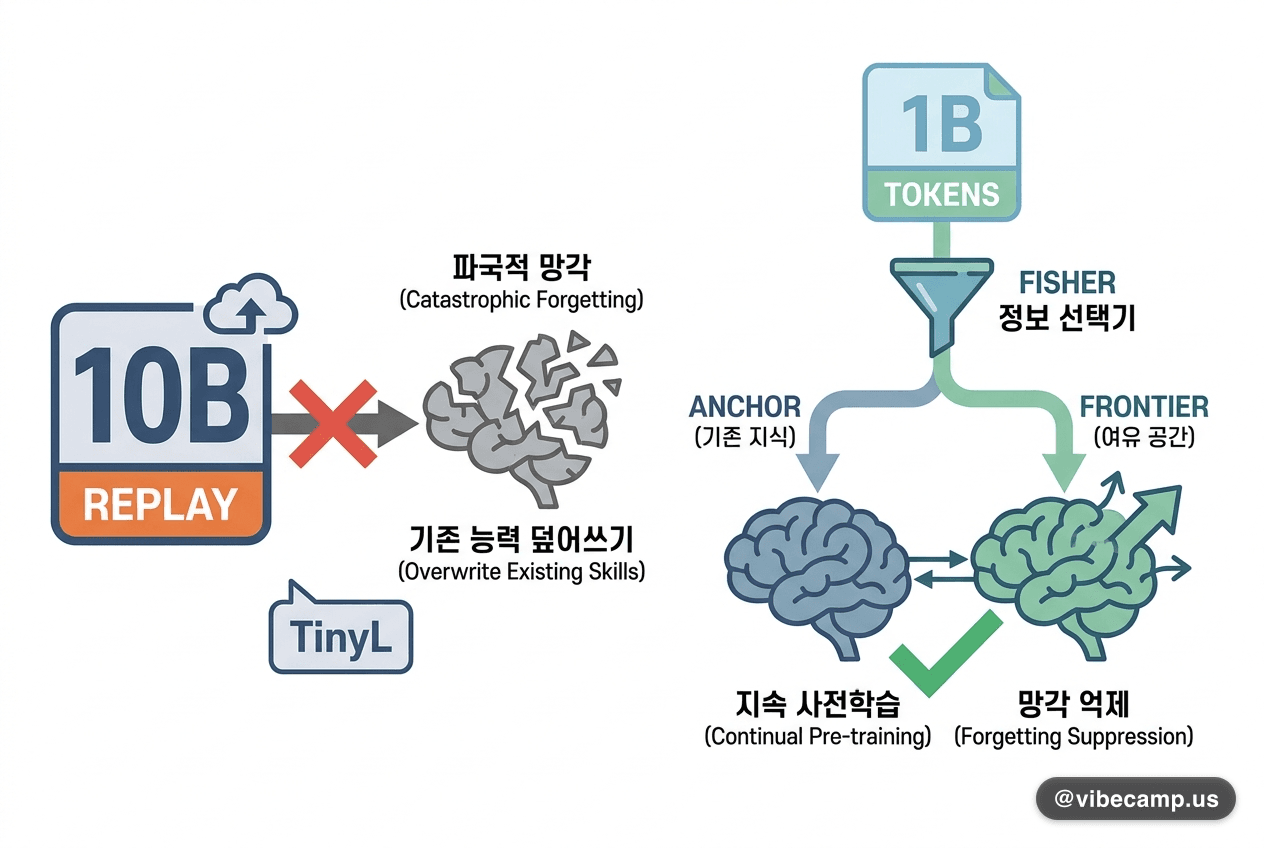
1B 토큰으로 10B replay 앞선 망각 억제형 지속 사전학습 데이터 선택

1B 토큰으로 10B replay 앞선 망각 억제형 지속 사전학습 데이터 선택

#
지속 사전학습(continual pre-training)은 도메인 데이터가 기존 능력을 덮어쓰는 파국적 망각이 골칫거리입니다. UIC와 Cisco Research 연구팀은 후보 데이터의 기울기를 기존 지식 방향(anchor)과 여유 공간(frontier)으로 나눠, 망각을 덜 일으키는 데이터만 고르는 Fisher 정보 기반 선택기를 제안했습니다. TinyLlama-1.1B·Llama-3.1-8B 의료 도메인 실험에서 1B 토큰만으로 10B 토큰 replay 전략보다 적응과 망각 양쪽 모두 앞섰습니다.
💡도메인 특화 모델을 만들 때 데이터를 더 넣는 것보다 무엇을 고르느냐가 망각을 좌우한다는 사례입니다. 약 10배 토큰 효율은 작은 팀의 학습 예산 계획에 바로 참고할 만합니다.
원문 →#continual-learning#catastrophic-forgetting#data-selection#llm-pretraining#arxiv
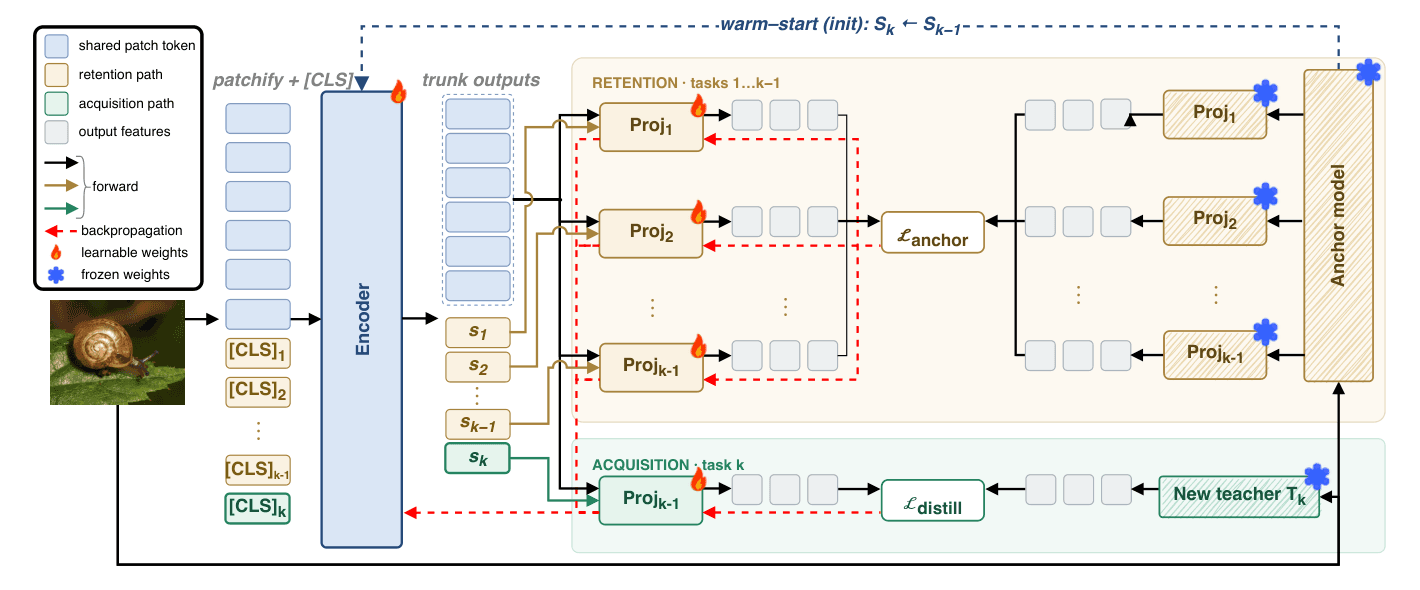
GRAFT 구조도: 공유 인코더가 이전 과제의 보존 경로와 새 교사 모델의 증류 경로를 함께 학습하는 파이프라인

교사 모델을 하나씩 더하며 자라는 비전 백본, Amazon의 GRAFT

#
여러 비전 파운데이션 모델을 하나로 합치는 집적형(agglomerative) 백본은 교사 집합이 고정돼 있어, 새 모델을 추가하려면 전체 교사로 증류를 처음부터 다시 해야 했습니다. Amazon과 UIC 연구팀의 GRAFT는 DINOv2·SigLIP2·MASt3R 같은 교사를 하나씩 추가하면서, 이전에 증류된 모델 자체를 기존 능력 보존용 교사로 씁니다. 이미지 이해·2D 밀집 예측·3D 인체 자세·3D 비전·비전-언어 5개 도메인을 한 백본에 담고, 새 능력 추가 비용을 1회 증류로 줄였습니다.
💡과거의 자신을 선생님으로 두면 새 능력을 배우면서도 기존 능력을 지킬 수 있다는 아이디어입니다. 모델을 처음부터 다시 학습하지 않고 점진적으로 키우는 설계 패턴으로 가져가기 좋습니다.
원문 →#continual-learning#knowledge-distillation#vision-foundation-model#amazon#arxiv
🧬

메타러닝

생각 과정 없이 파라미터를 바꿔 추론하는 KAIST·NYU의 HyperThink

생각 과정 없이 파라미터를 바꿔 추론하는 KAIST·NYU의 HyperThink

#
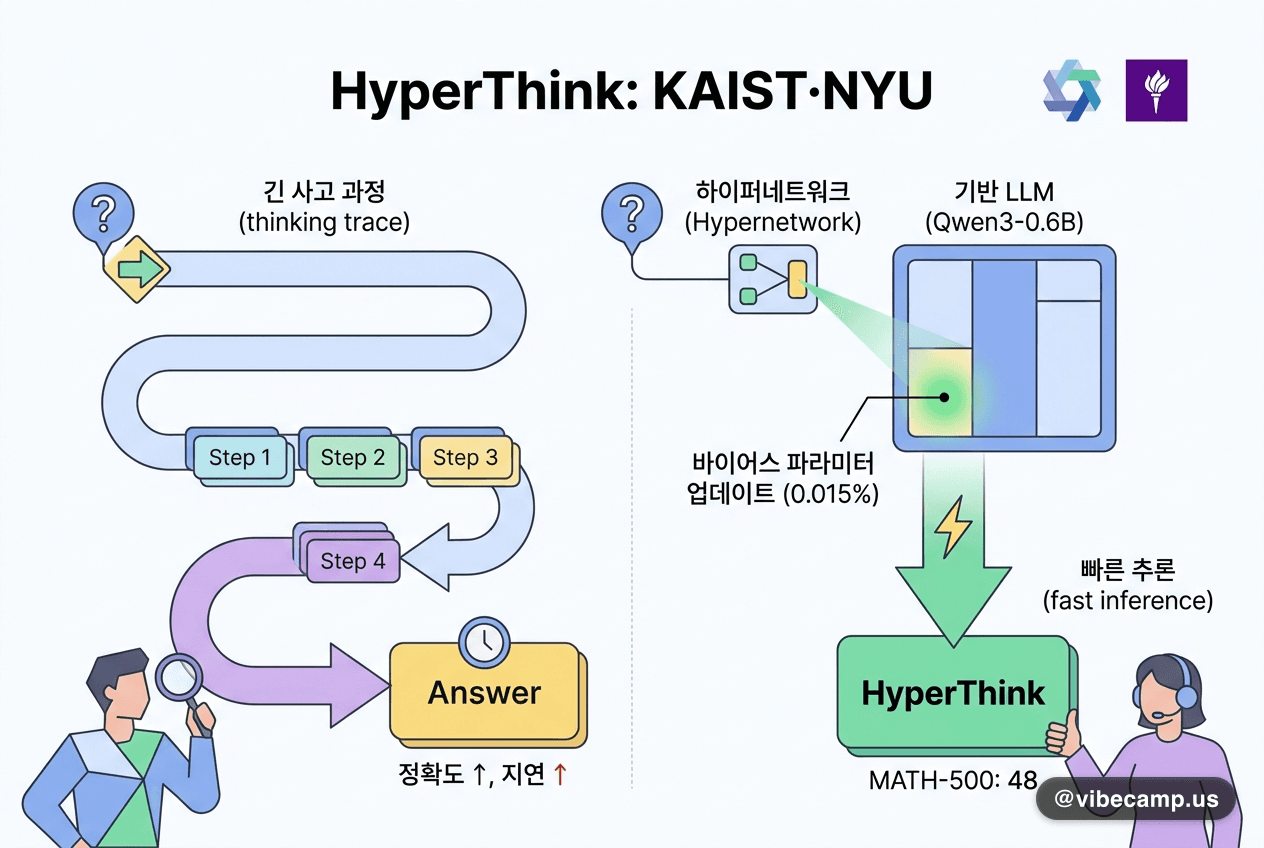
긴 사고 과정(thinking trace)은 정확도를 높이지만 지연이 큽니다. KAIST와 NYU 공동연구팀의 HyperThink는 질문을 읽은 하이퍼네트워크가 기반 LLM 바이어스 파라미터 일부(0.6B 모델 기준 0.015%)의 업데이트를 1회 순전파로 예측해, 중간 trace 없이 바로 풀이하게 합니다. Qwen3-0.6B는 MATH-500에서 48.76%로 Non-Thinking(46.84%)을 넘고 Thinking(52.64%)에 근접하면서 연산량(FLOPs)은 약 1/4이었습니다.
💡문제마다 생각하던 비용을 질문 맞춤 파라미터 조정으로 미리 갚아두는(amortize) 메타러닝 접근입니다. 작은 모델로 추론 품질과 속도를 함께 챙기려는 학습자에게 좋은 힌트입니다.
원문 →#meta-learning#hypernetwork#efficient-reasoning#kaist#arxiv

이 호가 도움됐다면 공유해 주세요 — 빌더 한 명이 더 알게 됩니다.

📤 공유하기𝕏@inf💬✈B✉
vibecamp ai model 2026-10-06 — 1B 토큰으로 10B replay 앞선 망각 억제형 지속 사전학습 데이터 | vibecamp ai model