본문으로 건너뛰기
← vibecamp ai model 목록

vibecamp ai model · #33 · 2026-10-03

vibecamp ai model 2026-10-03 — 어떤 LLM을 쓸까? 적은 라벨로 최적 모델 찾는 ONLINE LLM P

2026-10-03 AI 모델 일간 호 — 오늘 7개 카드를 정리했습니다.

7개 카드 · 적은 예제로 스스로 깨우치는 학습법 일간

📤 공유하기𝕏@inf💬✈B✉
🎯

퓨샷 학습

퓨샷 압축의 한계 — 규칙은 압축되고 임의 짝짓기는 안 된다

#
퓨샷 예시를 매번 프롬프트에 넣지 않고 압축해 재사용하는 기법이 어떤 언어 작업에서 통하는지 분석한 연구입니다. 저자는 예시 집합의 기하 구조를 한 번 계산해 캐시하고, 2.6M 파라미터 소형 네트워크가 동결된 GPT-2-large/XL 중간층에 보정값을 더하게 했습니다. 굴절 같은 규칙형 변환은 ICL 수준을 냈고, 원형 복원(lemmatization)에서는 ICL보다 최대 +72점 높았습니다. 반면 반의어 같은 임의 짝짓기는 규모·용량과 무관하게 ICL의 절반 근처에서 멈췄습니다.
💡어제 소개한 ICL 압축 기법과 짝을 이루는 '한계 지도'입니다. 퓨샷 프롬프트를 캐시·압축하기 전에 작업이 규칙형인지 암기형인지부터 따져볼 기준이 됩니다. NeurIPS 2026 워크숍 논문입니다.
원문 →#in-context-learning#few-shot#task-vector#amortization#interpretability
📚

커리큘럼 학습

ActiveSaddler — 에이전트 하네스 최적화용 자동 커리큘럼, GAIA2·Terminal-Bench 성능·비용 개선 요약

에이전트 하네스 최적화에 커리큘럼을 — KAIST·MS의 ActiveSaddler

#
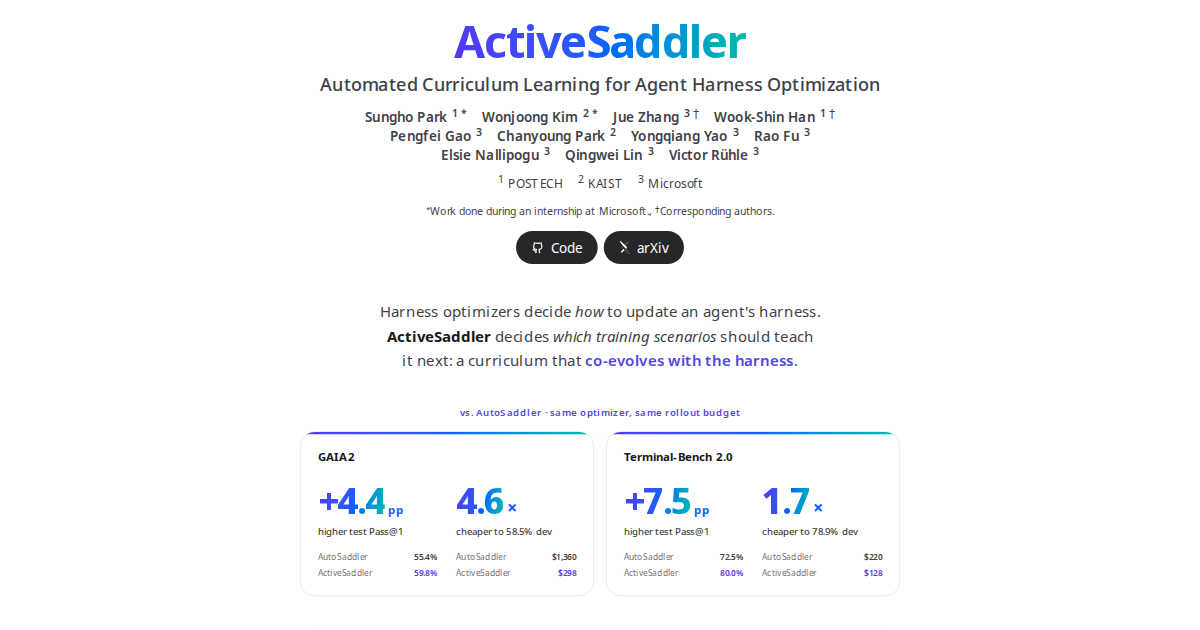
LLM 에이전트 하네스(harness: 프롬프트·툴 인터페이스·제어 로직)를 자동 최적화할 때 기존 방법은 어떤 시나리오로 피드백을 받을지 순서를 미리 고정해, 이미 해결된 실패에 피드백을 낭비했습니다. KAIST·POSTECH·Microsoft 공동 연구팀의 ActiveSaddler는 반복 실패를 재사용 가능한 실패 패턴으로 묶고, 비정상(non-stationary) 밴딧으로 학습 진척이 큰 패턴을 우선 배정하는 자동 커리큘럼을 만듭니다. 같은 최적화기 대비 Pass@1이 GAIA2에서 4.4%p, Terminal-Bench 2.0에서 7.5%p 올랐습니다.
💡에이전트 프롬프트를 고칠 때 '어떤 실패 사례부터 볼지'만 바꿔도 성능이 달라진다는 근거입니다. 평가셋을 실패 패턴별로 묶어 관리하는 습관부터 들여볼 만합니다.
원문 →#curriculum-learning#agent-harness#prompt-optimization#bandit#terminal-bench
🪞

자가수정 학습

에이전트가 스스로 실수 지점을 진단해 학습 — 강화학습 기법 FAULT

#
최종 성공·실패 보상만 쓰는 에이전트 강화학습은 결과가 같은 롤아웃끼리는 학습 신호가 사라지고, 어느 결정이 실패를 낳았는지도 알기 어렵습니다. 연구팀의 FAULT는 에이전트가 자기 궤적을 스스로 진단(self-diagnosis)해 오류 단계를 찾고, 그 근거를 검증한 뒤 단계별 보상(credit)으로 바꿉니다. 학습 중 정책과 자기진단기가 함께 진화합니다. ALFWorld에서 같은 결과 그룹의 학습 신호 회수율이 95%로 GRPO 41%, GiGPO 72%를 앞섰습니다.
💡'반성(reflection)'을 그대로 믿지 않고 검증해 보상으로 쓰는 설계가 핵심입니다. 에이전트 로그에서 실패 단계를 자동 태깅하는 디버깅 도구를 만들 때도 참고할 만합니다.
원문 →#self-correction#agentic-rl#credit-assignment#self-diagnosis#alfworld
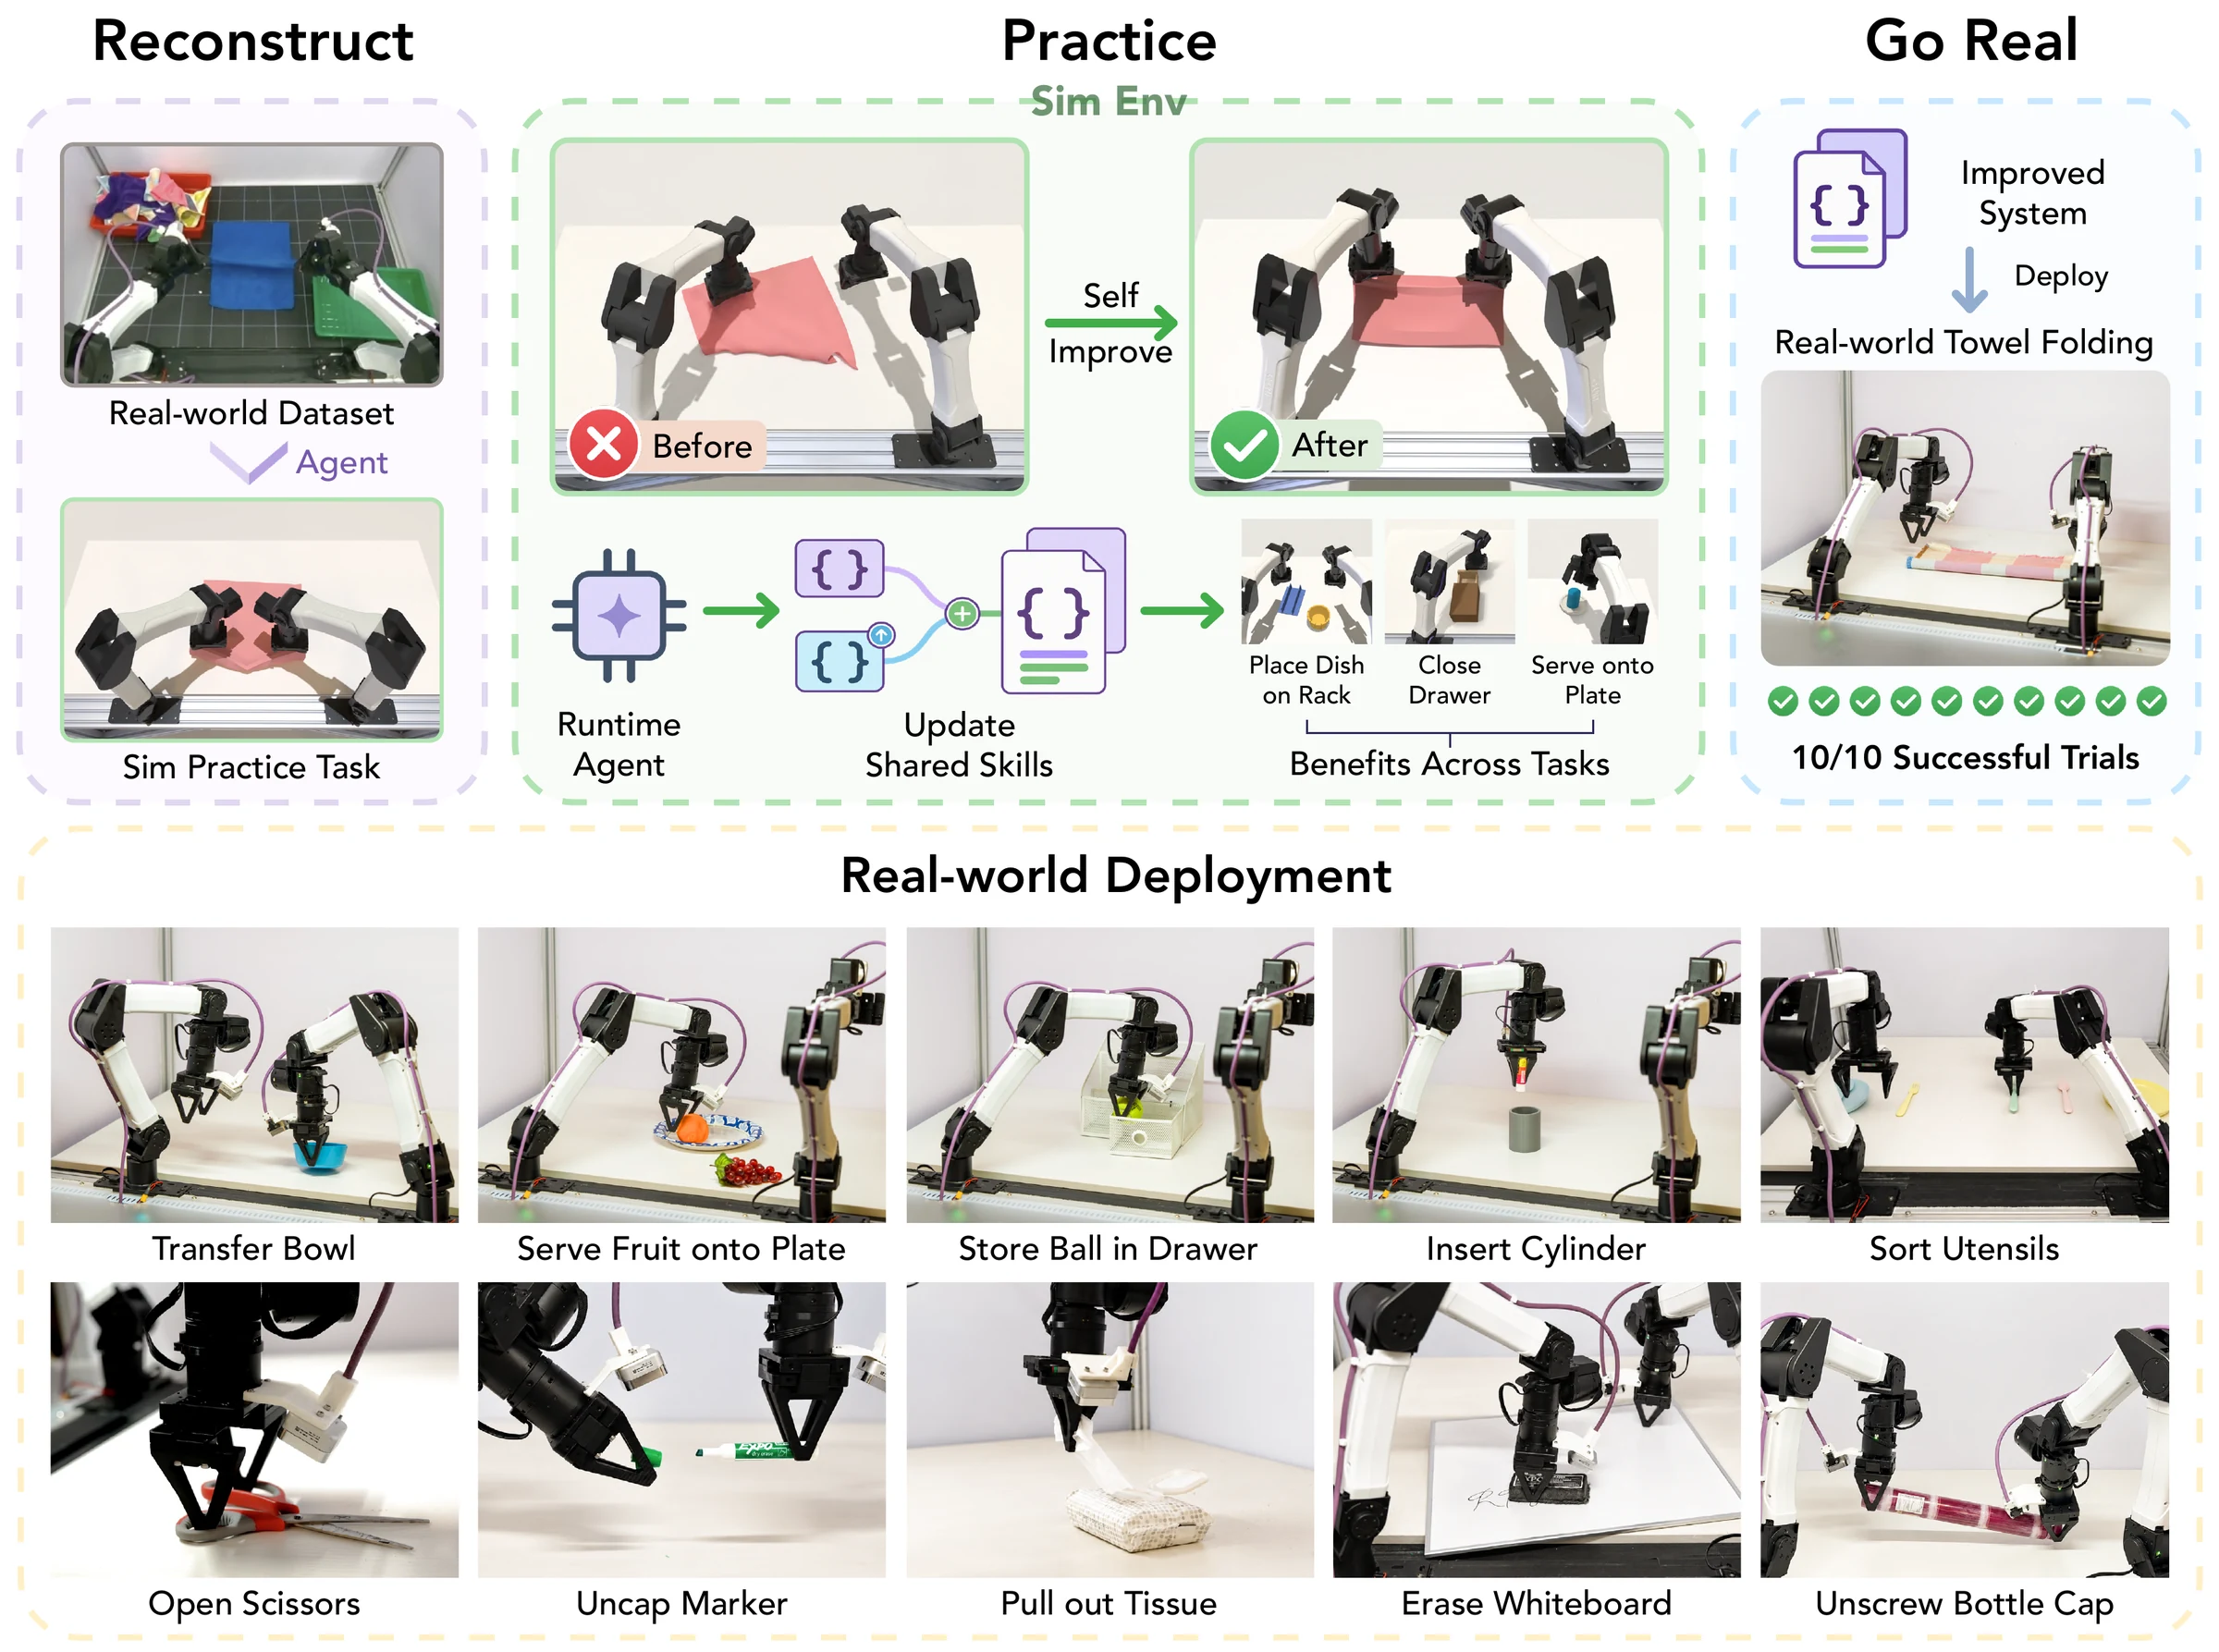
재구성→시뮬 연습→실제 배치, 스스로 스킬을 고치는 양팔 로봇 RPG 개요

시뮬레이션 연습으로 스스로 고치는 로봇 — 성공률 28.6%→95.0%

#
Pieter Abbeel 등이 참여한 연구팀이 모델 가중치를 바꾸지 않고 로봇 실행 시스템을 스스로 개선하는 프레임워크 RPG를 공개했습니다. 시뮬레이션에서 연습하며 실행 피드백·시뮬레이터 상태·데이터셋 영상으로 실패 원인을 진단하고, 재사용 가능한 스킬을 새로 만들거나 다듬고 시스템 프롬프트를 고칩니다. 22개 조작 과제 성공률은 첫 라운드 28.6%에서 15라운드 후 95.0%로 올라 ASPIRE(75.5%), CaP-Agent0(60.0%)를 앞섰고, 실제 로봇 30회 시험도 모두 성공했습니다.
💡코딩 에이전트처럼 스킬 라이브러리와 프롬프트를 스스로 고치는 루프가 로봇에서도 통한다는 사례입니다. 가중치 학습 없이 개선 루프를 설계하는 방법으로 눈여겨볼 만합니다.
원문 →#self-improvement#embodied-agent#robotics#skill-library#sim-to-real
🧪

액티브러닝

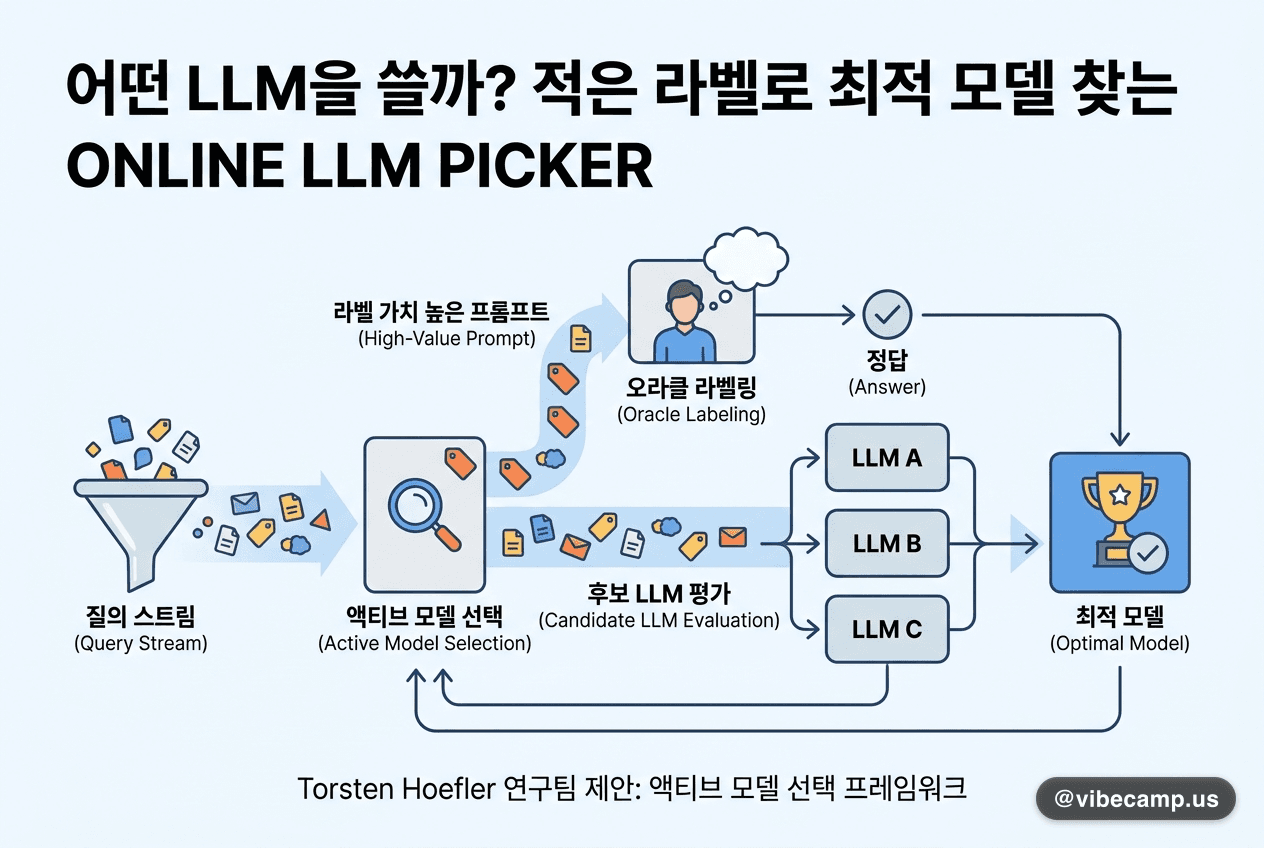
어떤 LLM을 쓸까? 적은 라벨로 최적 모델 찾는 ONLINE LLM PICKER

어떤 LLM을 쓸까? 적은 라벨로 최적 모델 찾는 ONLINE LLM PICKER

#
벤치마크 점수는 실제 업무 성능을 근사할 뿐이고, 정답(오라클) 라벨은 비싸서 대량으로 받기 어렵습니다. Torsten Hoefler 등 연구팀은 들어오는 질의 스트림에서 라벨을 달 가치가 큰 프롬프트만 골라 정답을 받고, 후보 LLM 중 최적 모델을 온라인으로 찾는 액티브 모델 선택(active model selection) 프레임워크를 제안했습니다. 10개 데이터셋·130개 이상 모델에서 라벨링 비용을 최대 71.67% 줄이면서 최적 또는 준최적 모델을 안정적으로 찾았고, regret은 최대 2.51배 줄었습니다.
💡서비스에 붙일 모델을 고를 때 리더보드 대신 내 실제 질의로, 적은 검수 예산 안에서 비교하는 방법입니다. 모델 교체가 잦은 팀이라면 평가 파이프라인 설계에 참고할 만합니다.
원문 →#active-learning#model-selection#llm-evaluation#annotation-cost#online-learning
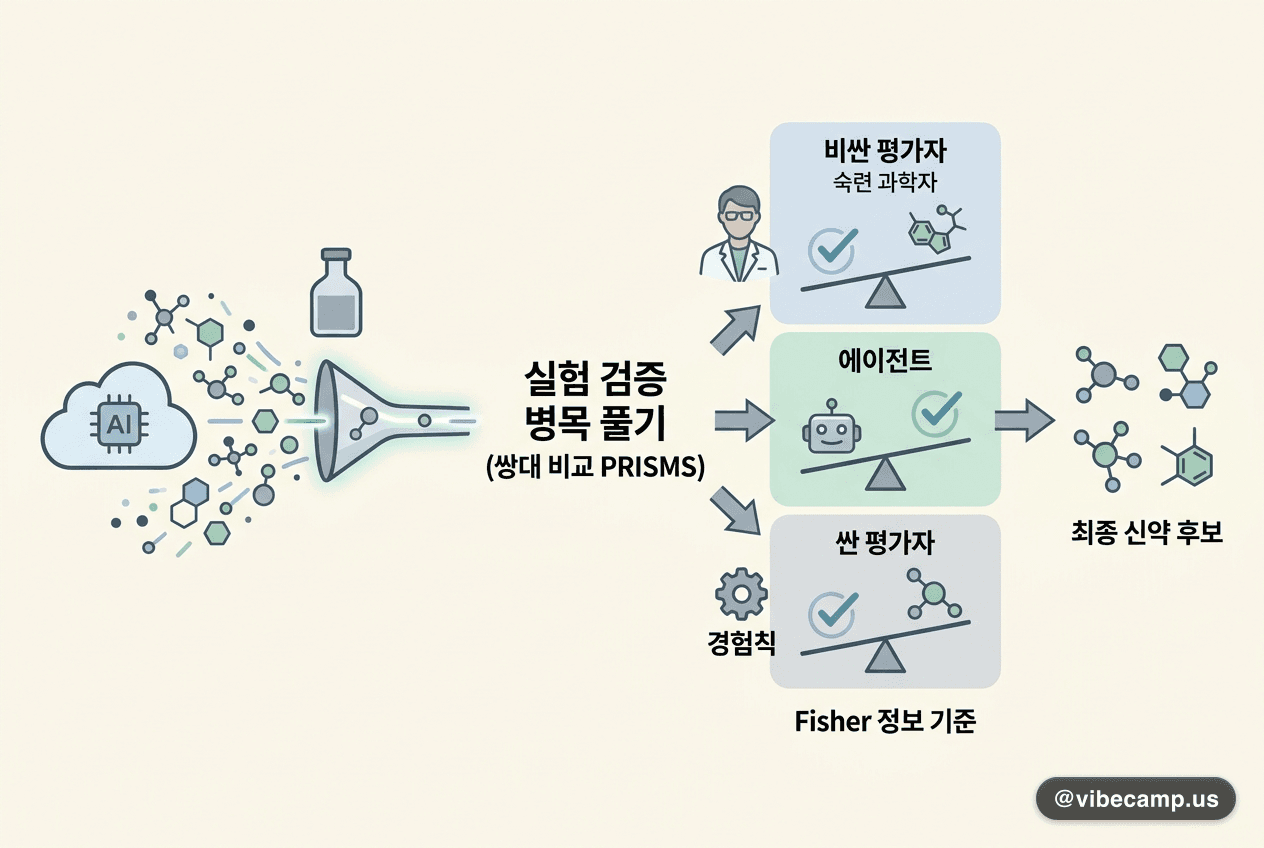
실험 검증 병목 풀기 — 쌍대 비교로 신약 후보 고르는 PRISMS

실험 검증 병목 풀기 — 쌍대 비교로 신약 후보 고르는 PRISMS

#
AI가 분자·소재 후보를 대량으로 내놓아도 실험 검증 용량은 한정돼 있습니다. 연구팀의 PRISMS는 절대 점수 대신 '둘 중 무엇이 나은가'라는 쌍대 비교(pairwise ranking) 라벨을 쓰고, 경험칙·에이전트 같은 싼 평가자에서 숙련 과학자 같은 비싼 평가자로 Fisher 정보 기준에 따라 질의를 단계적으로 올립니다. 신약 라이브러리 스크리닝에서 top-10 재현율 50% 도달까지 회귀 기반 액티브러닝 대비 라운드를 약 42% 줄였습니다.
💡정확한 점수보다 '더 나은 쪽 고르기'가 사람에게 쉽다는 점을 활용합니다. 사람 평가가 비싼 LLM 출력 비교나 데이터 큐레이션에도 같은 발상을 적용해 볼 수 있습니다.
원문 →#active-learning#pairwise-ranking#drug-discovery#multi-fidelity#ai-for-science
🔄

지속학습

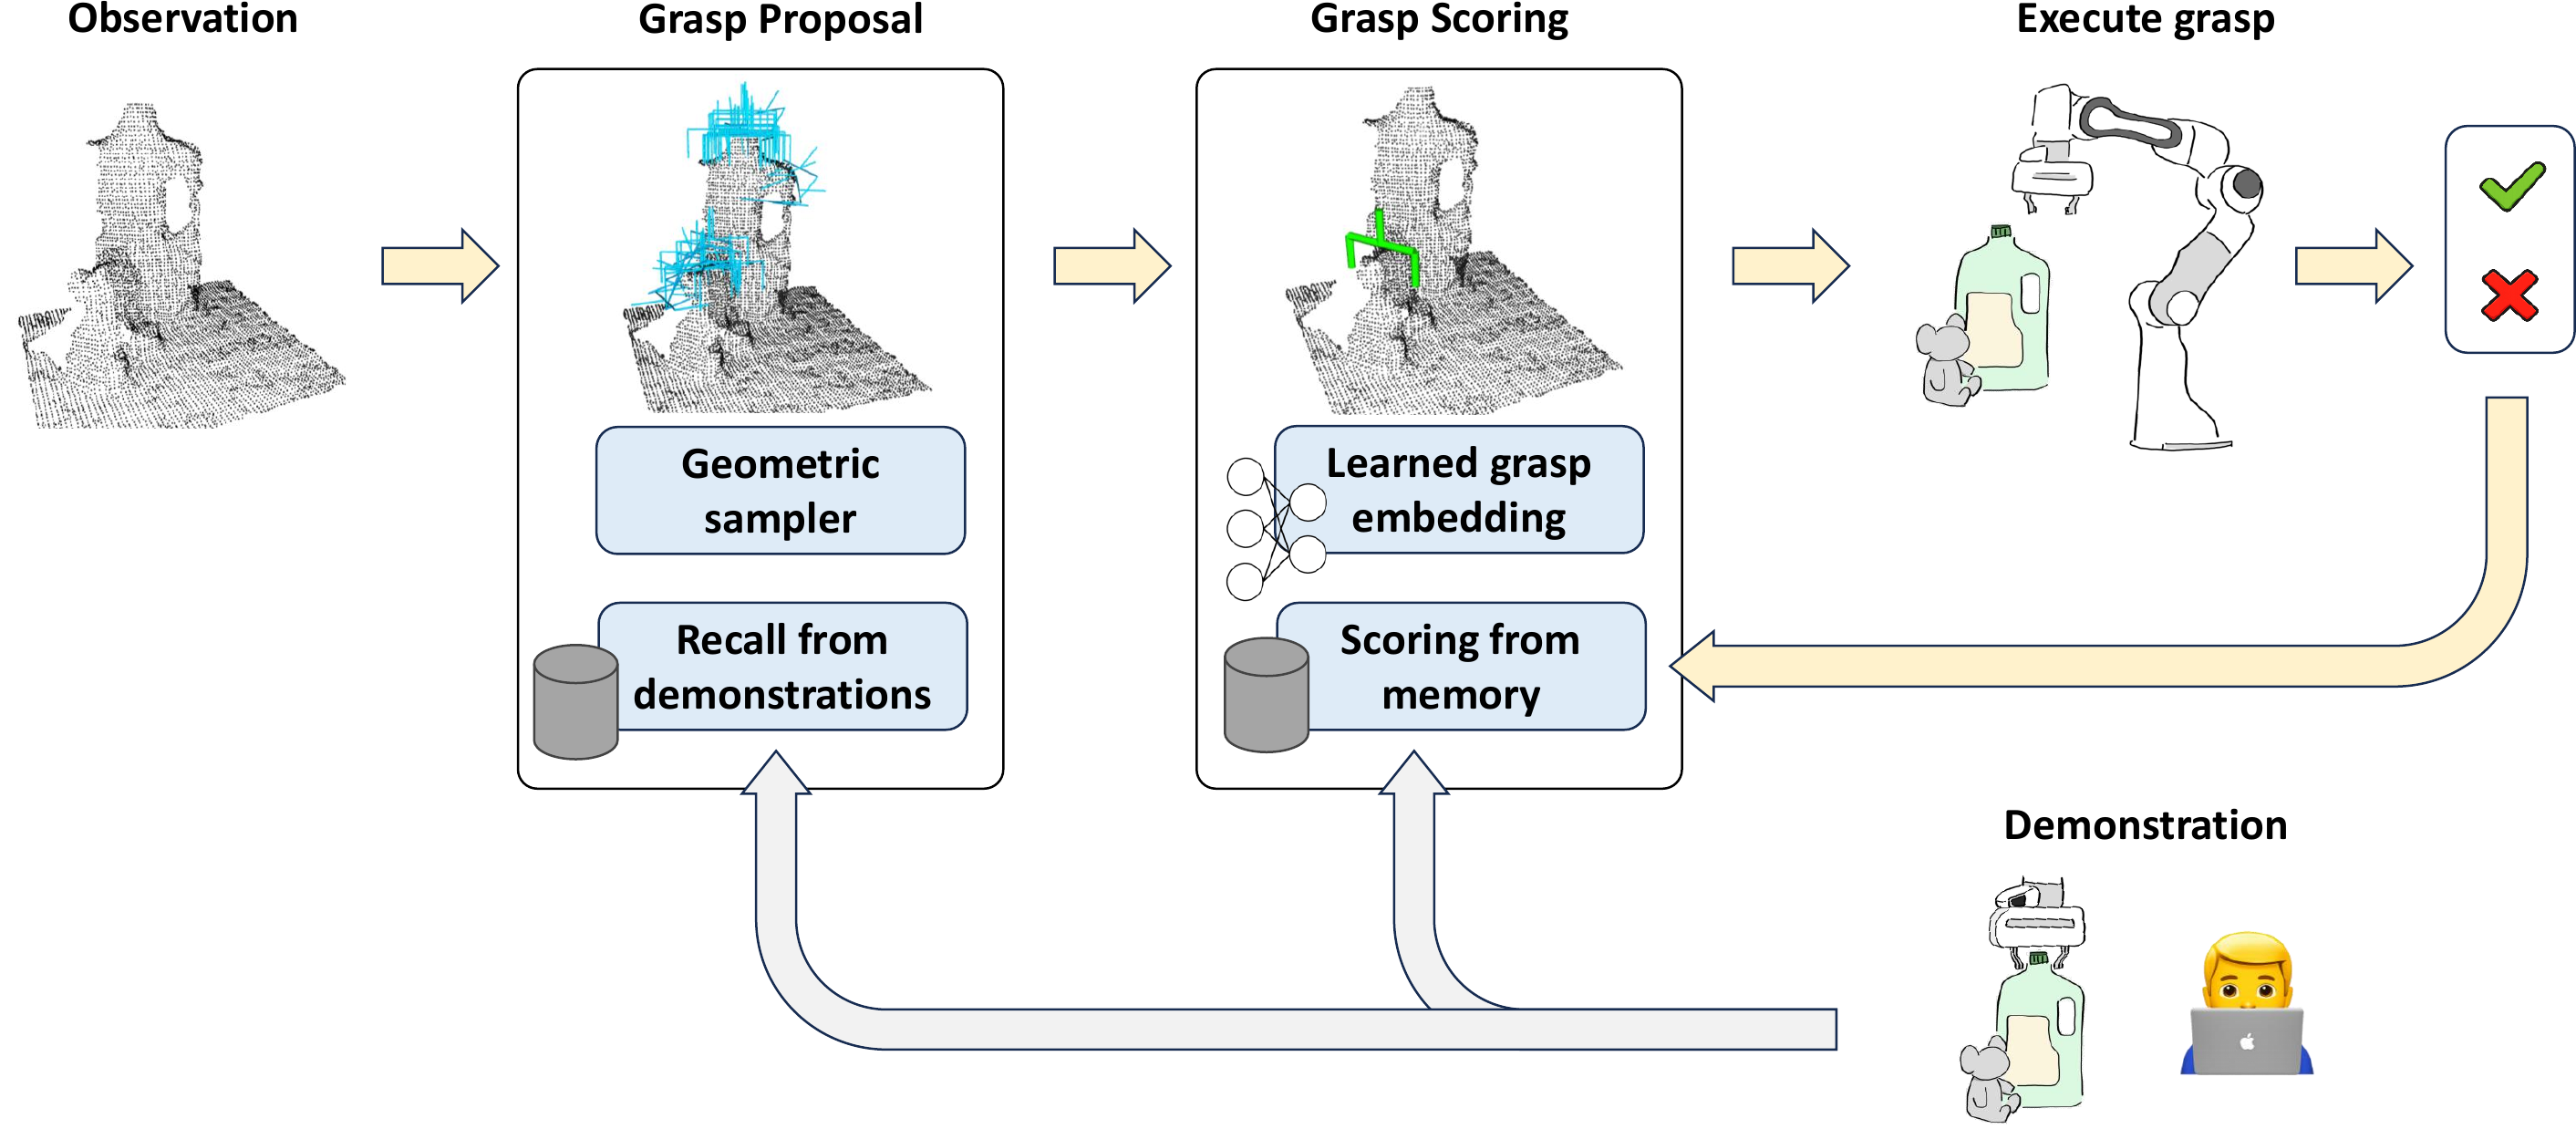
관측→파지 제안→점수화→실행, 결과와 시연을 메모리로 되먹이는 로봇 파지 지속학습 파이프라인

배치 후에도 배우는 로봇 파지 — 50회 시도로 성공률 90% 이상

#
대부분의 로봇 파지(grasp) 모델은 오프라인 학습 후 고정돼, 처음 보는 물체에서 성능이 떨어지고 파인튜닝하면 기존 능력을 잊기 쉽습니다. ETH Zurich 연구팀은 큰 모델을 고치는 대신 학습된 임베딩 공간의 메모리로 적응하는 6자유도(6-DoF) 파지 연속학습(continual learning) 프레임워크를 내놨습니다. 파지 성공·실패가 이후 점수를 갱신하고, 사용자 시연을 기억해 새 장면에 옮깁니다. 1,500회 이상 실기 실험에서 온라인 50회 시도만으로 여러 어려운 물체 범주의 성공률이 90%를 넘었습니다.
💡가중치를 건드리지 않고 메모리로 적응하면 망각 위험 없이 현장 데이터를 바로 반영할 수 있습니다. CoRL 2026 채택 논문으로, LLM 에이전트의 메모리 설계와도 통하는 패턴입니다.
원문 →#continual-learning#robotics#grasping#memory#corl-2026

이 호가 도움됐다면 공유해 주세요 — 빌더 한 명이 더 알게 됩니다.

📤 공유하기𝕏@inf💬✈B✉