본문으로 건너뛰기
← vibecamp ai model 목록

vibecamp ai model · #32 · 2026-10-02

vibecamp ai model 2026-10-02 — 편향된 LLM 저지로도 라벨 예산 아낀다 — regret 29.1% 줄인

2026-10-02 AI 모델 일간 호 — 오늘 8개 카드를 정리했습니다.

8개 카드 · 적은 예제로 스스로 깨우치는 학습법 일간

📤 공유하기𝕏@inf💬✈B✉
🎯

퓨샷 학습

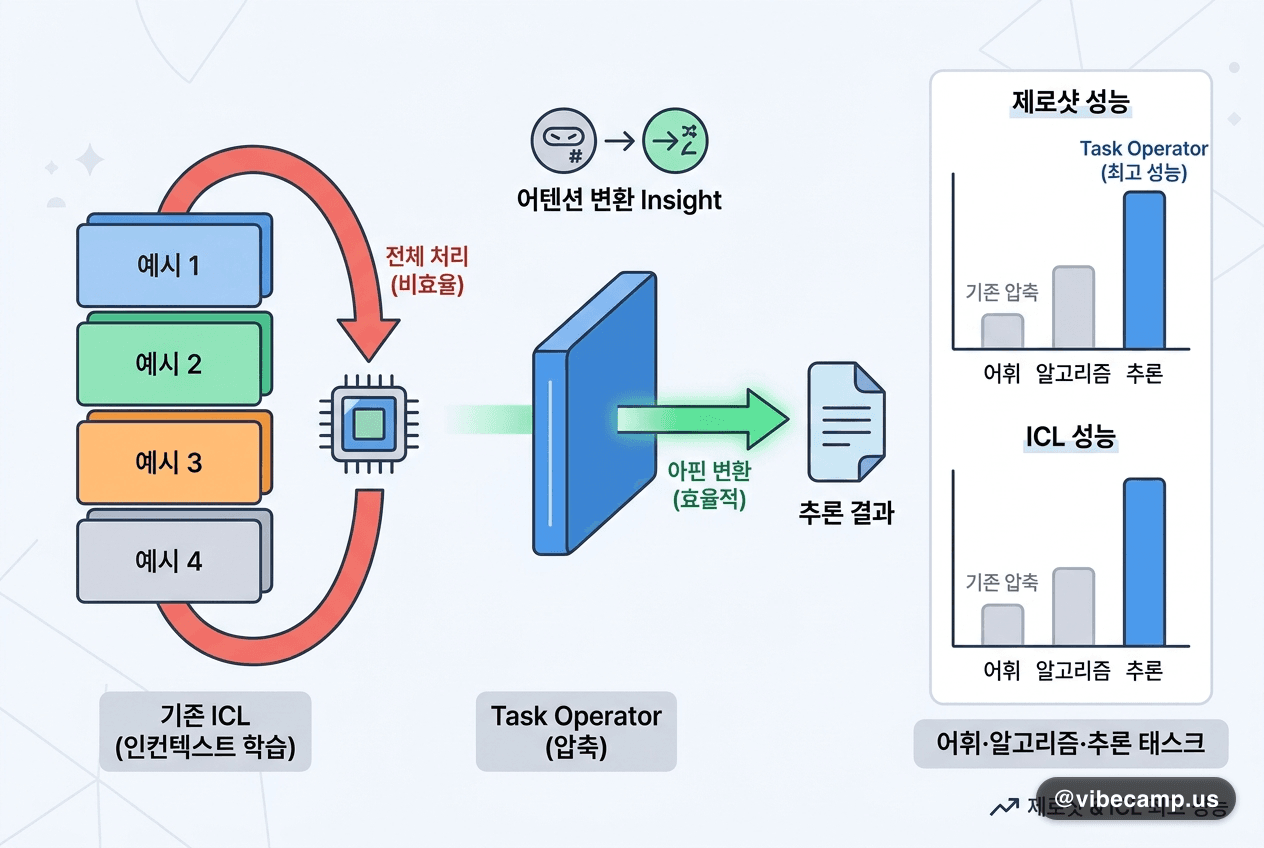
퓨샷 예시를 매번 넣지 않는 ICL — 어텐션 변환 압축 Task Operator

퓨샷 예시를 매번 넣지 않는 ICL — 어텐션 변환 압축 Task Operator

#
인컨텍스트 학습(in-context learning)은 추론할 때마다 예시 전체를 다시 처리해야 해 비용이 큽니다. 연구팀은 각 어텐션 헤드의 출력이 문맥을 가린 출력의 아핀 변환이라는 점을 발견하고, 이를 출력 투영 업데이트로 재현하는 Task Operator를 제안했습니다. 어휘·알고리즘·추론 태스크에서 기존 압축법 중 가장 좋은 성능으로 제로샷과 ICL의 격차를 크게 좁혔습니다. 여러 예시 배치의 operator를 평균하면 컨텍스트 창을 늘리지 않고 many-shot으로 확장할 수 있습니다.
💡퓨샷 프롬프트로 돌리던 반복 업무라면 예시를 매번 붙이는 대신 한 번 압축해 재사용해 토큰 비용을 줄일 여지가 생깁니다. NeurIPS 2026 논문이고 코드도 공개돼 있습니다.
원문 →#in-context-learning#few-shot#attention#inference-cost#neurips-2026
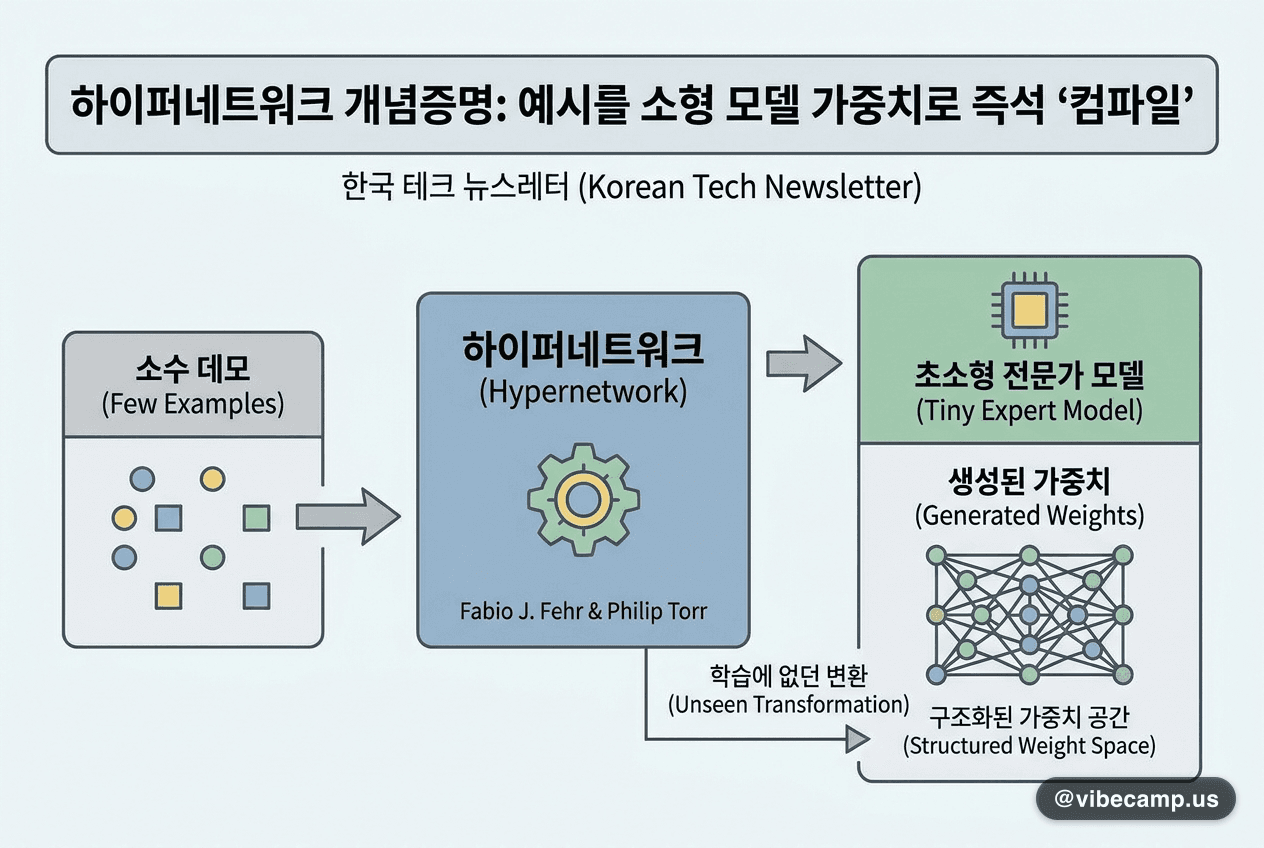
예시 몇 개를 소형 모델 가중치로 즉석 '컴파일' — 하이퍼네트워크 개념증명

예시 몇 개를 소형 모델 가중치로 즉석 '컴파일' — 하이퍼네트워크 개념증명

#
범용 모델은 문맥만으로 적응하지만 무겁고, 가볍게 돌아가는 전문 모델은 태스크마다 따로 학습해야 합니다. Fabio J. Fehr와 Philip Torr는 소수 데모를 입력받은 하이퍼네트워크(hypernetwork)가 초소형 전문가 모델의 파라미터를 직접 생성하는 방식을 ARC-1D에서 시험했습니다. 생성된 가중치 공간은 구조화돼 있었고 학습에 없던 변환에도 부분적으로 일반화했으며, 명시적 태스크 ID를 빼자 일반화가 오히려 좋아졌습니다. 아직 개념증명 단계입니다.
💡학습 없이 예시만으로 가벼운 전용 모델을 만든다는 방향의 초기 근거입니다. NeurIPS 2026 워크숍 Spotlight로, 저비용·엣지 배포를 고민한다면 지켜볼 만합니다.
원문 →#hypernetwork#few-shot#weight-generation#arc#proof-of-concept
📚

커리큘럼 학습

예제 60% 덜 쓰고 학습 시간 절반 — 학생 실력 따라 바뀌는 증류 커리큘럼

예제 60% 덜 쓰고 학습 시간 절반 — 학생 실력 따라 바뀌는 증류 커리큘럼

#
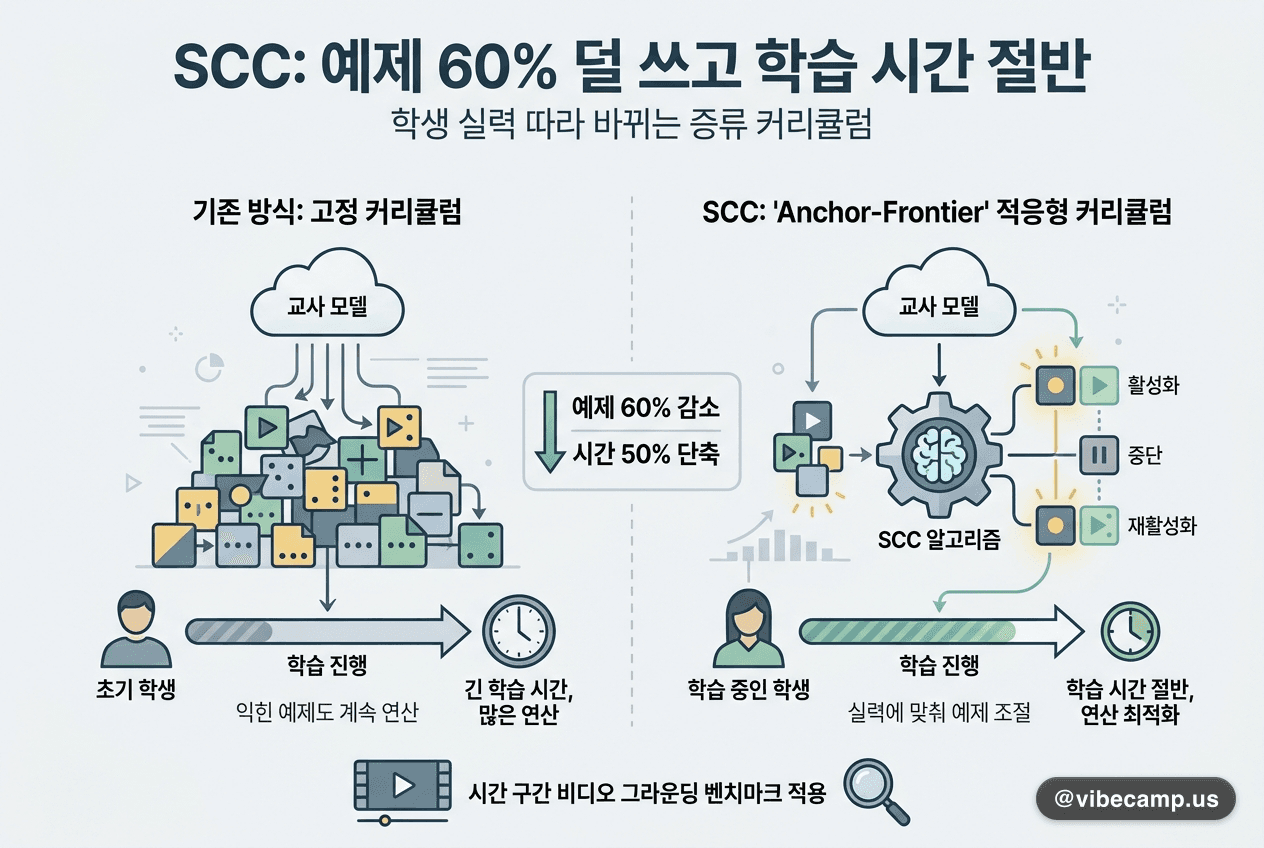
비전-언어 모델(VLM)의 온폴리시 증류(on-policy distillation)는 고정된 교사와 초기 학생 상태로 커리큘럼을 한 번 짜고 끝내, 익힌 예제에도 교사 연산을 계속 씁니다. SCC는 'Anchor-Frontier' 커리큘럼을 후보 공간으로 두고, 학습 중인 학생의 실력에 따라 예제를 활성화·중단·재활성화합니다. 시간 구간 비디오 그라운딩 벤치마크 3종에서 Video-OPD 대비 평균 recall이 5.1% 상대 개선됐고, 학습 예제는 60.0%, 학습 시간은 50.4% 줄었습니다.
💡증류·파인튜닝 데이터를 처음에 고정하지 말고 학생 모델 상태를 보며 넣고 빼는 것만으로도 학습 비용을 크게 줄일 수 있다는 실험 근거입니다. 교사 호출 비용이 큰 팀일수록 효과가 큽니다.
원문 →#curriculum-learning#distillation#vlm#video-grounding#data-efficiency
replay 비율 튜닝 없이 — 망각을 보고 복습량을 정하는 RoD

replay 비율 튜닝 없이 — 망각을 보고 복습량을 정하는 RoD

#
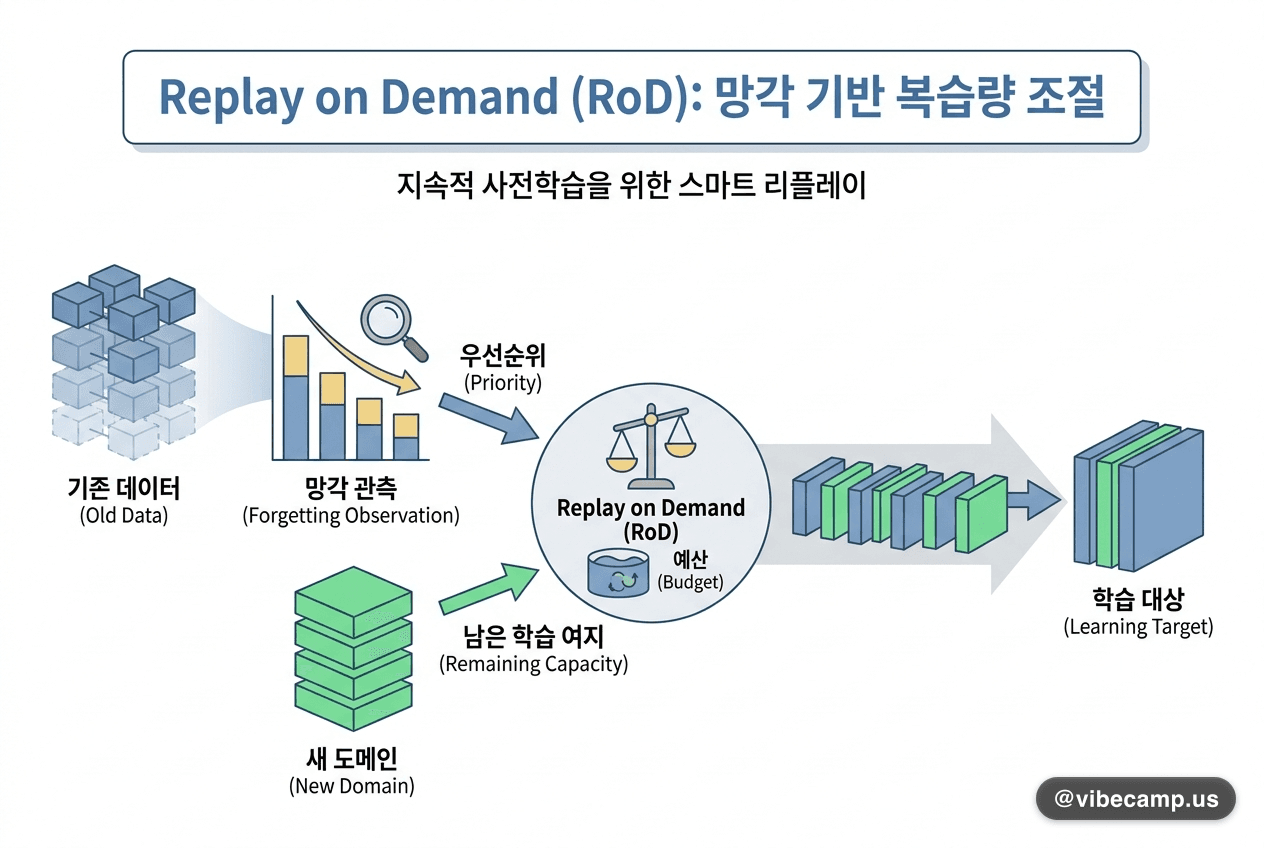
새 도메인으로 계속 사전학습(continued pretraining)하면 기존 능력을 잊는데, 고정 비율 replay는 실제 망각과 무관하게 예산을 씁니다. Replay on Demand(RoD)는 새 도메인 샘플은 남은 학습 여지로, 옛 데이터는 관측된 망각 정도로 우선순위를 매겨 하나의 예산을 두고 경쟁시킵니다. 그 결과 매 스텝 학습 대상을 정하는 커리큘럼이 저절로 생깁니다. 여러 모델·규모·도메인에서 튜닝된 고정 replay와 모델 병합의 적응-망각 균형에 도달하거나 넘어섰습니다.
💡도메인 특화 추가학습에서 replay 비율을 맞추느라 반복하던 실험을 줄일 수 있는 접근입니다. 다만 초록에 구체 수치는 없어 본문 확인이 필요합니다.
원문 →#continued-pretraining#replay#catastrophic-forgetting#curriculum-learning#llm
🪞

자가수정 학습

단일 롤아웃 대비 +6.4점 — 다수결이 숨긴 오류를 찾는 에이전트 검증자

단일 롤아웃 대비 +6.4점 — 다수결이 숨긴 오류를 찾는 에이전트 검증자

#
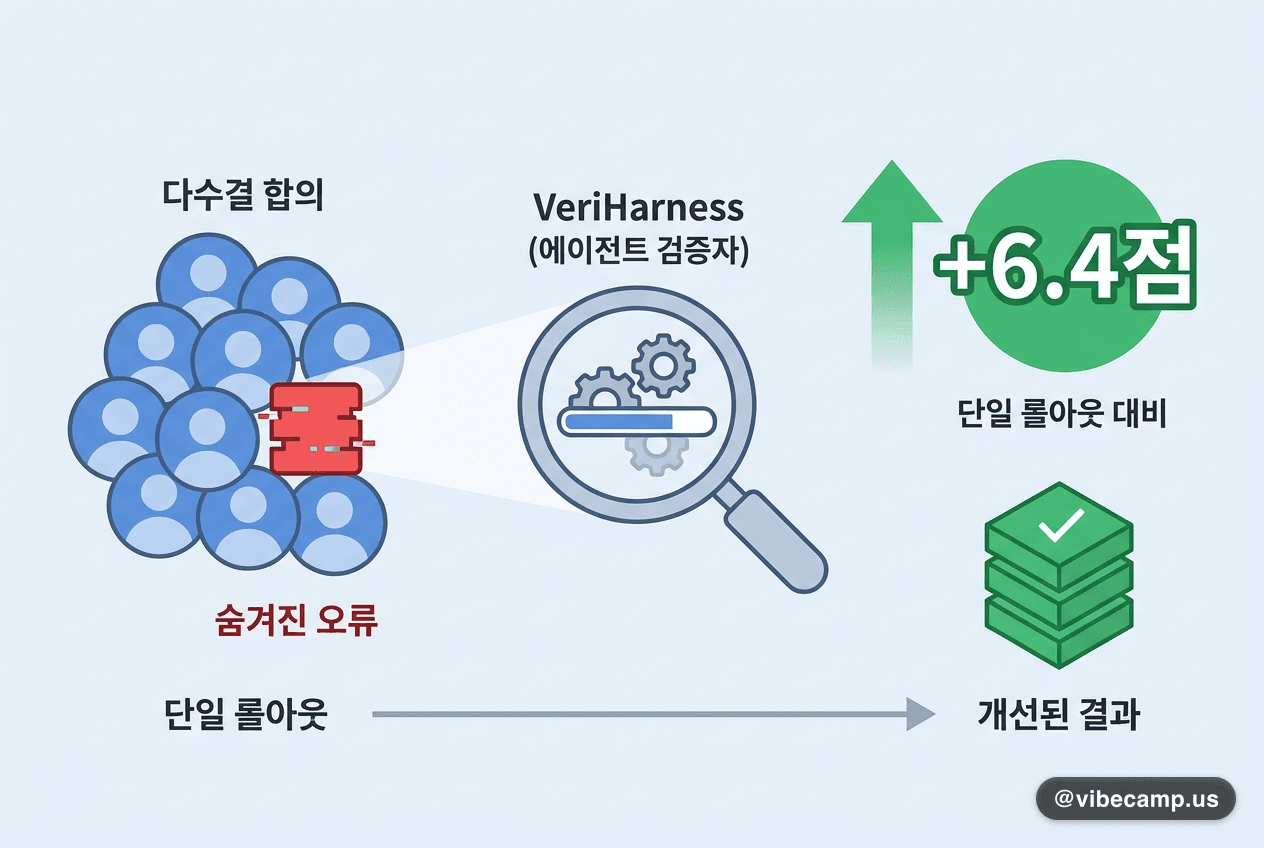
정답이나 채점 기준이 없는 장기 에이전트 작업은 검증이 어렵고, 다수결 합의가 오히려 오류를 숨기기도 합니다. VeriHarness는 생성에 쓴 같은 LLM에 작업공간·증거 도구·재사용 가능한 검증 스킬을 줘 에이전트형 검증자로 바꾸고, 롤아웃 간 불일치와 합의를 점검해 산출물을 고르고 고칩니다. 5개 장기 벤치마크에서 단일 롤아웃 대비 Gemini 3.5 Flash +6.2점, Claude Opus 4.8 +6.4점을 얻었고, 검증 스킬은 실패 피드백으로 스스로 개선됐습니다.
💡에이전트 결과를 다수결로만 고르고 있다면, 의견이 갈리거나 쉽게 합의된 지점을 증거로 다시 확인하는 검증 단계를 넣어 볼 만합니다. 같은 모델로도 가능합니다.
원문 →#self-verification#agent#long-horizon#llm-as-verifier#self-correction
모델은 그대로, 하네스만 고쳐 +12.33점 — 스스로 진화하는 GUI 에이전트

모델은 그대로, 하네스만 고쳐 +12.33점 — 스스로 진화하는 GUI 에이전트

#
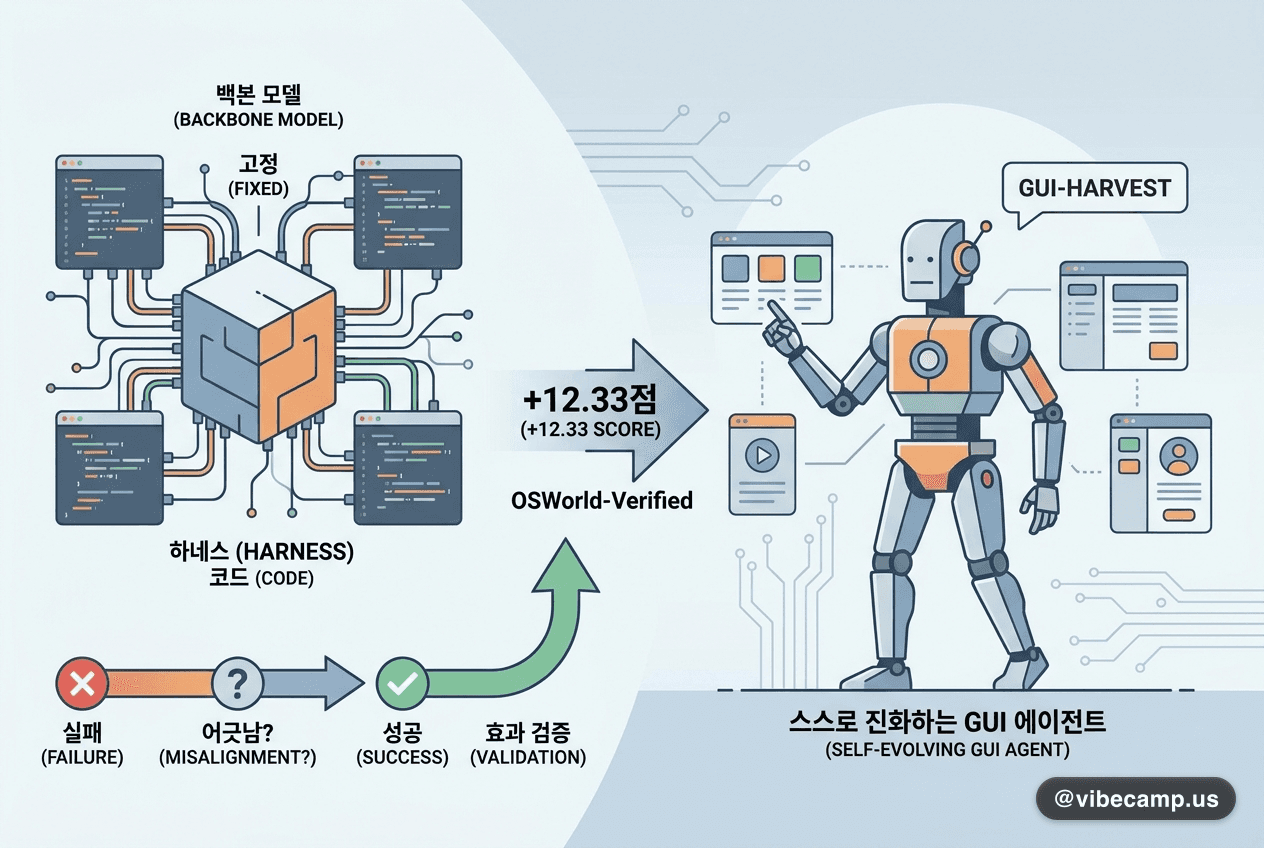
GUI 에이전트는 의도와 실제 화면 변화가 어긋나고 실행마다 결과가 달라 실패 진단이 어렵습니다. GUI-HARVEST는 백본 모델을 고정한 채 반복되는 실패 패턴을 모아 하네스(harness) 코드를 제한적으로 고치고 반복 실행으로 효과를 검증합니다. OSWorld-Verified에서 6개 백본 모두 성능이 올랐고 Qwen3-VL-32B-Instruct는 +12.33점을 얻었습니다. 이 하네스를 그대로 옮기자 GPT-5도 WindowsAgentArena에서 +13.87%p 향상됐습니다.
💡모델 교체나 파인튜닝 없이 에이전트를 감싼 코드만 고쳐도 성능이 크게 오를 수 있다는 사례입니다. 자체 에이전트를 운영한다면 실패 로그부터 모아 보세요.
원문 →#gui-agent#harness#self-improvement#osworld#computer-use
🧪

액티브러닝

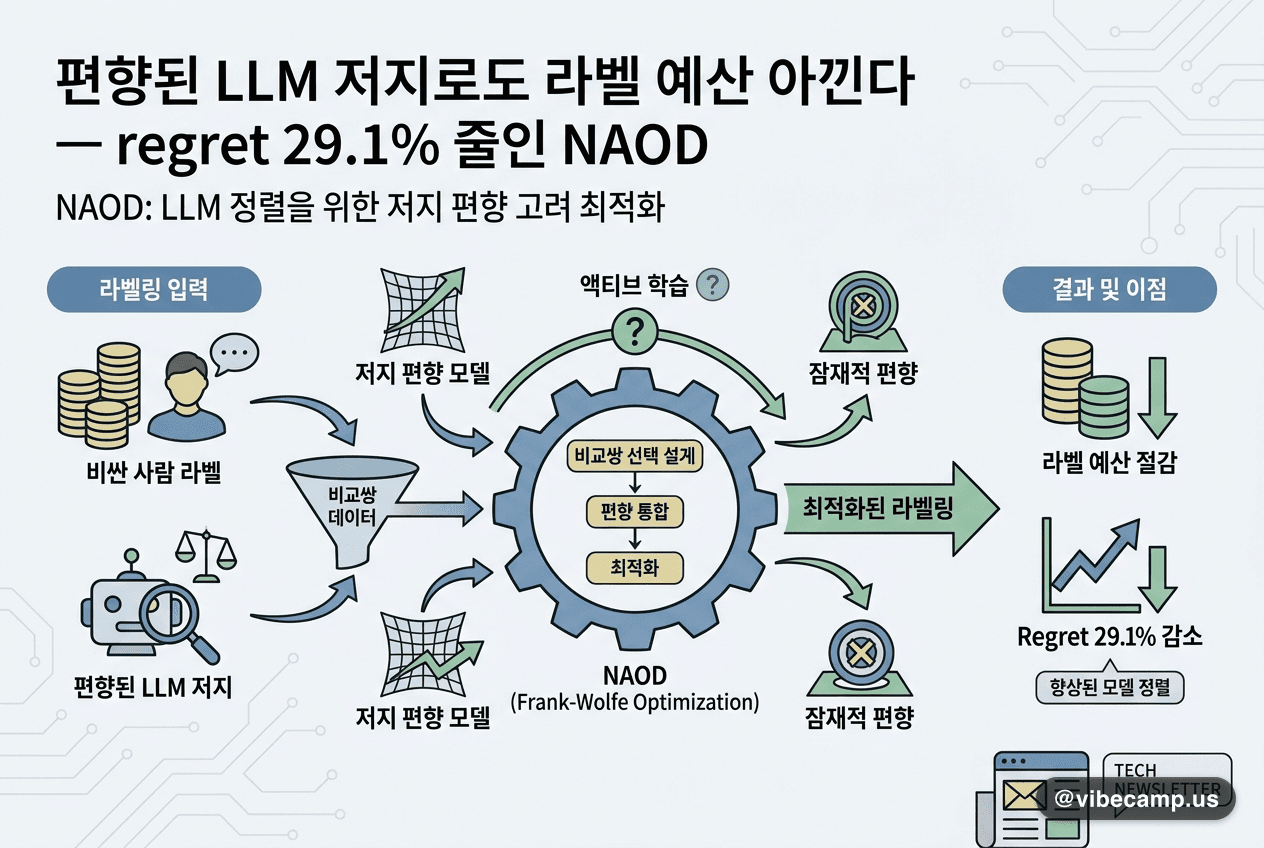
편향된 LLM 저지로도 라벨 예산 아낀다 — regret 29.1% 줄인 NAOD

편향된 LLM 저지로도 라벨 예산 아낀다 — regret 29.1% 줄인 NAOD

#
LLM 정렬용 선호 데이터는 사람 라벨이 비싸 LLM 저지(LLM judge)를 섞어 쓰지만, 저지 선호는 사람과 어긋날 수 있습니다. 액티브 학습이 비교 분포를 바꾸면 사전 보정으로 못 잡은 편향이 드러나, 정보량 커 보이는 비교가 실은 편향일 수 있습니다. NAOD는 저지 편향을 라벨링할 비교쌍 선택 설계 안에 직접 넣고 Frank-Wolfe로 최적화합니다. Chatbot Arena 데이터(저지 17개, 예산 설정 15개)에서 기존 설계 대비 프록시 정책 평균 regret을 29.1% 줄였습니다.
💡RLHF·DPO용 선호 데이터를 사람과 LLM 저지로 함께 모은다면, 어떤 비교를 사람에게 맡길지 고르는 단계에서 저지 편향까지 따져야 한다는 시사점입니다.
원문 →#active-learning#preference-learning#llm-judge#rlhf#alignment
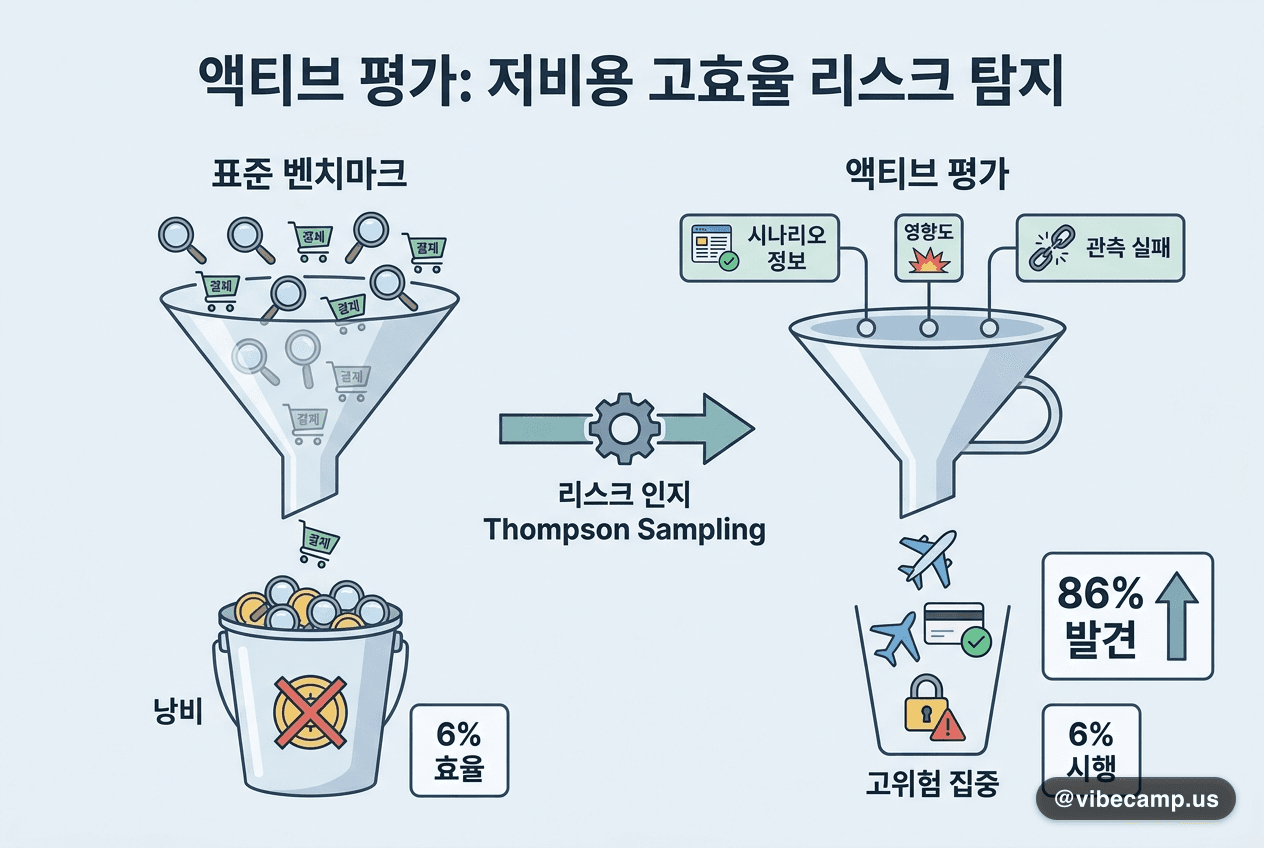
시행 6%로 고위험 실패 86% 찾았다 — 에이전트 '액티브 평가' 기법

시행 6%로 고위험 실패 86% 찾았다 — 에이전트 '액티브 평가' 기법

#
학습용 라벨 선택이 아니라, 한정된 평가 예산을 어느 시나리오에 쓸지 고르는 액티브 평가(active evaluation) 기법입니다. 조회와 되돌릴 수 없는 결제를 똑같이 반복하는 표준 벤치마크의 낭비를 겨냥해, 시나리오 정보·영향도·관측 실패를 결합한 리스크 인지 Thompson Sampling으로 돌릴 시나리오를 고릅니다. τ-bench 항공 시나리오 70개에서 6%인 50회 시행만으로 영향가중 실패의 86%를 찾았고(균등 할당 25%), 실패 없는 시나리오에 쓰인 예산은 34→2.8%로 줄었습니다.
💡에이전트 QA 예산이 한정돼 있다면 결제처럼 영향 큰 시나리오에 시행을 몰아줘 치명적 실패를 더 빨리 찾을 수 있습니다. 예산이 커질수록 이점은 줄어듭니다.
원문 →#active-evaluation#agent-evaluation#thompson-sampling#tau-bench#bandit

이 호가 도움됐다면 공유해 주세요 — 빌더 한 명이 더 알게 됩니다.

📤 공유하기𝕏@inf💬✈B✉