본문으로 건너뛰기
← vibecamp ai model 목록

vibecamp ai model · #31 · 2026-10-01

vibecamp ai model 2026-10-01 — 라벨은 '언제' 묻느냐가 관건 — 일부 배치만 라벨링해 최신 성능

2026-10-01 AI 모델 일간 호 — 오늘 8개 카드를 정리했습니다.

8개 카드 · 적은 예제로 스스로 깨우치는 학습법 일간

📤 공유하기𝕏@inf💬✈B✉
🎯

퓨샷 학습

학습 없이 표 데이터 예측 — 400M 모델이 51개 데이터셋 1위

학습 없이 표 데이터 예측 — 400M 모델이 51개 데이터셋 1위

#
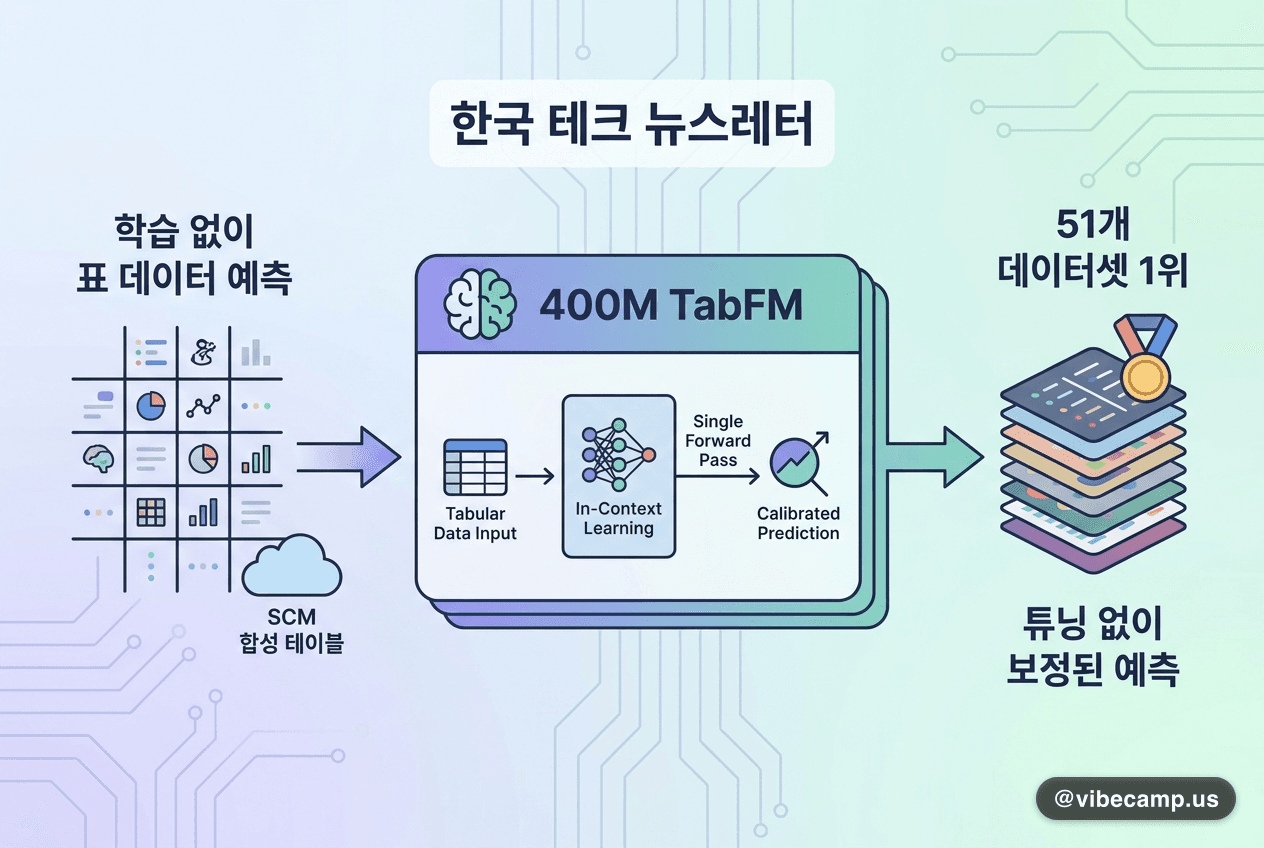
표(tabular) 데이터 ML은 데이터셋마다 트리 앙상블이나 AutoML 탐색을 처음부터 반복해야 했습니다. TabFM은 지도학습 표 예측을 in-context learning 문제로 재정의한 400M 파라미터 파운데이션 모델로, 구조적 인과모델(SCM)로 만든 합성 테이블만으로 학습해 튜닝 없이 단일 forward pass로 보정된 예측을 냅니다. TabArena 51개 데이터셋(분류 38·회귀 13) 전체에서 기본 설정 표 파운데이션 모델 중 1위를 기록했고, 튜닝된 AutoML 파이프라인도 앞섰습니다.
💡예시 행을 컨텍스트로 넣기만 하면 예측이 나오는 구조라, 적은 예제로 빠르게 베이스라인을 세워야 하는 사내 데이터 분석에 쓸모가 큽니다. 합성 데이터만으로 학습했다는 점도 주목할 만합니다.
원문 →#in-context-learning#tabular#foundation-model#zero-shot#automl
📚

커리큘럼 학습

롤아웃 최대 57% 줄이고 정확도는 올렸다 — GRPO용 커리큘럼 ARCUS

롤아웃 최대 57% 줄이고 정확도는 올렸다 — GRPO용 커리큘럼 ARCUS

#
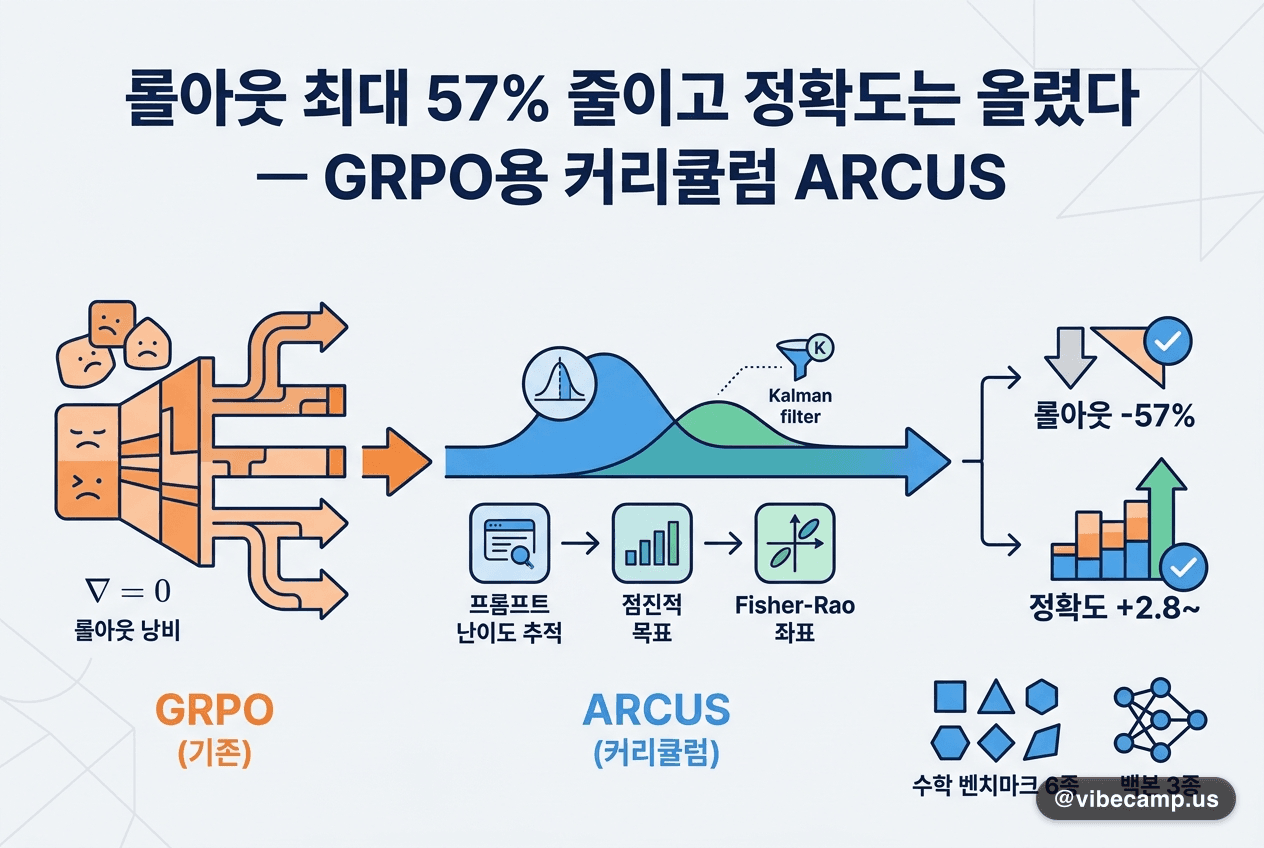
GRPO는 그룹 응답이 전부 맞거나 전부 틀리면 그래디언트가 0이라 롤아웃이 낭비됩니다. ARCUS는 통과율을 Fisher-Rao 아크 길이 좌표로 옮겨 프롬프트 커리큘럼을 가우시안으로 정의하고, 프롬프트별 칼만 필터(Kalman filter)로 난이도를 추적하며 목표 난이도를 점진적으로 올립니다. 수학 벤치마크 6종·백본 3종에서 GRPO 대비 +2.8~2.9포인트, dynamic sampling 대비 +1.1~1.2포인트 정확도를 얻었고 롤아웃은 dynamic sampling보다 48~57% 적게 썼습니다.
💡추론 모델 RL에서 비용의 대부분은 롤아웃입니다. '지금 모델에 맞는 난이도의 문제만 고른다'는 커리큘럼 원리로 학습비를 절반 가까이 줄일 수 있다는 점은 소규모 팀에게 특히 반가운 결과입니다.
원문 →#curriculum-learning#grpo#reinforcement-learning#reasoning#rollout-efficiency
로봇 정강이 충돌 63% 감소 — 위험을 예측해 배분하는 안전 커리큘럼

로봇 정강이 충돌 63% 감소 — 위험을 예측해 배분하는 안전 커리큘럼

#
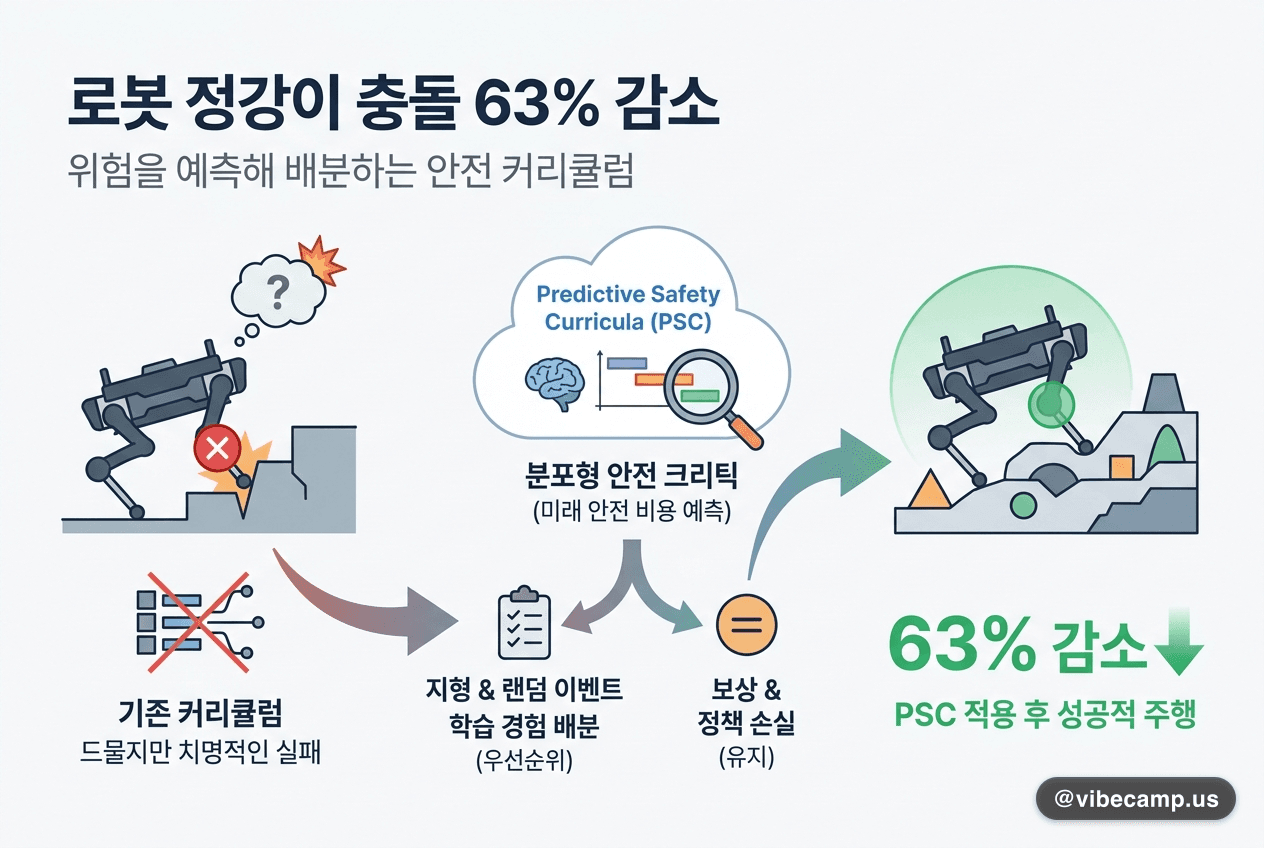
보행 로봇 RL의 기존 커리큘럼은 난이도만 조절해 드물지만 치명적인 실패가 남습니다. Predictive Safety Curricula(PSC)는 분포형 안전 크리틱(distributional safety critic)이 예측한 미래 안전 비용을 기준으로 지형과 랜덤 이벤트 학습 경험을 우선 배분하며, 보상과 정책 손실은 그대로 둡니다. ANYmal-D 실기에서 learning-progress 커리큘럼 대비 정강이 충돌이 63% 줄었고(3개 시드 모두), 양산 계단 오르기 플랫폼에서는 관측된 충돌이 0건이었습니다.
💡커리큘럼을 '쉬운 것에서 어려운 것으로'만 볼 게 아니라 '위험한 경험을 더 자주'로 설계할 수 있다는 사례입니다. 보상 함수를 건드리지 않아 기존 학습 파이프라인에 얹기 쉽습니다.
원문 →#curriculum-learning#robotics#legged-locomotion#safe-rl
🪞

자가수정 학습

교훈 없이도 정답률 0~1%→12~13% — 실패마다 한 줄 교훈을 쓰며 배우는 RL

교훈 없이도 정답률 0~1%→12~13% — 실패마다 한 줄 교훈을 쓰며 배우는 RL

#
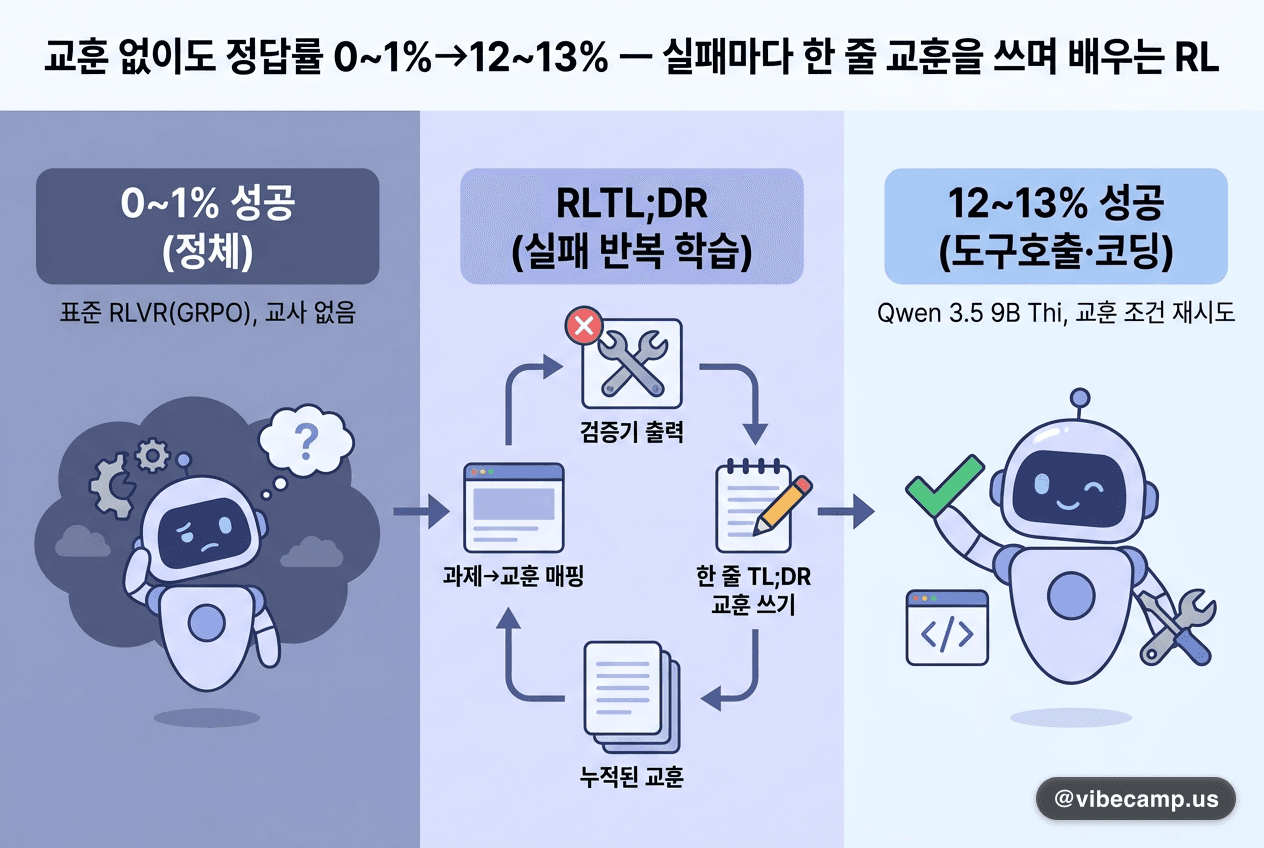
성공 사례가 거의 없고 교사 모델도 없으면 표준 RLVR(GRPO)은 학습 신호가 사라져 정체됩니다. RLTL;DR은 실패할 때마다 검증기 출력을 보여주고 모델이 직접 한 줄 TL;DR 교훈을 쓰게 한 뒤, 누적된 교훈을 조건으로 다시 시도하며 '과제→교훈' 매핑을 내재화합니다. 128번 시도해도 못 풀던 도구호출·코딩 과제에서 Qwen 3.5 9B Thinking의 GRPO는 정답률 0~1%에 머물렀지만, RLTL;DR은 학습 중 14~31%, 교훈 없이 평가해도 12~13%를 기록했습니다.
💡(과제, 교훈) 4천 쌍만으로 SFT해도 성능 대부분이 돌아왔다는 점이 핵심입니다. 실패에서 말로 된 교훈을 뽑아 쌓는 방식은 에이전트의 회고 루프 설계에도 응용할 수 있습니다.
원문 →#self-improvement#self-correction#rlvr#reinforcement-learning#qwen
다시 고치면 25.5%포인트 오르지만 맞던 답 19.1%는 뒤집힌다

다시 고치면 25.5%포인트 오르지만 맞던 답 19.1%는 뒤집힌다

#
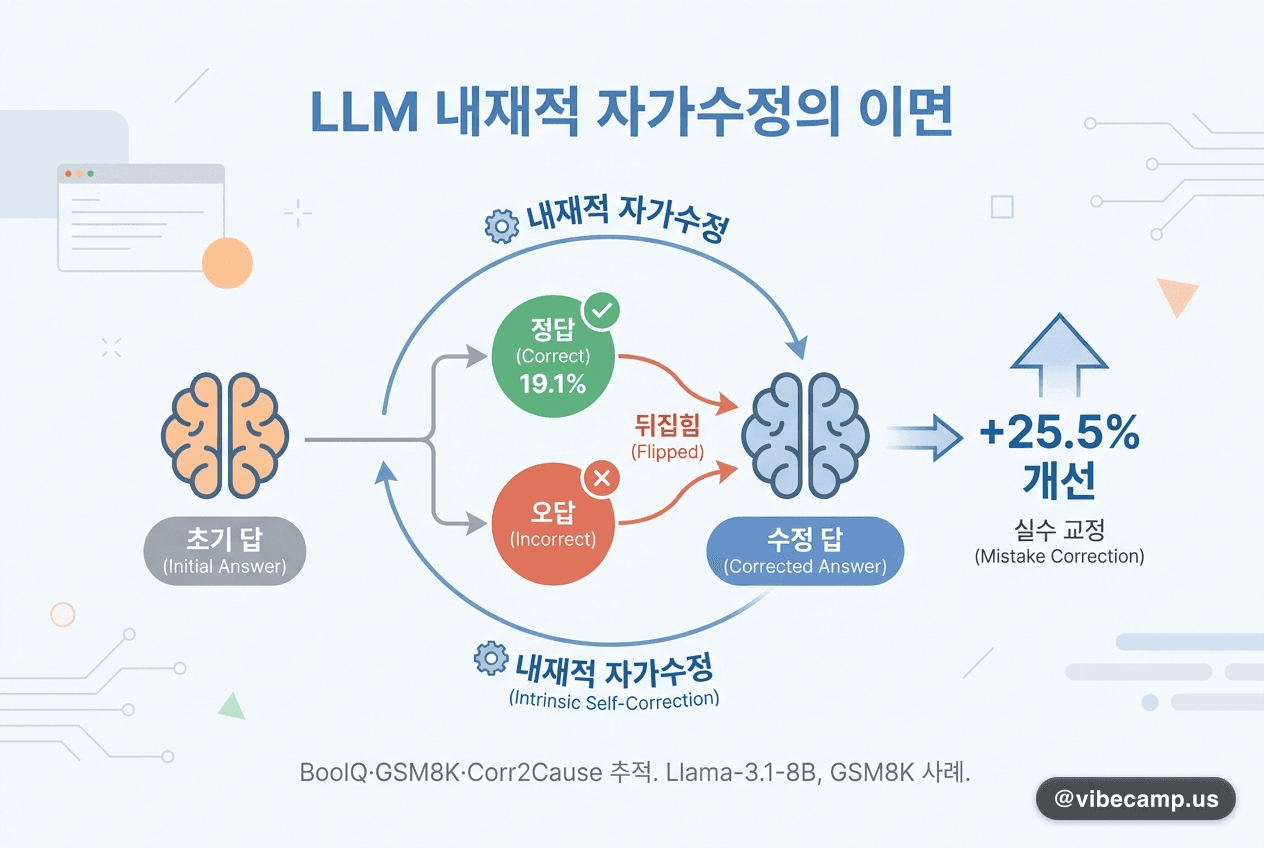
외부 증거 없이 자기 답을 다시 고치는 내재적 자가수정(intrinsic self-correction)은 실수를 바로잡지만 맞은 답을 뒤집기도 합니다. 이 연구는 오픈웨이트 LLM 29종을 BoolQ·GSM8K·Corr2Cause에서 초기 답과 수정 답의 정오 전이로 추적했습니다. Llama-3.1-8B는 GSM8K에서 25.5%포인트 개선됐지만 원래 정답의 19.1%를 오답으로 바꿨습니다. 초기 답 유지·항상 수정·선택적 수정(gating) 세 정책을 비교해 학습된 게이팅이 유리한 경우도 구분했습니다.
💡'한 번 더 검토해 줘' 프롬프트가 항상 이득은 아닙니다. 자가수정을 쓸 때는 평균 정확도와 함께 맞던 답을 몇 개 잃었는지 따로 측정해 보는 습관이 필요합니다.
원문 →#self-correction#llm-evaluation#reasoning#open-weights
🧪

액티브러닝

라벨은 '언제' 묻느냐가 관건 — 일부 배치만 라벨링해 최신 성능

라벨은 '언제' 묻느냐가 관건 — 일부 배치만 라벨링해 최신 성능

#
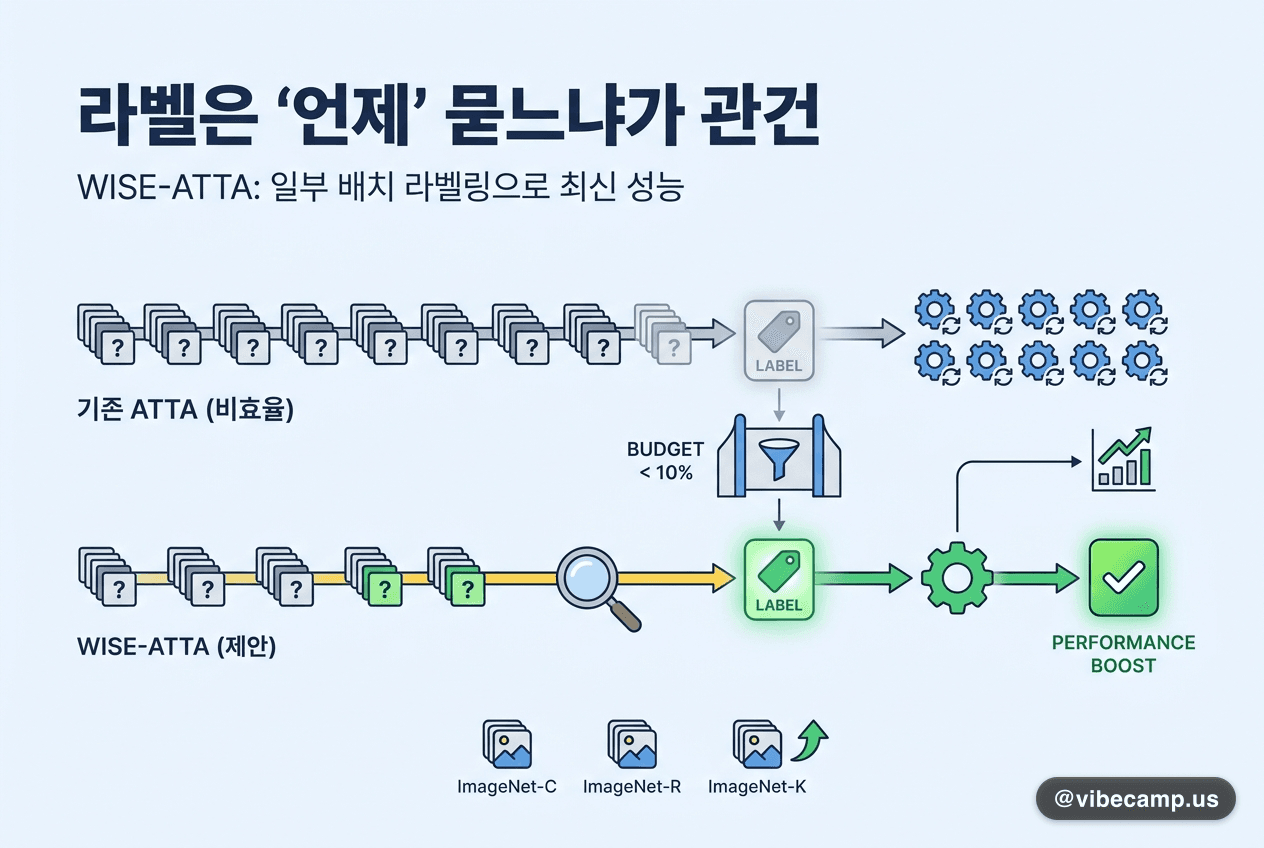
배포 중 분포 이동에 맞춰 모델을 고치는 액티브 테스트타임 적응(ATTA)은 그동안 모든 테스트 배치에 라벨을 요청할 수 있다고 가정해 왔습니다. WISE-ATTA는 일부 배치에만 라벨을 허용하는 예산형 설정에서, 온라인 경량 신호로 감독이 가장 유용한 시점을 고르고 아직 적응이 수렴하지 않은 샘플 1개만 라벨링해 업데이트합니다. ImageNet-C·R/K/A에서 최신 ATTA와 같거나 더 나은 성능을 훨씬 적은 라벨로 냈고 코드도 공개됐습니다.
💡라벨링 예산이 빠듯한 현업이라면 '어떤 데이터에 라벨을 붙일까'와 함께 '언제 사람에게 물을까'를 설계 변수로 두는 관점이 유용합니다. 배포 후 모니터링 파이프라인에 적용해 볼 만합니다.
원문 →#active-learning#test-time-adaptation#label-efficiency#arxiv
🔄

지속학습

재학습 없이 LLM 지식을 계속 고친다 — 선호 최적화로 망각 억제

재학습 없이 LLM 지식을 계속 고친다 — 선호 최적화로 망각 억제

#
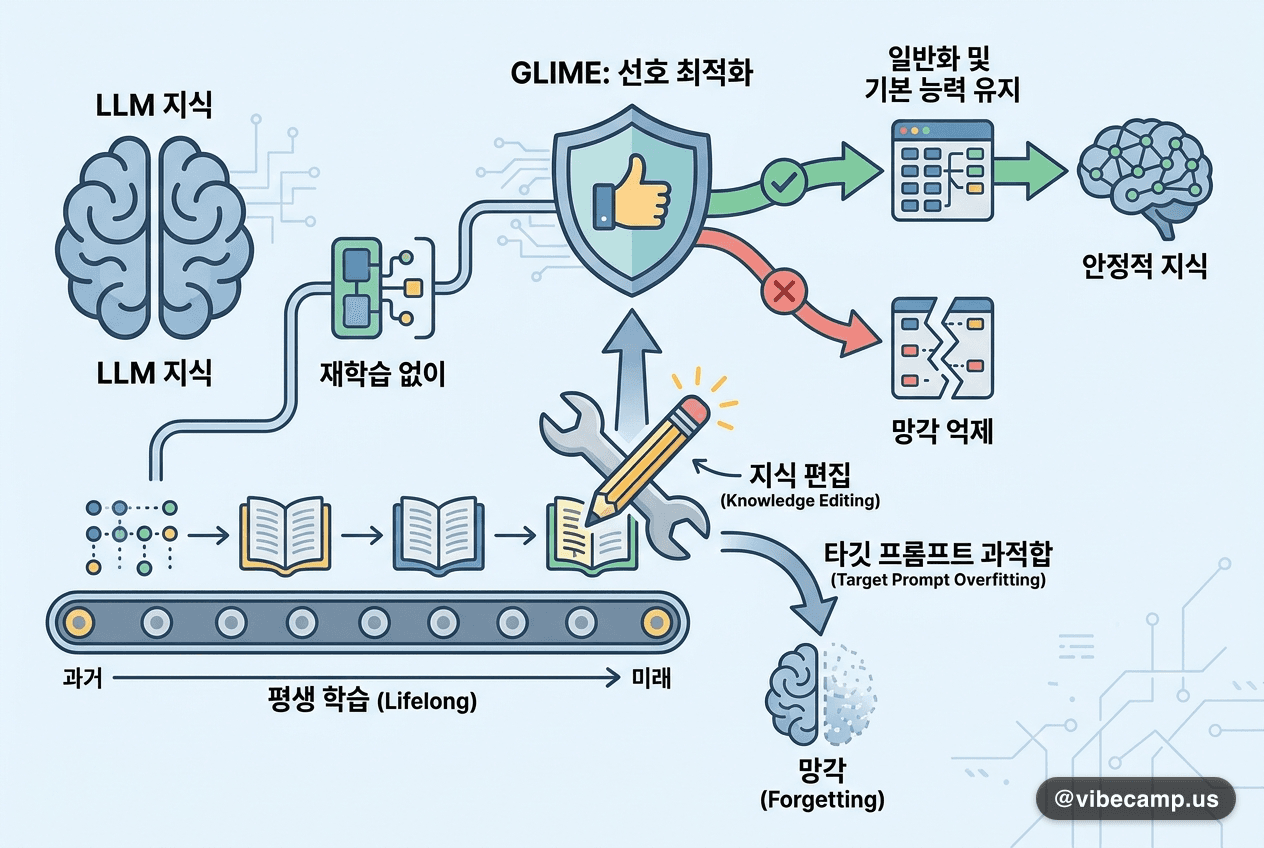
지식 편집(knowledge editing)은 재학습 없이 LLM의 사실을 갱신하지만, 편집이 연속으로 쌓이는 평생(lifelong) 환경에서는 타깃 프롬프트에 과적합해 일반화와 기본 능력이 무너지기 쉽습니다. EMNLP 2026 Main에 채택된 GLIME은 지식 편집에 생성 행동에 대한 선호 최적화(preference optimization)를 결합하고, replay 기반 편집과 그래디언트 제약으로 앞선 편집 내용을 보존합니다. 편집 성능과 일반 능력을 유지하면서 지식 일반화를 크게 개선했다고 밝혔습니다.
💡서비스 중인 모델의 사실 정보를 매번 파인튜닝하기 어렵다면, 편집을 '한 번의 수정'이 아닌 지속학습 문제로 보는 이 접근이 참고가 됩니다. 정량 수치는 원문에서 직접 확인해 보세요.
원문 →#continual-learning#model-editing#preference-optimization#llm#emnlp
🧬

메타러닝

재학습 없이 물리 변화에 즉석 적응 — 예측 오차로 배우는 로봇 정책

재학습 없이 물리 변화에 즉석 적응 — 예측 오차로 배우는 로봇 정책

#
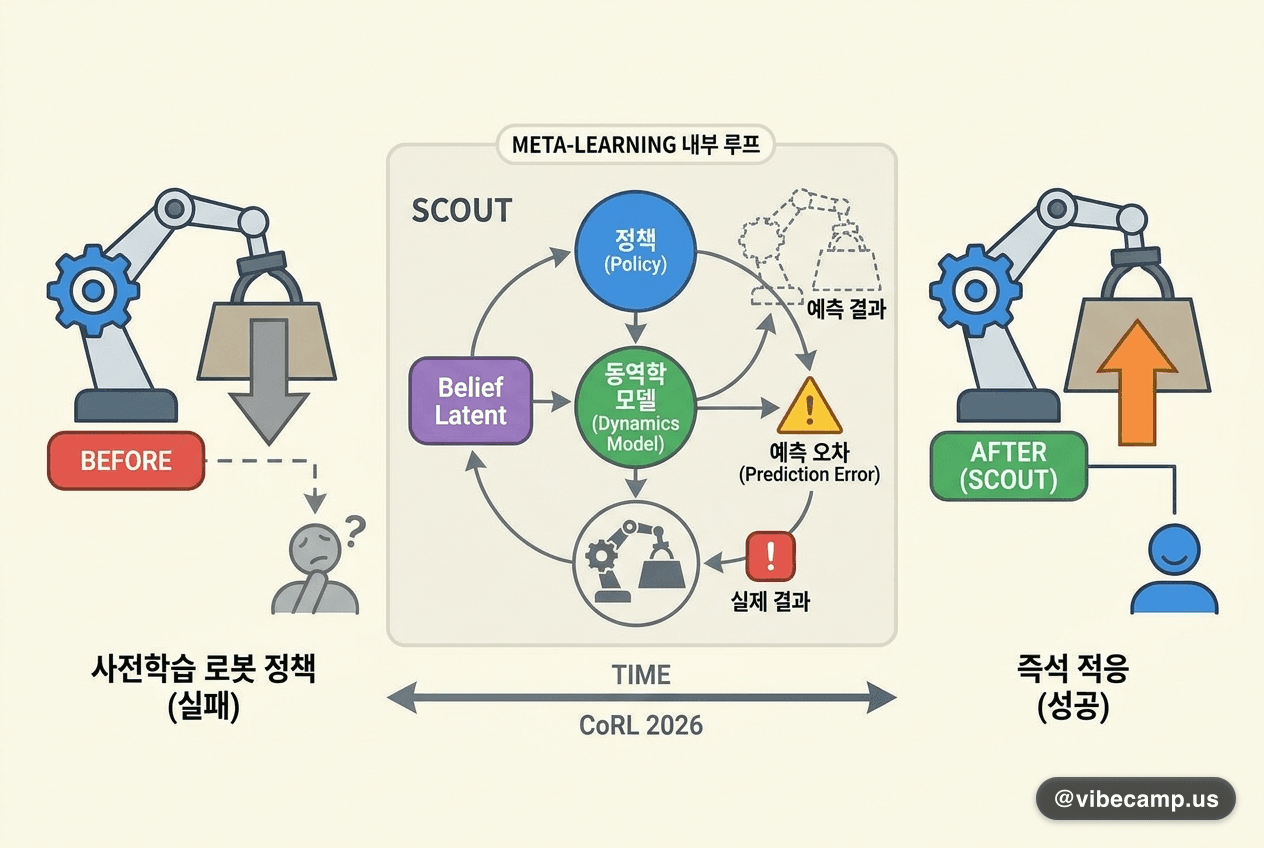
사전학습 로봇 정책은 무게중심이나 마찰처럼 보이지 않는 물리 특성이 바뀌면 실패하기 쉽고, 기존 테스트타임 적응은 희소한 보상에만 의존했습니다. CoRL 2026에 채택된 SCOUT는 행동 정책과 순방향 동역학 모델이 하나의 belief latent를 공유하게 하고, 메타러닝 내부 루프에서 '예측한 결과와 실제 결과의 차이'로 latent를 갱신합니다. 배치 중 파라미터를 다시 학습하지 않아 파국적 망각이 없고, 시뮬레이션 조작 벤치마크에서 온라인 적응을 크게 앞당겼으며 실제 로봇 전이도 시연했습니다.
💡보상 하나보다 '예상과 달랐던 순간'이 훨씬 풍부한 학습 신호라는 점을 보여줍니다. 예외 상황에서 스스로 깨우치는 학습 루프를 설계할 때 참고하기 좋은 구조입니다.
원문 →#meta-learning#robotics#test-time-adaptation#sim-to-real#corl

이 호가 도움됐다면 공유해 주세요 — 빌더 한 명이 더 알게 됩니다.

📤 공유하기𝕏@inf💬✈B✉
vibecamp ai model 2026-10-01 — 라벨은 '언제' 묻느냐가 관건 — 일부 배치만 라벨링해 최신 성능 | vibecamp ai model