본문으로 건너뛰기
← vibecamp ai model 목록

vibecamp ai model · #30 · 2026-09-30

vibecamp ai model 2026-09-30 — 라벨 23장으로 전체 지도학습에 근접 — mIoU 1.9포인트 차

2026-09-30 AI 모델 일간 호 — 오늘 8개 카드를 정리했습니다.

8개 카드 · 적은 예제로 스스로 깨우치는 학습법 일간

📤 공유하기𝕏@inf💬✈B✉
🎯

퓨샷 학습

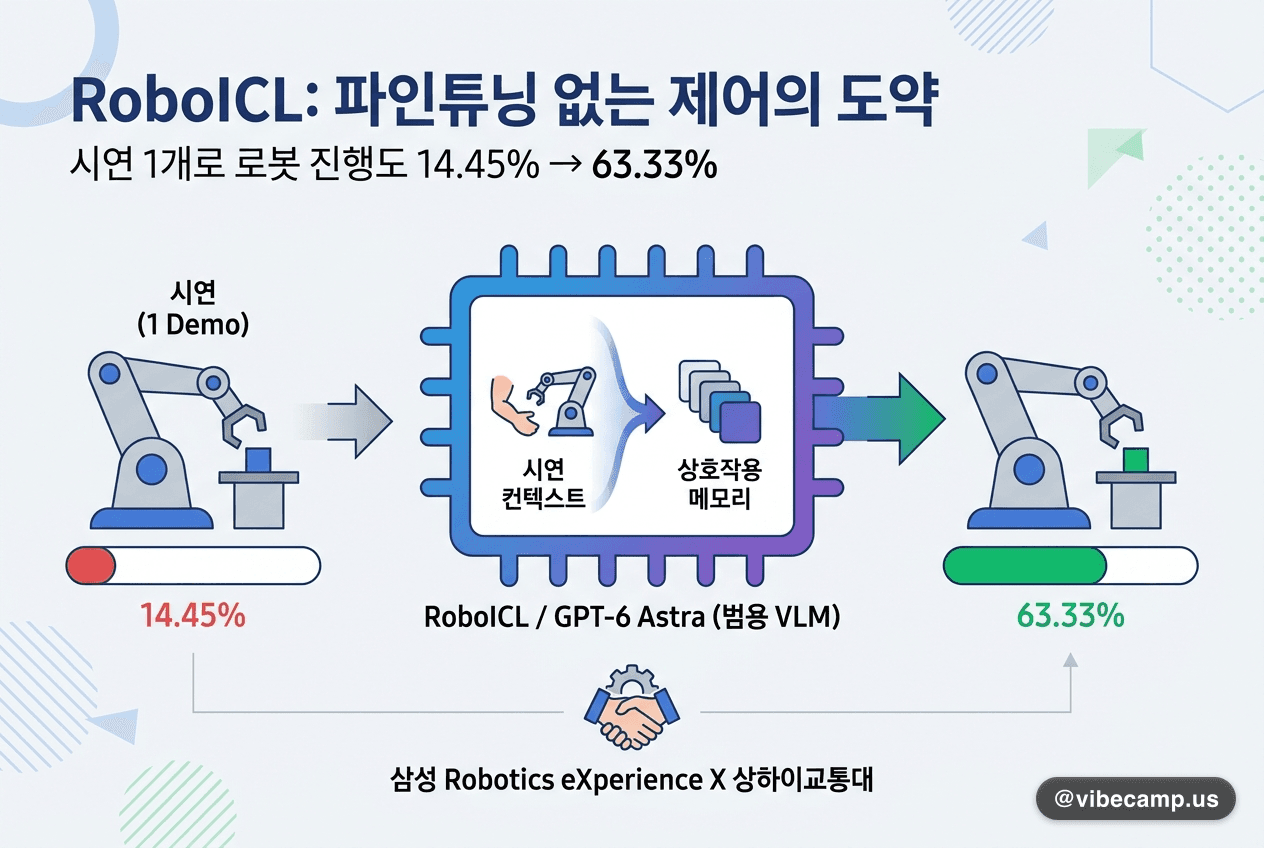
시연 1개로 로봇 진행도 14.45→63.33 — 파인튜닝 없는 제어

시연 1개로 로봇 진행도 14.45→63.33 — 파인튜닝 없는 제어

#
삼성 Robotics eXperience와 상하이교통대 공동 연구진이 9/29 arXiv에 RoboICL을 공개했습니다. 범용 VLM인 GPT-6 Astra에 로봇 전용 파라미터 업데이트 없이 시연(demonstration context)과 자기 행동·결과를 쌓는 상호작용 메모리(interaction memory)를 컨텍스트로 넣어 로봇을 제어합니다. RoboDojo 30개 과제 종합 점수는 50.64로 최강 베이스라인 33.68을 앞섰습니다. 실제 로봇 3개 과제 평균 진행도는 14.45→63.33(원샷)→78.89(3샷)였습니다.
💡로봇마다 VLA를 학습시키기 전에 시연 몇 개를 컨텍스트로 넣어보는 경로가 생겼습니다. 행동 재사용으로 모델 호출을 33~48% 줄인 점도 비용 설계에 참고할 만합니다.
원문 →#few-shot-learning#in-context-learning#robotics#vlm#embodied-ai
📚

커리큘럼 학습

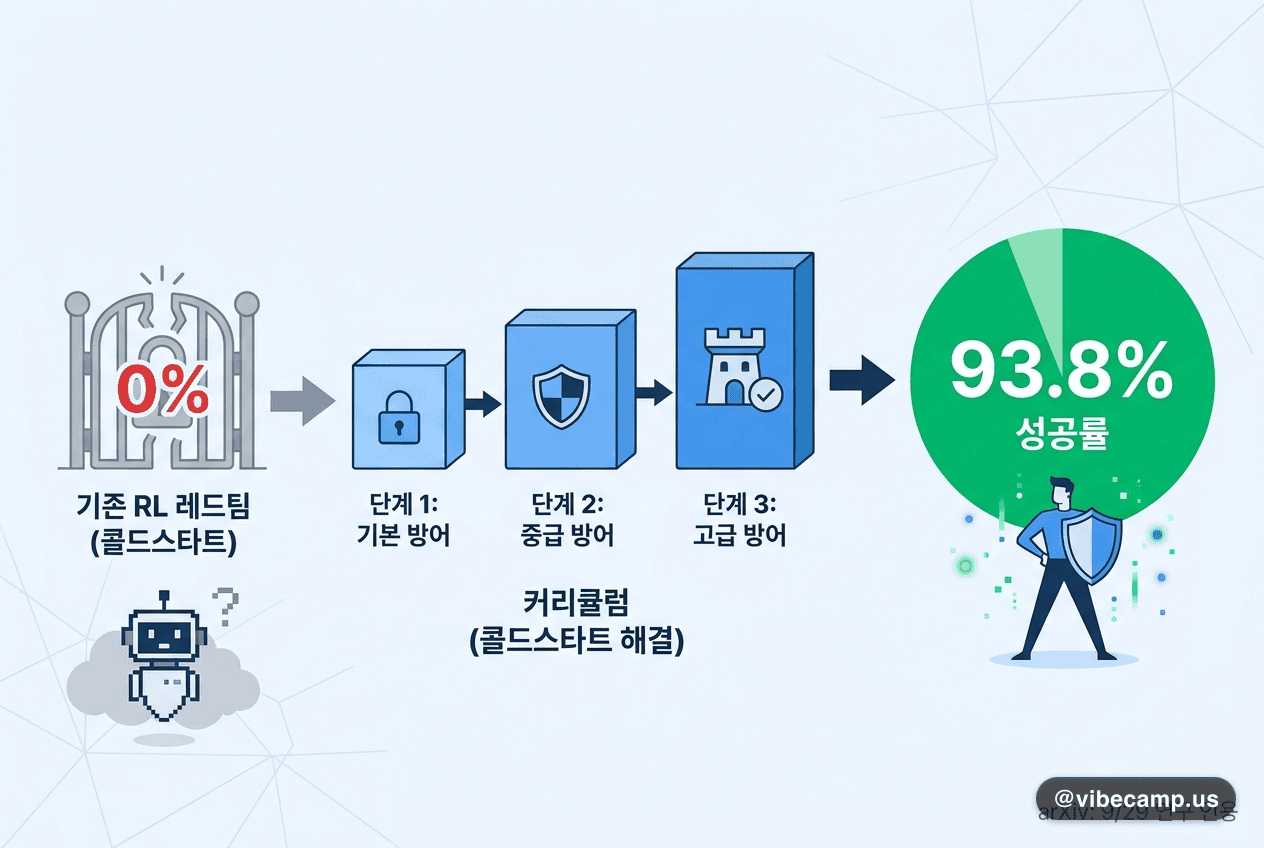
기존 RL 레드팀 0%에서 93.8%로 — 커리큘럼이 콜드스타트를 풉니다

기존 RL 레드팀 0%에서 93.8%로 — 커리큘럼이 콜드스타트를 풉니다

#
9/29 arXiv에 프롬프트 인젝션(prompt injection) 방어 점검용 레드팀(red-teaming) 연구가 나왔습니다. 공격자 LLM을 강화학습으로 훈련할 때 처음부터 프런티어 모델을 겨냥하면 모든 시도가 실패해 보상이 0인 콜드스타트(cold-start) 문제가 생깁니다. 연구진은 점점 견고한 타깃 순서로 단계를 짜, 다음 타깃에 부분적으로라도 성공하도록 커리큘럼을 설계했습니다. AgentDyn에서 10회 시도 공격 성공률은 GPT-5.6-Luna 93.8%, GPT-5.6-Terra 45.0%, 같은 조건의 RL-Hammer·PISmith는 0%였습니다.
💡난도 순서 설계가 보상 신호를 만든다는 점은 레드팀 밖에서도 쓰입니다. 동시에 미학습 프런티어 모델 6종에도 공격이 전이돼, 에이전트 방어 평가를 더 강하게 해야 함을 보여줍니다.
원문 →#curriculum-learning#red-teaming#prompt-injection#reinforcement-learning#ai-safety
🪞

자가수정 학습

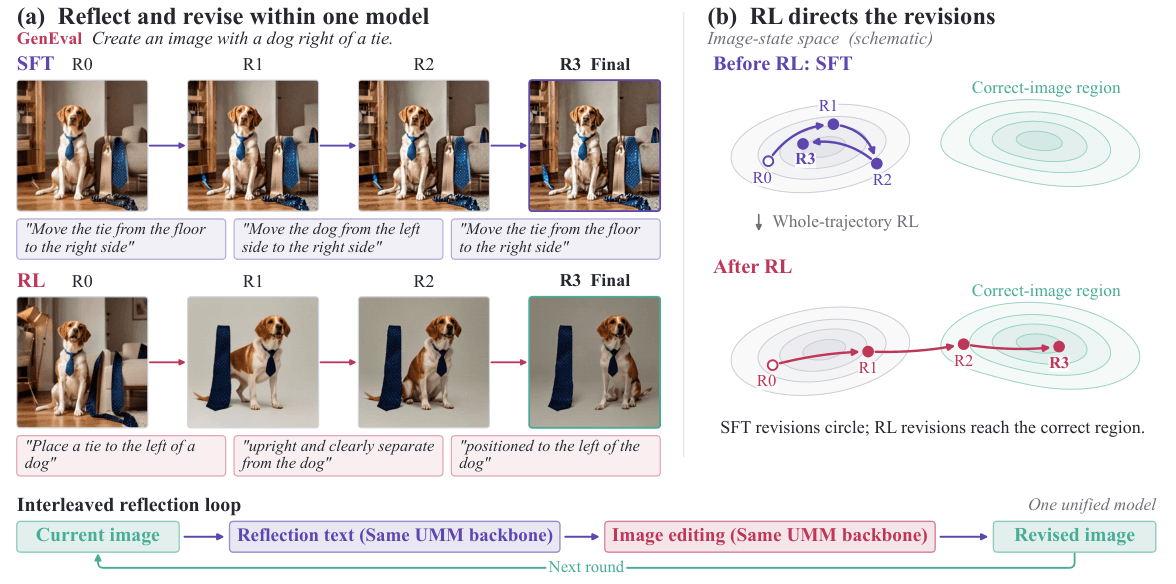
UMM-Reflection 논문 도식 — 하나의 통합 모델이 이미지를 성찰·수정하는 반복 루프와 RL 전후 수정 궤적 비교

그린 뒤 스스로 고치는 루프를 RL로 — GenEval 12.05점 상승

#
통합 멀티모달 모델(unified multimodal model)이 자기 생성 이미지를 진단→수정→재관찰하는 반성(reflection) 루프 전체를 강화학습으로 학습시킨 UMM-Reflection이 9/29 arXiv에 공개됐습니다. SFT만으로는 성공률 높은 수리 경로를 못 찾고, 렌더러만 최적화하는 RL은 이득 대부분을 놓친다는 문제의식입니다. 보상이 여러 라운드와 두 역할 모두로 흐르며 추론 시 외부 검증기가 필요 없습니다. BAGEL에서 GenEval이 SFT 대비 12.05점 올랐습니다.
💡학습에 쓰지 않은 WISE(+10.97)·OneIG-Bench(+3.48)·T2I-CompBench++(+4.63)로도 이득이 옮겨갔습니다. 외부 critic 없이 한 모델이 비평과 수정을 겸하는 설계입니다.
원문 →#self-correction#reflection#multimodal#text-to-image#reinforcement-learning
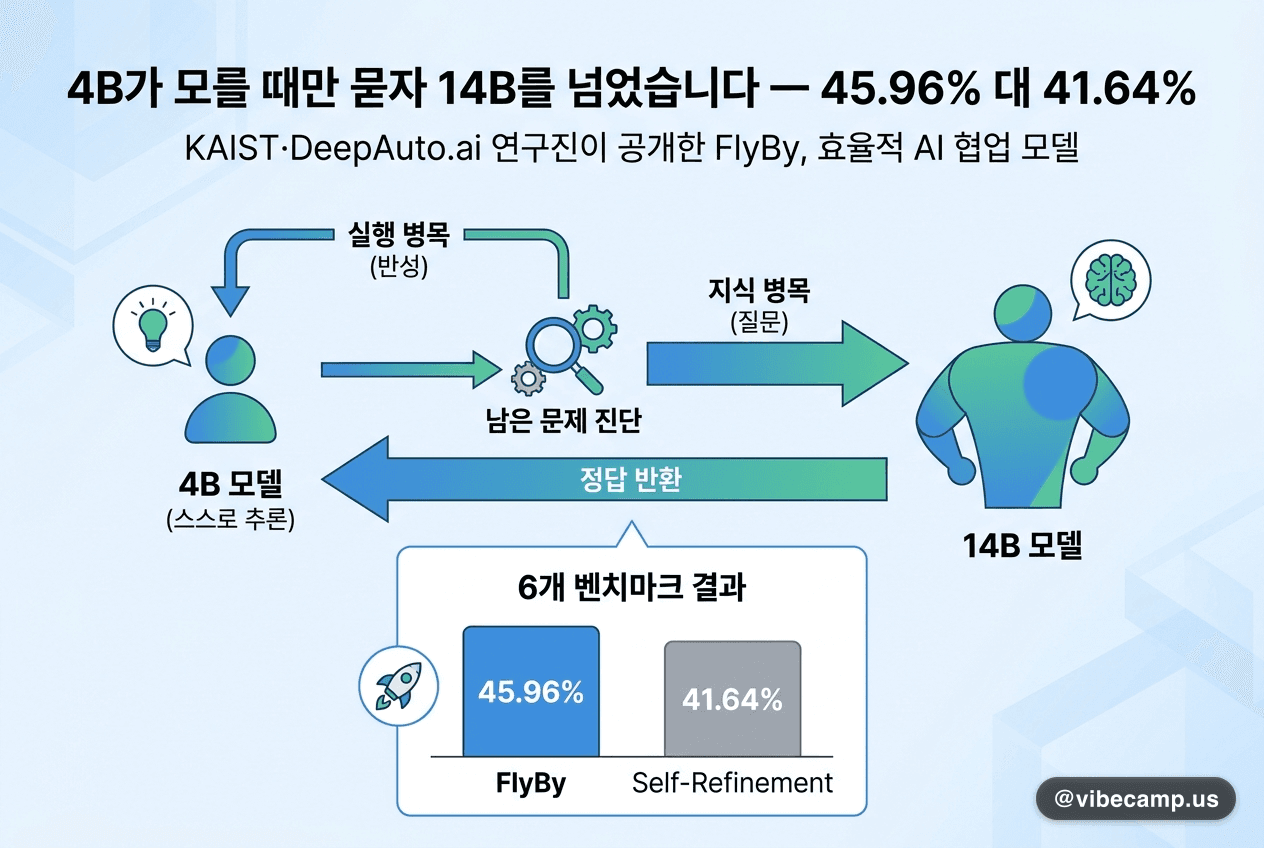
4B가 모를 때만 묻자 14B를 넘었습니다 — 45.96% 대 41.64%

4B가 모를 때만 묻자 14B를 넘었습니다 — 45.96% 대 41.64%

#
KAIST·DeepAuto.ai 연구진이 9/29 arXiv에 FlyBy를 공개했습니다. 개입 실험 결과 자기수정(self-refinement)은 이미 도달 가능한 답에 확률을 모을 뿐 새 답을 열지 못했습니다. FlyBy는 먼저 스스로 추론하고 남은 문제를 진단해, 반성으로 풀 실행 병목이 아닌 지식 병목일 때만 더 큰 모델에 묻습니다. 6개 벤치마크 1,158개 난문에서 FlyBy-4B는 pass@8 45.96%로 Qwen3-14B(41.64%)를 2.7배 낮은 서빙 비용으로 앞섰습니다.
💡'더 오래 생각하기'가 늘 답은 아닙니다. 자기수정으로 풀릴 문제와 지식이 부족한 문제를 구분하는 라우팅이 소형 모델의 비용 대비 성능을 끌어올립니다.
원문 →#self-correction#small-models#reasoning#model-routing#cost-efficiency
🧪

액티브러닝

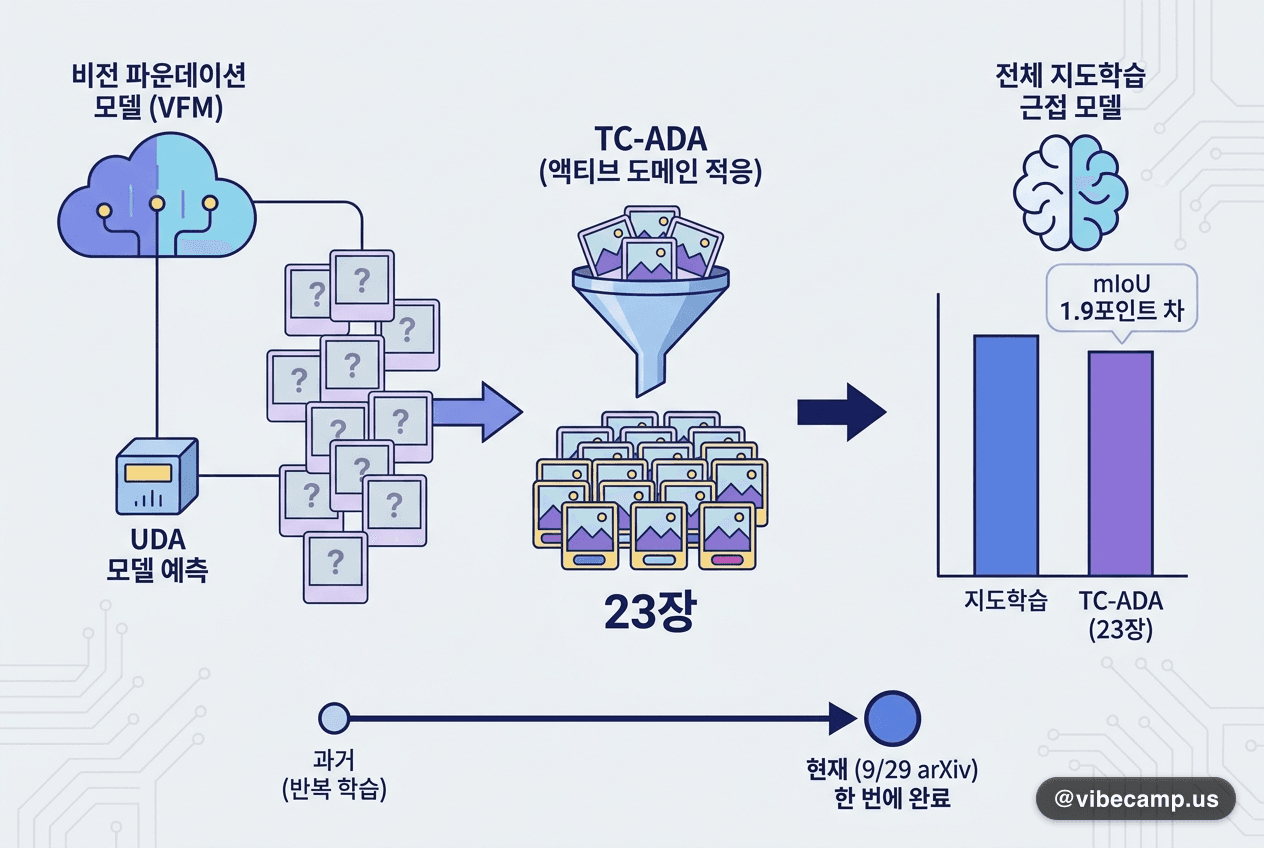
라벨 23장으로 전체 지도학습에 근접 — mIoU 1.9포인트 차

라벨 23장으로 전체 지도학습에 근접 — mIoU 1.9포인트 차

#
9/29 arXiv에 공개된 TC-ADA는 자율주행 시맨틱 세그멘테이션(semantic segmentation)의 액티브 도메인 적응(ADA)에서 '고르고-라벨링-재학습' 반복을 한 번으로 줄였습니다. 라벨 없이 비전 파운데이션 모델(VFM) 표현과 고정된 UDA 모델 예측으로 대표적·정보량 높은 타깃 이미지를 한 번에 골라 라벨링한 뒤 적응합니다. 4개 전이에서 23~46장, Mapillary에서 140장만 라벨링해 타깃 전체 지도학습 대비 mIoU 1.9포인트 이내에 들었습니다.
💡액티브 러닝의 비용은 라벨 수만이 아니라 라운드 수에서도 나옵니다. 라벨러를 여러 번 부르기 어려운 현장이라면 '한 번에 잘 고르기'가 실무 설계 기준이 됩니다.
원문 →#active-learning#domain-adaptation#segmentation#autonomous-driving#foundation-model
🔄

지속학습

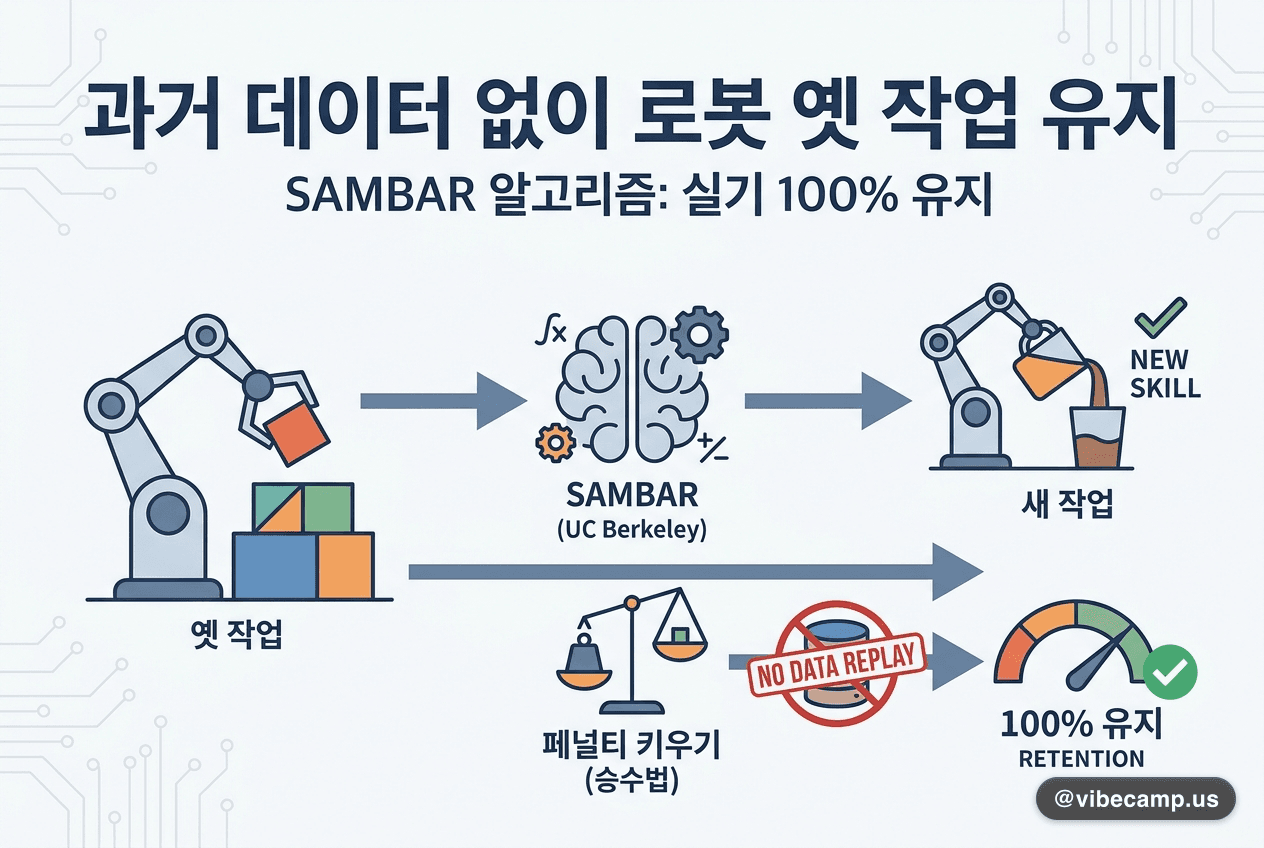
과거 데이터 없이 로봇이 옛 작업을 지킵니다 — 실기 100% 유지

과거 데이터 없이 로봇이 옛 작업을 지킵니다 — 실기 100% 유지

#
UC Berkeley 기계공학과 연구팀이 9/29 arXiv에 로봇 VLA(pi0.5) 지속학습 알고리즘 SAMBAR를 공개했습니다. 과거 시연 데이터 리플레이 없이 파국적 망각(catastrophic forgetting)을 막는 것이 목표입니다. 승수법(method of multipliers)의 쌍대변수로 제약 위반이 쌓일수록 페널티를 키우고, 이전 작업에 중요한 파라미터만 선택적으로 고정합니다. LIBERO 순차 학습에서 리플레이 없는 비교 기법은 모두 첫 작업을 완전히 잊었지만 SAMBAR는 전부 유지했습니다.
💡xArm7 실기에서도 사전학습 4개 작업 성공률 100%를 지키며 새 작업 2개를 각 80%로 익혔습니다. 데이터 보관이 어려운 배포 로봇에 현실적인 선택지입니다.
원문 →#continual-learning#robotics#vla#catastrophic-forgetting#constrained-optimization
🧬

메타러닝

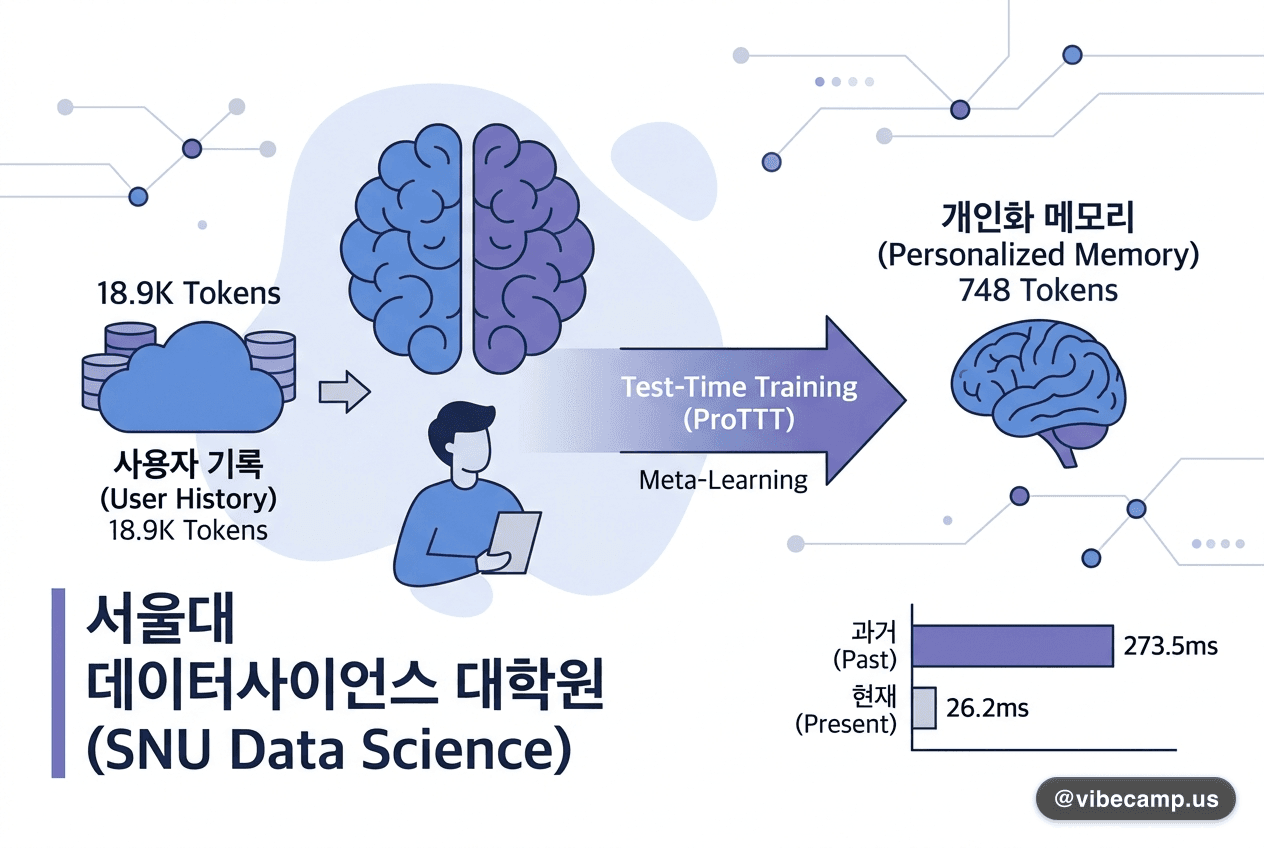
사용자 기록을 프롬프트 대신 가중치에 — 토큰 18.9K→748

사용자 기록을 프롬프트 대신 가중치에 — 토큰 18.9K→748

#
서울대 데이터사이언스대학원 연구팀이 9/29 arXiv에 개인화 메모리 ProTTT를 공개했습니다. 공유 초기값에서 출발해 사용자 히스토리로 테스트 타임 학습(test-time training)하고, 그 초기값을 텍스트 프로필을 정답 삼아 메타러닝합니다. CMV 기준 히스토리 전체 ICL 대비 프롬프트는 18.9K→748 토큰, 지연은 273.5→26.2ms로 줄고 AUC는 0.475→0.624로 올랐습니다. 다만 PersonaMem 6번 유형에선 BM25 RAG(0.491)·최근 5개 RAG(0.418)가 ProTTT(0.327)보다 높았습니다.
💡히스토리가 쌓일수록 비싸지는 프롬프트 개인화의 대안입니다. 300개 기록까지 컨텍스트 증가와 MMLU 저하가 없었지만, 과제 유형별로 RAG가 나은 구간도 함께 확인하세요.
원문 →#meta-learning#test-time-training#personalization#user-memory#rag
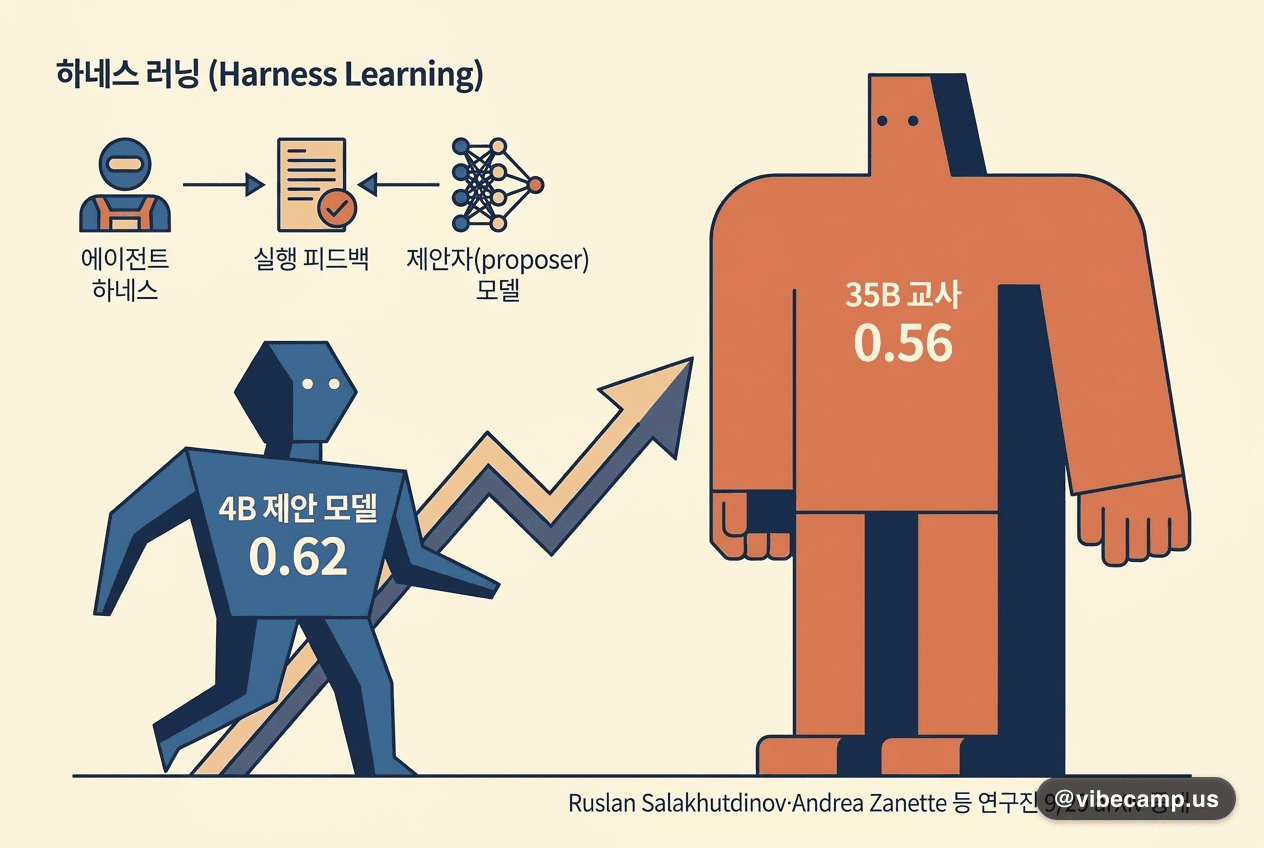
4B 제안 모델이 35B 교사를 앞섰습니다 — 0.62 대 0.56

4B 제안 모델이 35B 교사를 앞섰습니다 — 0.62 대 0.56

#
Ruslan Salakhutdinov·Andrea Zanette 등 연구진이 9/29 arXiv에 하네스 러닝(harness learning)을 공개했습니다. 에이전트 하네스(모델 호출·도구 흐름을 짜는 실행 프로그램)를 실행 피드백으로 고치는 제안자(proposer) 모델을 강화학습으로 훈련하는, 실행 프로그램 위의 메타러닝입니다. 처음 보는 Reasoning Gym 21개 계열에서 단일 수정 점수는 0.32→0.62로 올랐고, 4B 제안자가 35B 교사(0.56)를 평균에서 앞섰습니다. 최선 8개 선택 기준에서는 교사가 우위였습니다.
💡9/3 호 WHALE이 특정 태스크에서 가중치와 하네스를 번갈아 최적화했다면, 이번 연구는 '고치는 법'을 배운 모델을 파라미터 갱신 없이 처음 보는 태스크로 옮긴다는 점이 다릅니다.
원문 →#meta-learning#agent-harness#test-time-adaptation#reinforcement-learning#small-models

이 호가 도움됐다면 공유해 주세요 — 빌더 한 명이 더 알게 됩니다.

📤 공유하기𝕏@inf💬✈B✉