본문으로 건너뛰기
← vibecamp ai model 목록

vibecamp ai model · #29 · 2026-09-20

vibecamp ai model 2026-09-20 — 제로샷은 다수결에도 졌습니다 — 0.362 대 0.461

2026-09-20 AI 모델 일간 호 — 오늘 2개 카드를 정리했습니다.

2개 카드 · 적은 예제로 스스로 깨우치는 학습법 일간

📤 공유하기𝕏@inf💬✈B✉
🎯

퓨샷 학습

제로샷은 다수결에도 졌습니다 — 0.362 대 0.461

제로샷은 다수결에도 졌습니다 — 0.362 대 0.461

#
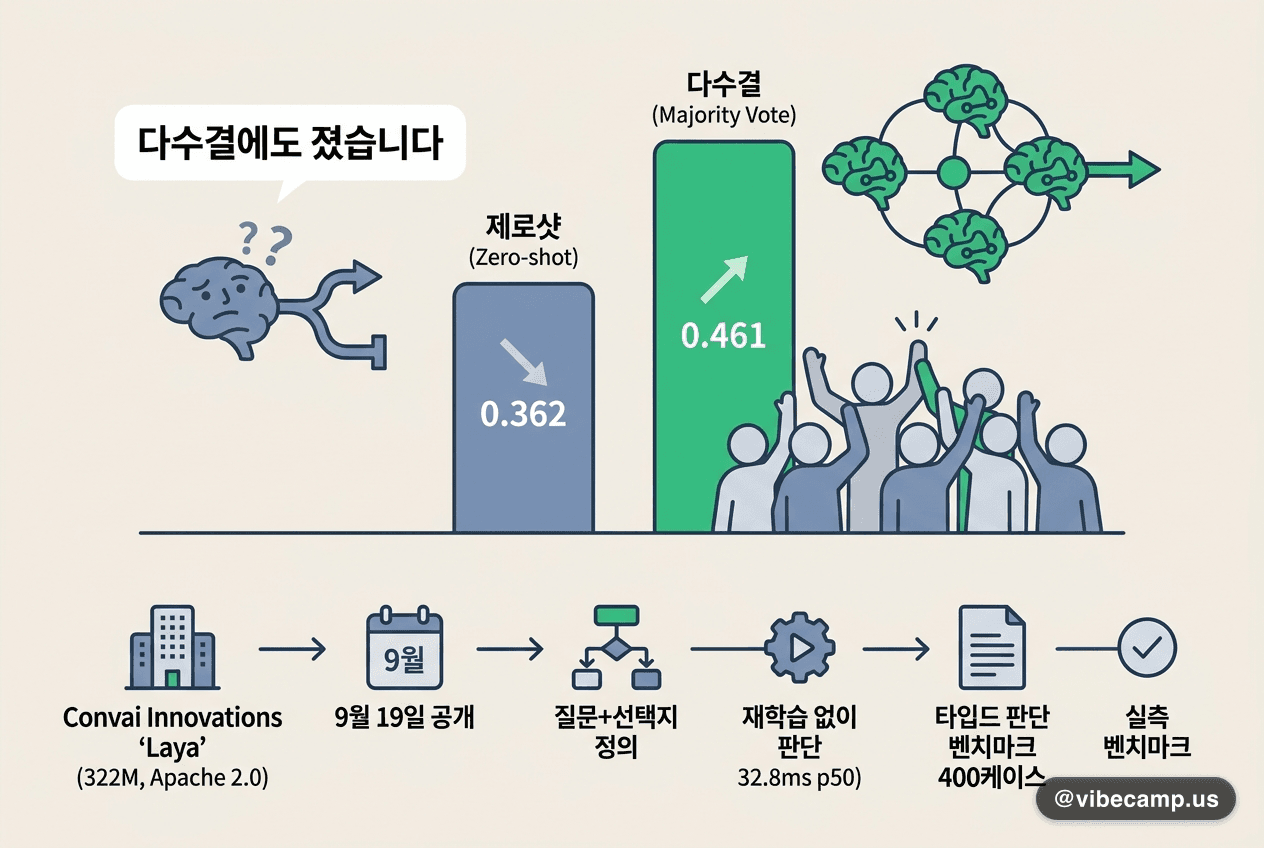
인도 Convai Innovations가 판단 전용 모델 Laya의 다국어 체크포인트(322M 파라미터)를 9월 19일 Apache 2.0으로 공개하며 실측 벤치마크를 함께 올렸습니다. 질문과 선택지를 요청 시점에 정의해 재학습 없이 한 번의 forward pass로 답하는 구조(p50 32.8ms)인데, 타입드 판단 벤치마크 400케이스에서 베이스 제로샷 정확도는 0.362로 다수결 기준선 0.461에도 못 미쳤습니다. 모델카드는 '제로샷 판단 엔진이 아니라 빠르게 특화시킬 베이스'라고 못 박습니다.
💡같은 벤치마크로 파인튜닝하면 0.766까지 오르지만, 전제는 소량 특화 데이터입니다. 헤드라인 숫자가 어느 체크포인트에서 나왔는지 먼저 확인하세요.
원문 →#few-shot-learning#modernbert#open-source#benchmark#classification
🪞

자가수정 학습

모델 R&D의 26%를 모델이 주도합니다 — 사람 감독 하에서

모델 R&D의 26%를 모델이 주도합니다 — 사람 감독 하에서

#
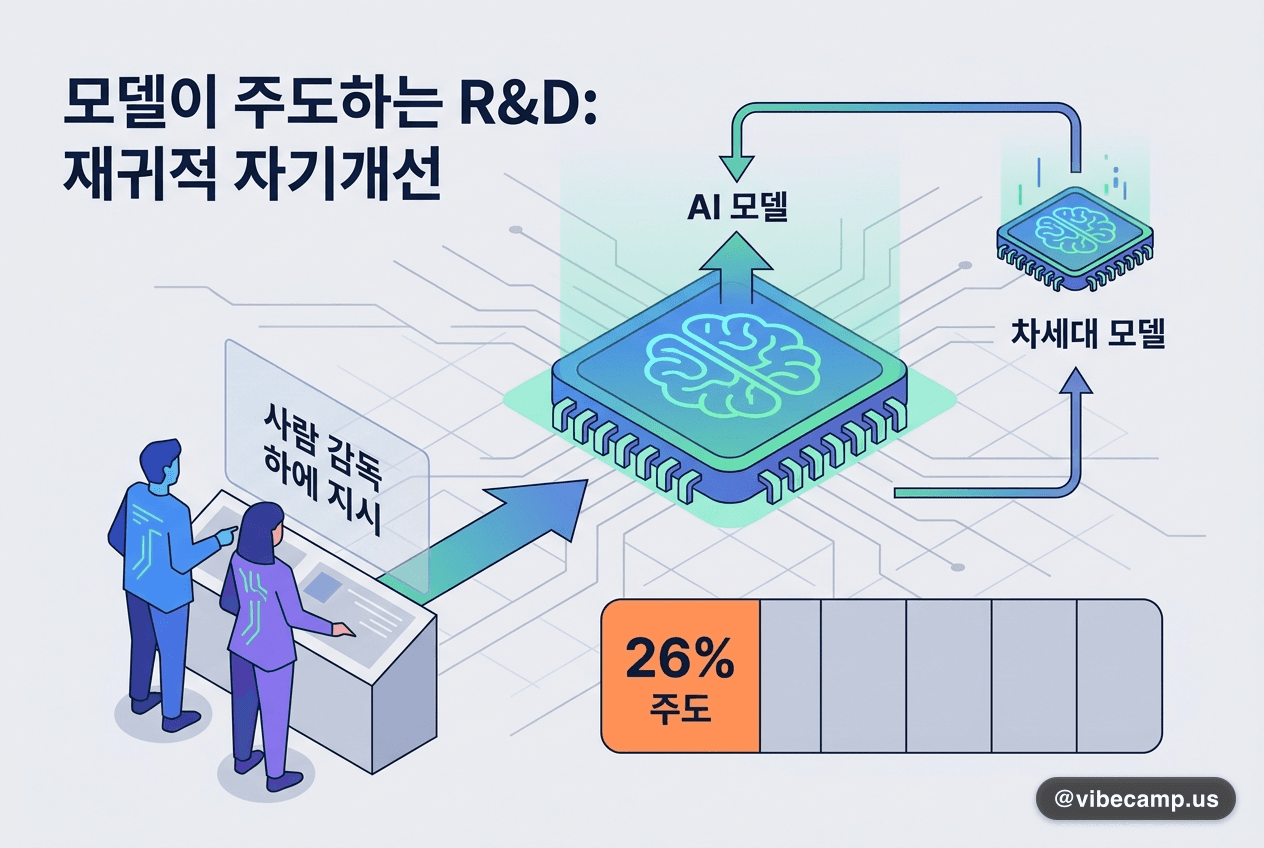
AP 통신이 9월 19일, 모델이 스스로를 개선하고 후속 모델을 만드는 재귀적 자기개선(recursive self-improvement, RSI)이 주요 연구소에서 수치로 드러나기 시작했다고 보도했습니다. Anthropic은 Claude가 자사 모델 연구개발의 26%를 주도한다고 밝혔는데, 회사 정의상 사람 감독 하에 상위 수준 지시를 받아 수행하는 몫입니다. OpenAI는 자동 '리서치 인턴'을 이달 공개하고 2028년 3월까지 자동 'AI 연구자'를 목표로 내걸었습니다.
💡자기수정 루프가 논문 시연을 넘어 연구소 R&D 지표로 공표되기 시작했습니다. 다만 감독 조건을 뗀 26%는 전혀 다른 이야기가 됩니다.
원문 →#self-correction#rsi#anthropic#openai#ai-safety

이 호가 도움됐다면 공유해 주세요 — 빌더 한 명이 더 알게 됩니다.

📤 공유하기𝕏@inf💬✈B✉