본문으로 건너뛰기
← vibecamp ai model 목록

vibecamp ai model · #28 · 2026-09-19

vibecamp ai model 2026-09-19 — 데이터 고르는 규칙을 에이전트가 짰습니다 — 하룻밤에 1200개

2026-09-19 AI 모델 일간 호 — 오늘 8개 카드를 정리했습니다.

8개 카드 · 적은 예제로 스스로 깨우치는 학습법 일간

📤 공유하기𝕏@inf💬✈B✉
🎯

퓨샷 학습

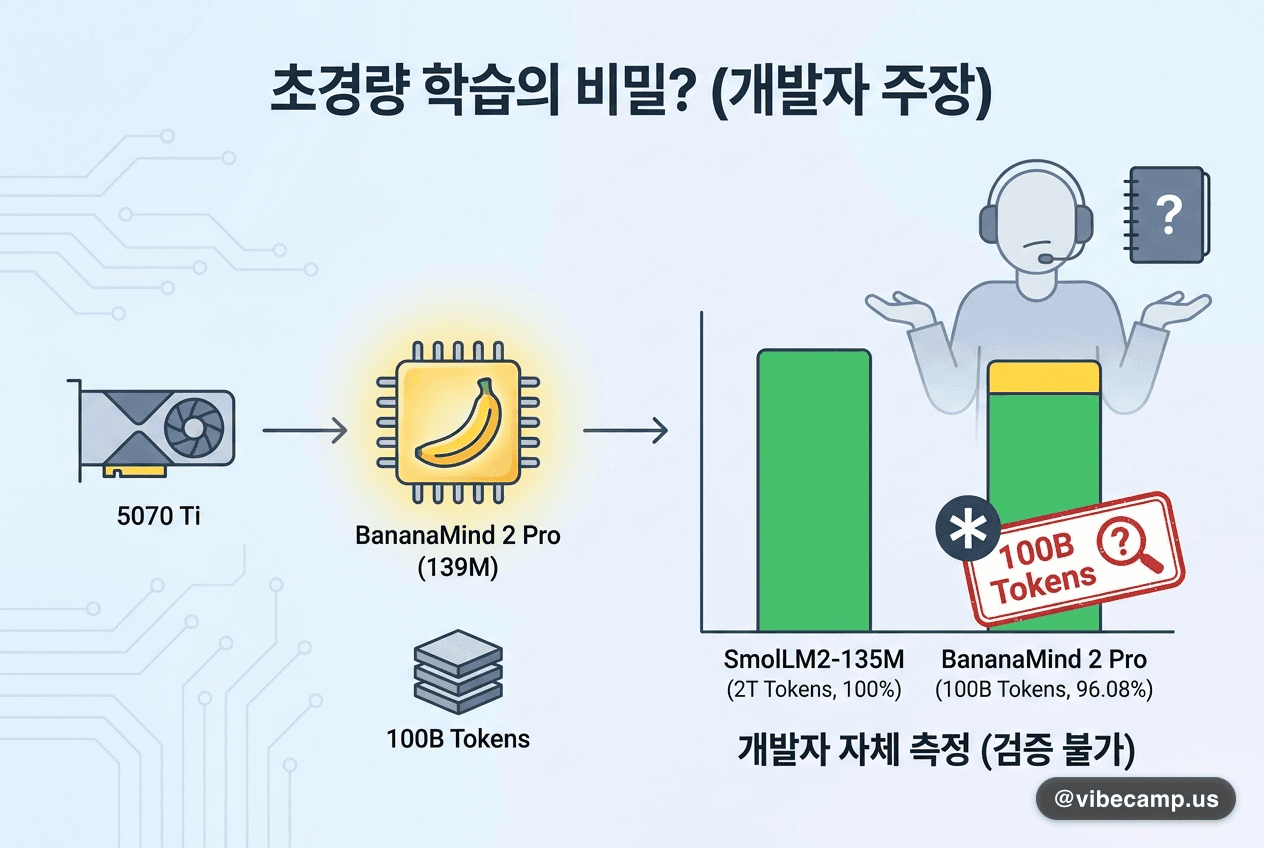
5070 Ti 한 장으로 100B 토큰 — 단, 숫자는 개발자 자기보고입니다

5070 Ti 한 장으로 100B 토큰 — 단, 숫자는 개발자 자기보고입니다

#
Banaxi-Tech가 139M 파라미터 소형 언어모델 BananaMind 2 Pro를 100B 토큰만으로 학습해 공개했습니다. SmolLM2-135M(2T 토큰)의 20분의 1 토큰으로 벤치마크 점수의 96.08%를 유지했다는 주장인데, 이 수치는 전부 개발자 자체 측정이고 eval harness·few-shot 세팅이 공개되지 않아 독립 재현이 불가능합니다. ArithMark나 Base Bench처럼 정의가 글에 없는 비표준 지표도 섞여 있고, 제목의 "almost matched"와 달리 ARC Easy(53.38% vs 58.63%)를 비롯한 개별 벤치는 대부분 SmolLM2가 우위라고 본문이 스스로 인정합니다. 검증 가능한 사실은 하나입니다 — H100이나 A100이 아니라 소비자용 RTX 5070 Ti 16GB 한 장으로 100B 토큰 학습을 완주했다는 것.
💡점수 비교보다 '데이터센터 GPU 없이 사전학습 실험이 돌아간다'는 쪽이 가져갈 부분입니다. 자기보고 리더보드 순위는 근거로 쓰지 마세요.
원문 →#소형 언어모델#데이터 효율#사전학습#자기보고 벤치마크#Hugging Face
📚

커리큘럼 학습

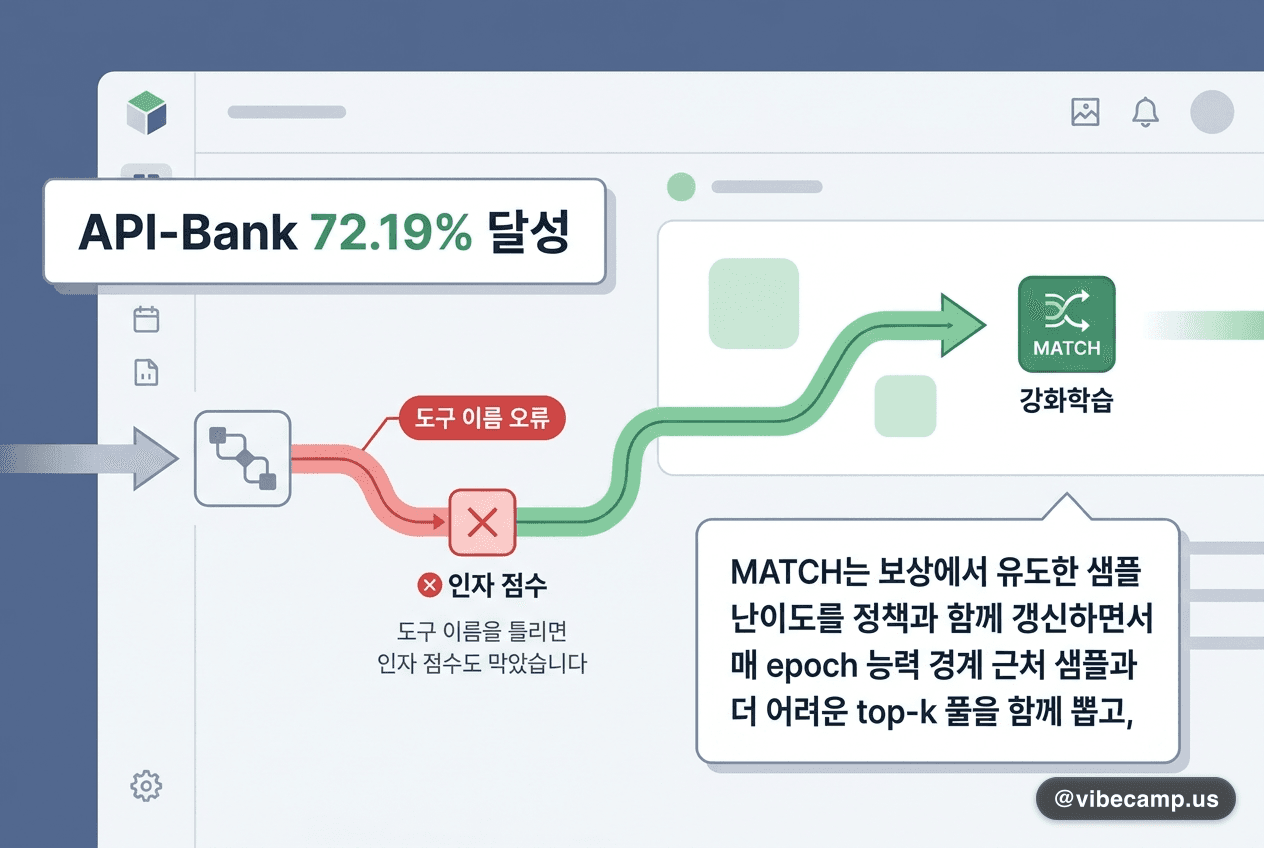
도구 이름을 틀리면 인자 점수도 막았습니다 — API-Bank 72.19%

도구 이름을 틀리면 인자 점수도 막았습니다 — API-Bank 72.19%

#
도구 호출을 강화학습으로 다듬을 때 두 가지가 발목을 잡습니다. 커리큘럼 임계값이 고정돼 정책의 능력 경계가 움직이면 어긋나고, 덧셈식 보상은 도구 이름을 틀렸는데도 인자 점수가 새어 나가 잘못된 행동을 강화합니다. MATCH는 보상에서 유도한 샘플 난이도를 정책과 함께 갱신하면서 매 epoch 능력 경계 근처 샘플과 더 어려운 top-k 풀을 함께 뽑고, 도구 이름→인자 키→인자 값을 게이트 체인으로 채점해 앞 단계를 통과해야만 점수를 줍니다. 같은 보상이 GRPO 업데이트와 난이도 갱신을 동시에 굴려 루프를 닫았고, API-Bank 72.19%·BFCL V3 62.87%로 주요 베이스라인을 상회했습니다.
💡툴 콜 에이전트를 튜닝한다면 보상 설계부터 보세요. 부분 점수를 그냥 더하면 모델이 '틀린 도구에 그럴듯한 인자'를 배웁니다.
원문 →#커리큘럼 학습#tool calling#GRPO#보상 설계#arXiv
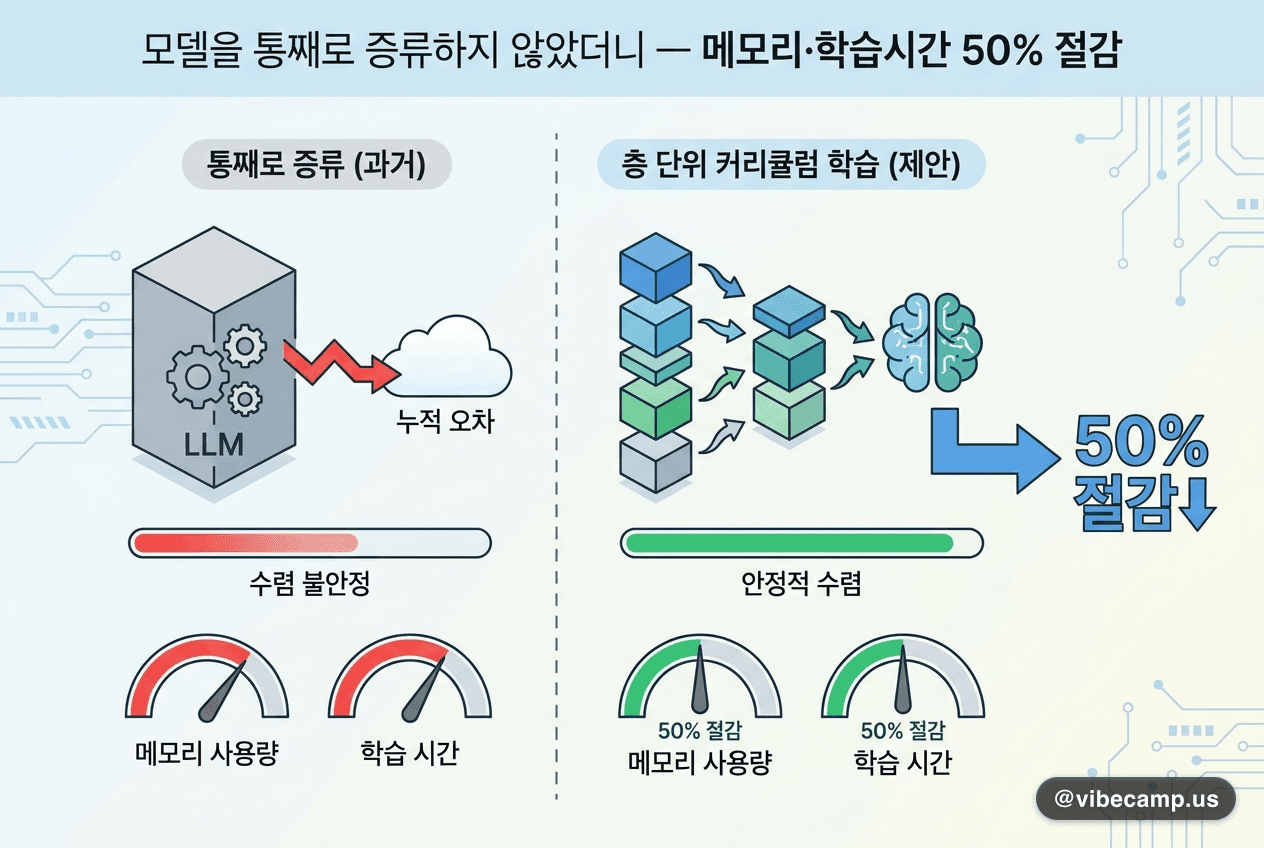
모델을 통째로 증류하지 않았더니 — 메모리·학습시간 50% 절감

모델을 통째로 증류하지 않았더니 — 메모리·학습시간 50% 절감

#
지식 증류로 LLM을 압축할 때 모델 전체를 한 번에 다루면 누적 오차(cumulative error)가 쌓여 수렴이 느리고 불안정합니다. 이 논문은 모델을 여러 층 묶음으로 쪼갠 뒤 쉬운 최적화 과제부터 시작해 점점 어려운 구간으로 넘어가는 층 단위 커리큘럼 학습을 제안했습니다. 층 간 feature 불일치는 멀티스레딩 feature 캐싱으로 처리해 GPU 활용도를 끌어올렸습니다. BERT·GPT-2에서 GPU 메모리와 학습 시간을 50% 이상 줄이면서 SOTA 압축 성능을 냈고, 동일 학습 시간 기준 LLaMA 계열·Qwen에서 기존 pruning 기법을 더 낮은 메모리로 앞섰습니다.
💡GPU 한 장으로 모델을 줄여야 하는 상황이라면 압축률보다 '어느 구간부터 증류할지'가 먼저입니다. 같은 기법도 순서가 비용을 반으로 가릅니다.
원문 →#커리큘럼 학습#지식 증류#모델 압축#pruning#arXiv
🪞

자가수정 학습

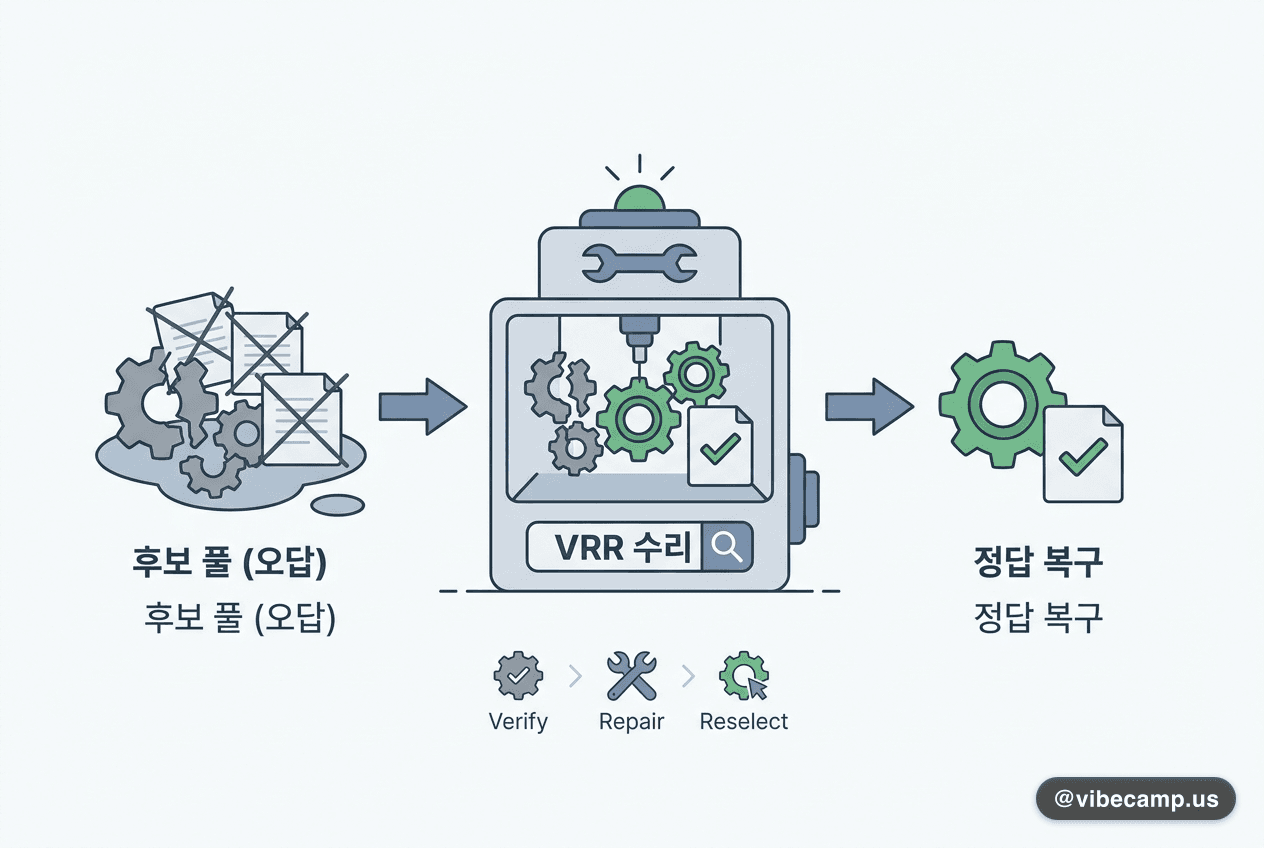
검증기를 심판이 아니라 수리공으로 — 전부 오답인 풀에서도 정답을 복구

검증기를 심판이 아니라 수리공으로 — 전부 오답인 풀에서도 정답을 복구

#
후보를 여러 개 뽑고 검증기로 하나를 고르는 방식은 검증을 순위 매기기에만 쓰고 피드백은 버립니다. 그래서 초기 후보 풀에 정답이 하나도 없으면 무엇을 뽑아도 오답입니다. Verify-Repair-Reselect(VRR)는 1등 답안은 유지한 채 1등·2등을 수리한 버전과 새 접근 기반 해답을 조건부로 생성하고, 추론 시점 정보만으로 무효·중복 후보를 걸러낸 뒤 원래 기준으로 다시 선택합니다. 코드 생성·추론 벤치마크의 여러 모델에서 고정 풀 방식을 상회했고, 초기 후보가 전부 오답인 경우에도 정답을 복구했습니다.
💡best-of-n을 쓰고 있다면 검증 결과를 버리지 마세요. 같은 예산으로 후보를 고르는 대신 후보를 고칠 수 있습니다.
원문 →#자기 교정#verifier#best-of-n#코드 생성#arXiv
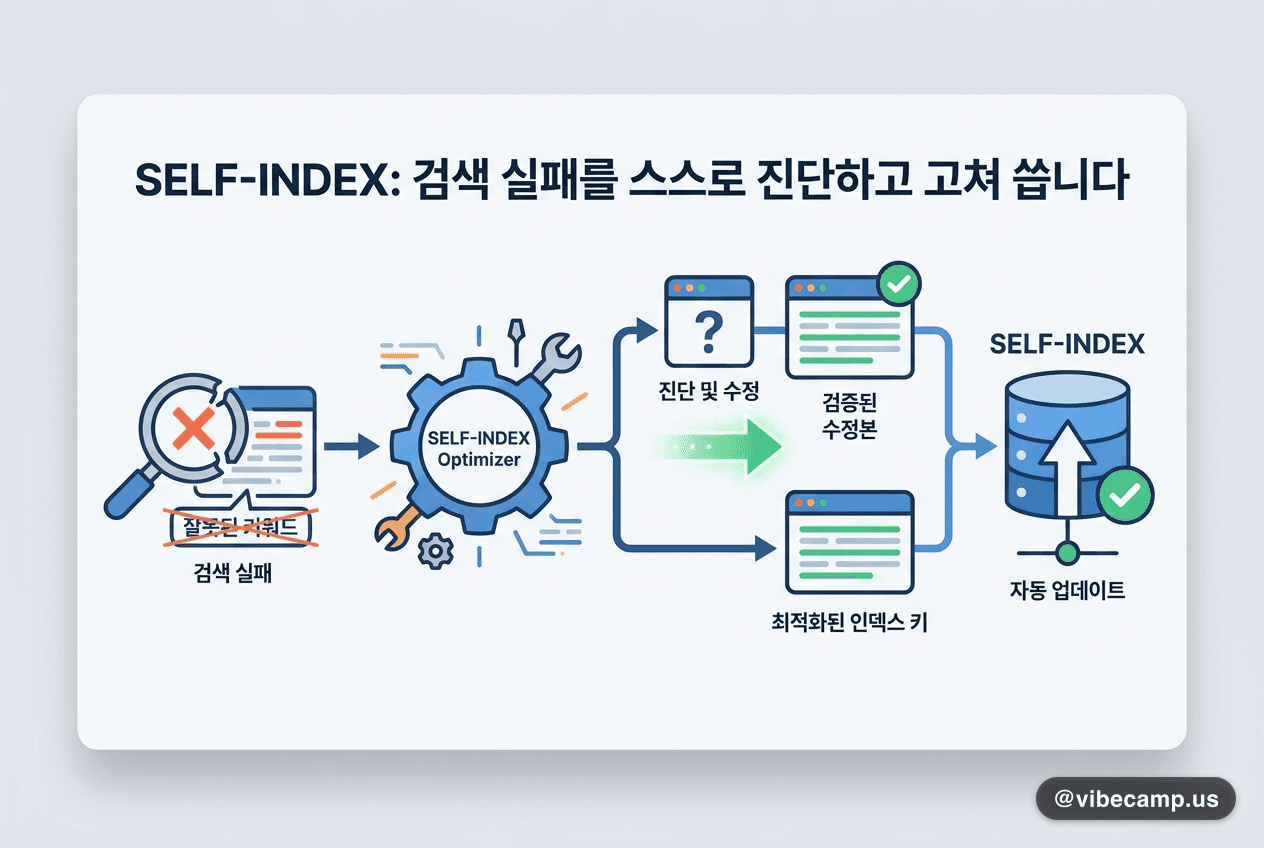
검색 실패를 인덱스가 스스로 진단합니다 — 사람 개입 없이 키를 고쳐 씁니다

검색 실패를 인덱스가 스스로 진단합니다 — 사람 개입 없이 키를 고쳐 씁니다

#
검색 품질은 인덱스 키가 문서의 지식을 얼마나 드러내느냐에 달렸는데, 효과적인 표현은 검색 환경마다 달라 고정 전략이 일관되게 통하지 않습니다. 지금까지는 사람이 실패를 진단하고 전략을 고쳐 인덱스를 재처리해야 했습니다. SELF-INDEX의 Optimizer는 검색 실패를 자율 진단해 책임 있는 인덱스 키만 선별 수정하고, 각 수정본을 검증하고서야 인덱스를 갱신합니다. 관측된 수요에 반응하는 데 그치지 않고 Query Simulator로 아직 오지 않은 질의까지 미리 탐색합니다. 다양한 코퍼스·리트리버에서 기존 인덱스 최적화 기법을 일관되게 상회했고, 에이전트 메모리의 과거 상호작용 재활용까지 개선됐습니다. 연세대 등 한국 연구진 중심 성과입니다.
💡RAG 성능이 안 나올 때 리트리버를 바꾸기 전에 인덱스 표현을 의심해 보세요. 그 개선 루프 자체를 자동화할 수 있다는 제안입니다.
원문 →#자기 진화#RAG#인덱스 최적화#에이전트 메모리#arXiv
🧪

액티브러닝

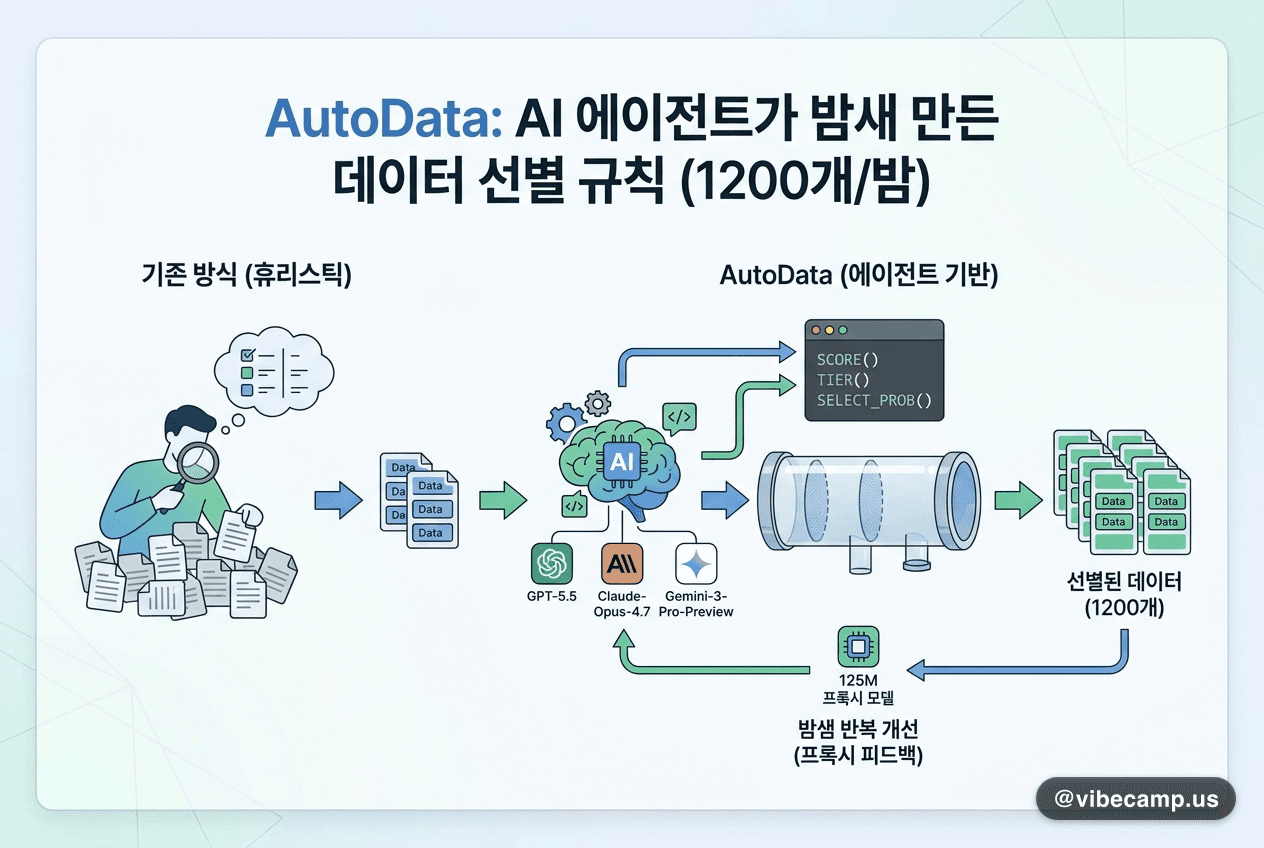
데이터 고르는 규칙을 에이전트가 짰습니다 — 하룻밤에 1200개

데이터 고르는 규칙을 에이전트가 짰습니다 — 하룻밤에 1200개

#
사전학습 데이터 선별은 보통 사람이 휴리스틱을 손으로 짭니다. AutoData는 이 작업을 '실행 가능한 선별 알고리즘 탐색'으로 바꿔, LLM 에이전트(GPT-5.5·Claude-Opus-4.7·Gemini-3-Pro-Preview)가 점수화·계층화·확률적 선택 규칙을 코드로 써내게 했습니다. 125M 프록시 모델의 검증 피드백으로 반복 개선하며 하룻밤 사이 1200개 레시피를 만들었고, 그중 최적 레시피가 사람이 설계한 큐레이션 파이프라인을 앞섰습니다. 다만 depth 24에서는 기존 ClimbMix 기본값과 동등해 전이 한계가 드러났고, 다운스트림 CORE 지표 개선은 분산이 커 통계적 유의성을 확보하지 못했다고 저자들이 직접 밝혔습니다.
💡데이터 큐레이션도 사람의 감이 아니라 탐색 대상이 될 수 있습니다. 다만 작은 프록시에서 찾은 규칙이 어디까지 전이되는지는 따로 확인해야 합니다.
원문 →#데이터 선별#사전학습#에이전트 탐색#AutoData#arXiv
🔄

지속학습

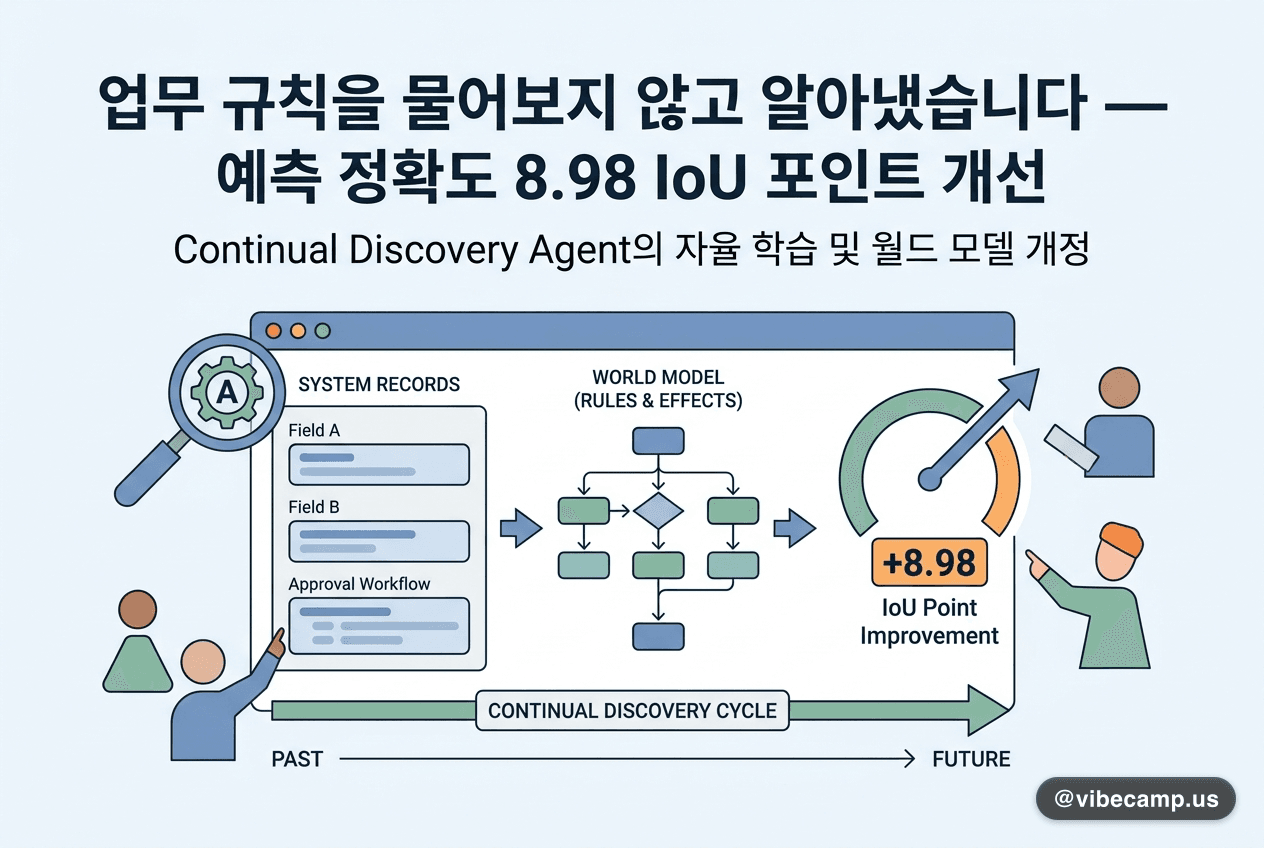
업무 규칙을 물어보지 않고 알아냈습니다 — 예측 정확도 8.98 IoU 포인트 개선

업무 규칙을 물어보지 않고 알아냈습니다 — 예측 정확도 8.98 IoU 포인트 개선

#
기업 시스템에서 필드 하나를 바꾸면 다른 필드가 설정되고 결재가 돌기도 합니다. 이 효과는 플랫폼이 아니라 조직마다 직접 쓰고 수시로 고치는 업무 규칙에서 나옵니다. 연구진은 에이전트가 규칙을 전혀 모르는 상태에서 레코드를 건드려 보고 결과를 관찰해 월드 모델을 세우고, 규칙이 바뀌면 모델을 폐기하지 않고 개정하는 Continual Discovery Agent(CDA)를 제안했습니다. 라이브 ServiceNow 환경에 테이블 9개·숨은 규칙 25개·평가 액션 600개로 만든 벤치마크 EnterpriseWorldShift에서, 질문마다 규칙을 조회하던 기존 방식보다 숨은 규칙의 효과를 최대 8.98 IoU 포인트 더 정확히 예측했습니다.
💡사내 시스템 자동화의 병목은 모델 성능이 아니라 문서화되지 않은 규칙입니다. 매번 조회하는 대신 관찰로 모델을 만들어 두는 설계가 있습니다.
원문 →#지속학습#월드 모델#엔터프라이즈 에이전트#ServiceNow#arXiv
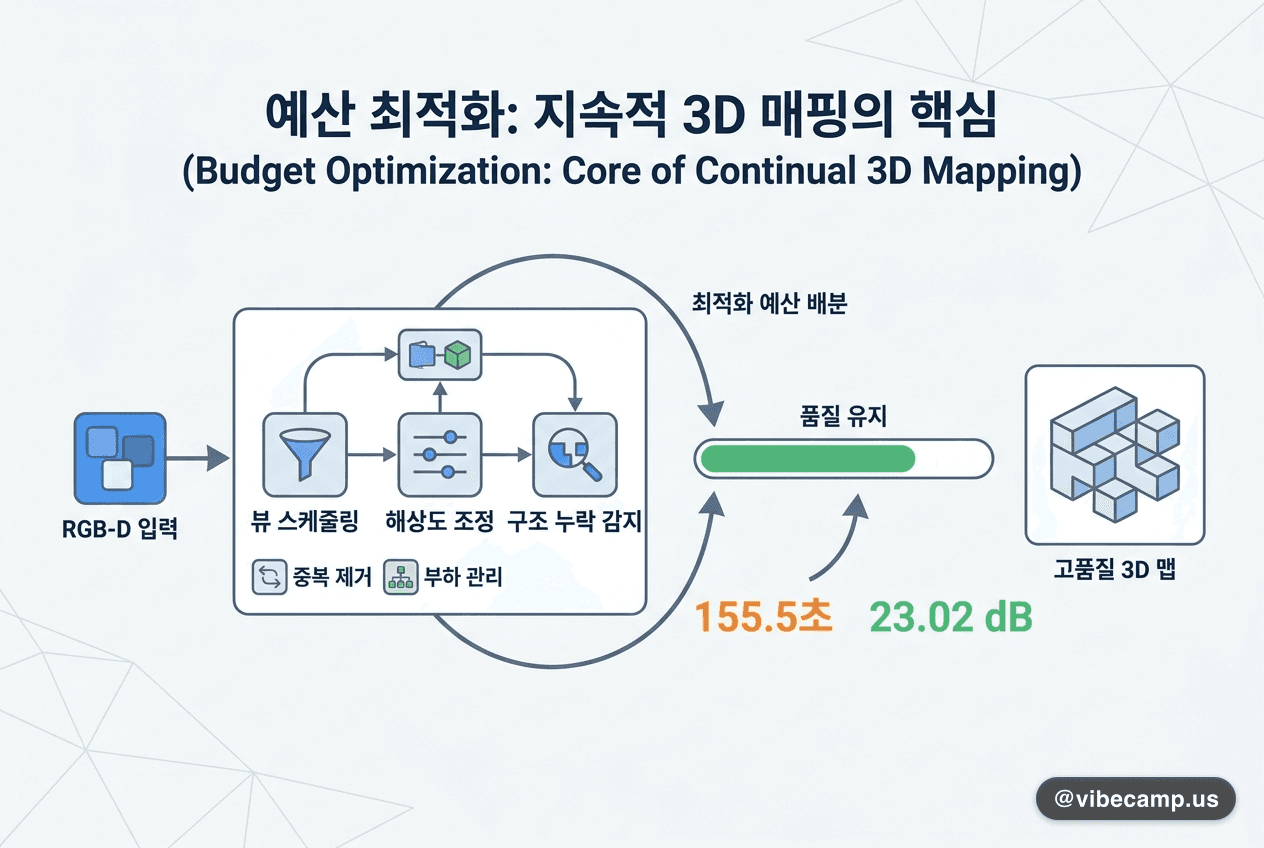
예산을 어디에 쓸지 골랐더니 — 155.5초에 23.02 dB

예산을 어디에 쓸지 골랐더니 — 155.5초에 23.02 dB

#
여기서 말하는 continual은 모델의 지속학습이 아니라 온라인 3D 매핑입니다. RGB-D 관측이 계속 들어오는 동안 이전에 복원한 영역 품질이 무너지지 않게 최적화 예산을 배분하는 문제입니다. EliGSiR은 지도 기반 뷰 스케줄링으로 중복 뷰를 걸러내고, 현재 매핑 부하에 맞춰 감독 해상도를 조정하며, 반복 관측이 구조 누락을 가리키는 곳에만 가우시안 용량을 늘립니다. TUM RGB-D fr3/long_office_household에서 동일 GT 포즈 기준 21.52 dB(SplaTAM 19.42 dB), ORB-SLAM3 실시간 포즈 조건에서는 155.5초에 23.02 dB로 CaRtGS(230.9초, 20.10 dB)를 앞섰습니다.
💡학습 기법 논문은 아니지만, 제한된 연산 안에서 '무엇을 다시 볼지' 고르는 문제 설정은 리플레이 기반 지속학습과 같은 구조입니다.
원문 →#3D Gaussian Splatting#온라인 매핑#image replay#로보틱스#arXiv

이 호가 도움됐다면 공유해 주세요 — 빌더 한 명이 더 알게 됩니다.

📤 공유하기𝕏@inf💬✈B✉