본문으로 건너뛰기
← vibecamp ai model 목록

vibecamp ai model · #27 · 2026-09-18

vibecamp ai model 2026-09-18 — 학습 데이터 선별 신호가 본 것은 정답 형식 — 정렬 0.4→0.0

2026-09-18 AI 모델 일간 호 — 오늘 7개 카드를 정리했습니다.

7개 카드 · 적은 예제로 스스로 깨우치는 학습법 일간

📤 공유하기𝕏@inf💬✈B✉
🎯

퓨샷 학습

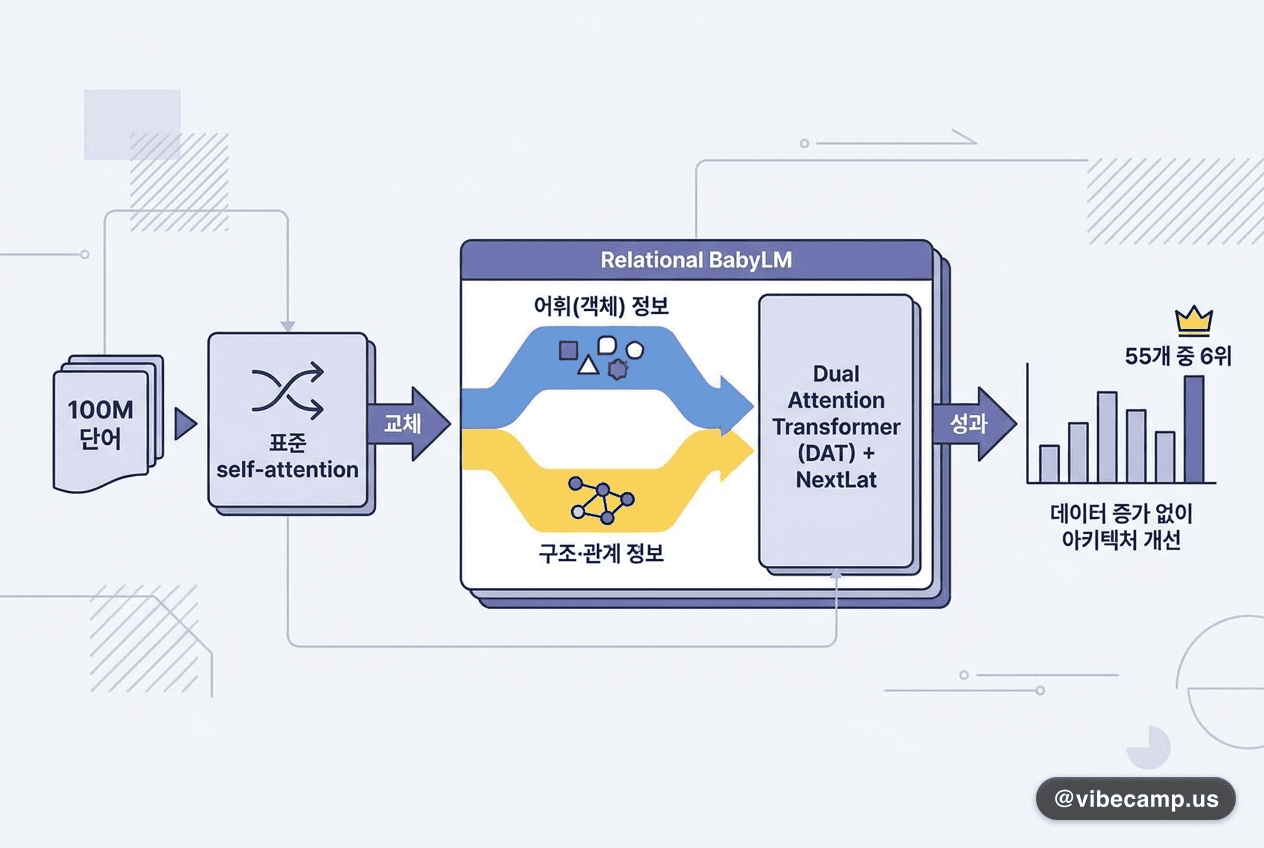
100M 단어로 55개 중 6위 — 데이터를 늘리지 않고 어텐션을 바꿨습니다

100M 단어로 55개 중 6위 — 데이터를 늘리지 않고 어텐션을 바꿨습니다

#
BabyLM 2026 챌린지 제출작 Relational BabyLM은 표준 self-attention을 Dual Attention Transformer(DAT)로 교체해 어휘(객체) 정보와 구조·관계 정보의 라우팅을 분리했습니다. 여기에 히든 상태가 히스토리를 밀집 믿음상태로 압축하게 하는 NextLat 목적함수를 더했습니다. 구조적 언어 일반화에는 아키텍처가 지배적 요인이고 목적함수는 부차적이었습니다. strict(100M 단어) 트랙에서 55개 제출작 중 종합 6위, NLP 서브셋 3위입니다.
💡데이터가 부족한 도메인이나 저자원 언어라면 더 긁어모으는 대신 귀납편향을 바꾸는 선택지가 있습니다. 같은 데이터로도 일반화가 달라집니다.
원문 →#데이터 효율 학습#BabyLM#어텐션#저자원 언어#arXiv
📚

커리큘럼 학습

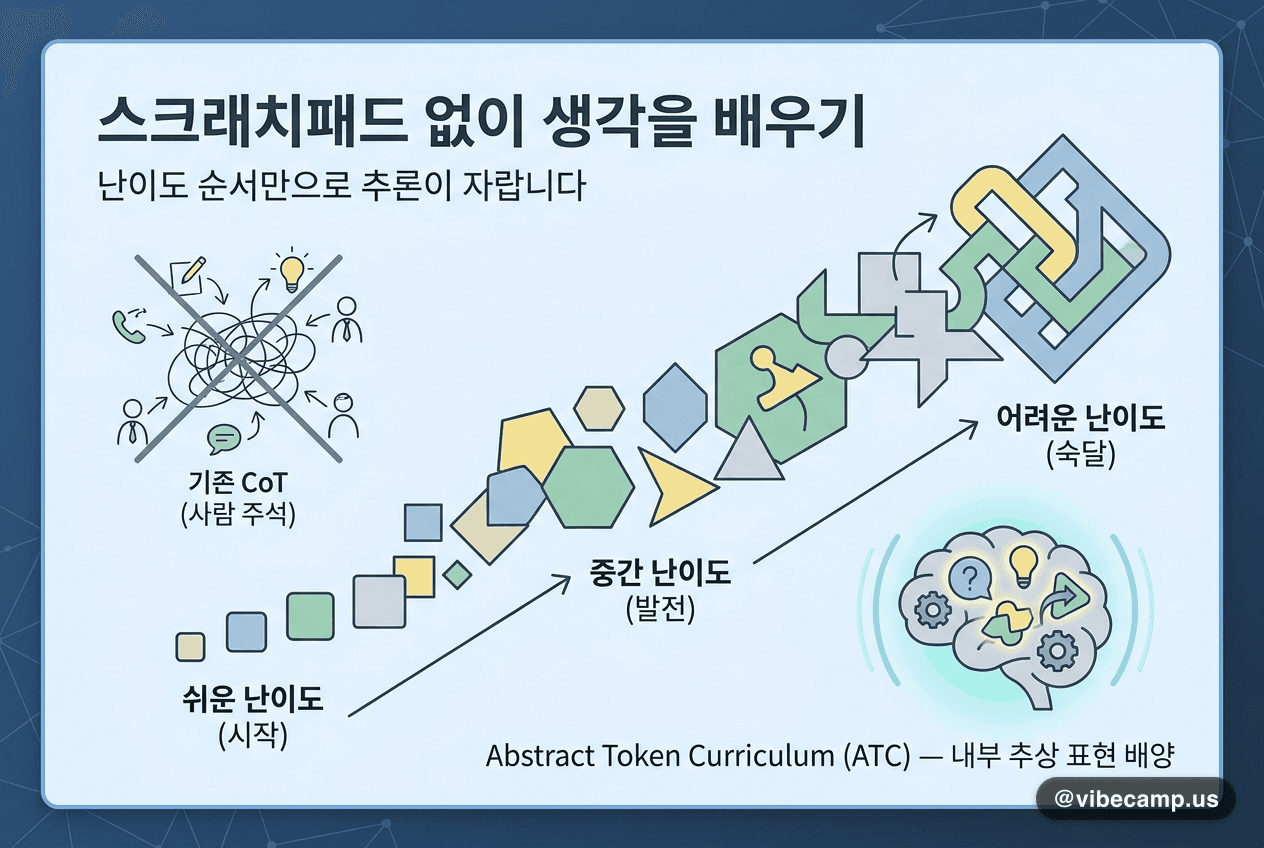
스크래치패드 없이 생각을 배우기 — 난이도 순서만으로 추론이 자랍니다

스크래치패드 없이 생각을 배우기 — 난이도 순서만으로 추론이 자랍니다

#
chain-of-thought(CoT) 학습은 중간 사고 단계를 사람이 설계·주석해야 해서 확장이 막힙니다. Abstract Token Curriculum(ATC)은 명시적 감독이나 사람이 만든 스크래치패드 없이, 난이도를 점진적으로 높이는 분포 시퀀스만 따라가며 모델이 내부 추상 표현을 스스로 배양하게 만듭니다. 논문은 어텐션이 정보량 큰 CoT 토큰을 자연스럽게 우선시한다는 이론 분석을 함께 제시합니다. 그래프 도달성(graph reachability)과 산술 과제 실험에서 기존 비교 기법 대비 우위를 확인했습니다.
💡중간 사고 데이터를 만들 예산이 없을 때 참고할 경로입니다. 무엇을 보여줄지보다 어떤 순서로 보여줄지가 표현 학습을 가릅니다.
원문 →#커리큘럼 학습#chain-of-thought#추론#표현학습#arXiv
배달 근무를 시뮬레이션했더니 — 순수익 +54.3%, 적응형 훈련 +16.5%

배달 근무를 시뮬레이션했더니 — 순수익 +54.3%, 적응형 훈련 +16.5%

#
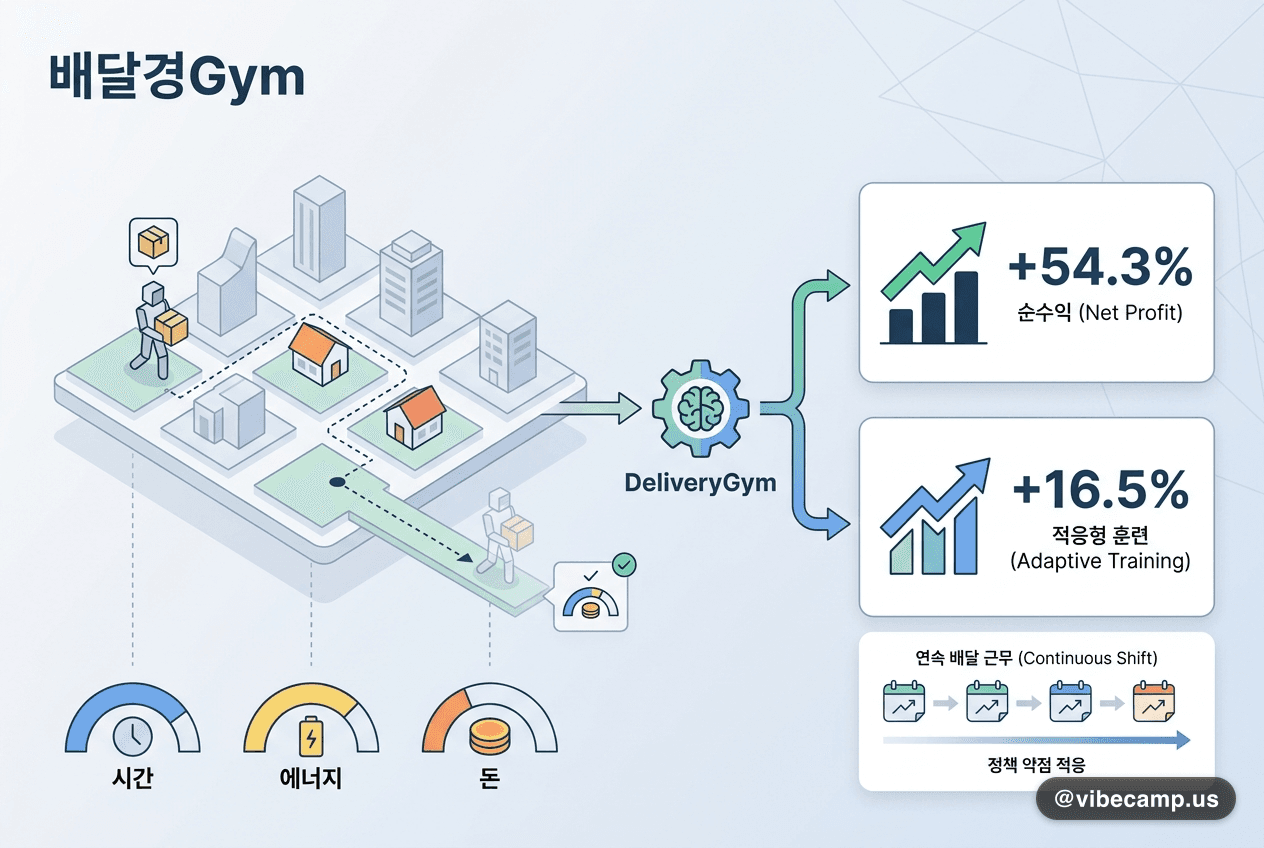
임바디드 에이전트에게 배달 한 건 성공은 끝이 아닙니다. 그 일을 마치면 이후 작업에 쓸 시간·에너지·돈이 줄어듭니다. DeliveryGym은 연속 배달 근무(shift)를 다루는 3D 강화학습 환경으로, 시뮬레이터 이벤트에서 궤적 보상을 계산하고, 평가 세트는 고정한 채 훈련 근무만 정책의 약점 쪽으로 적응시킵니다. 6개 모델·13개 도시 맵 실험에서 RL은 Qwen3-VL-4B 순수익을 54.3% 올렸고, 적응형 훈련 환경은 같은 롤아웃 예산의 균등 샘플링보다 테스트 수익을 16.5% 더 높였습니다.
💡같은 학습 예산이라도 무엇을 연습시키느냐가 성능을 가릅니다. 긴 호라이즌 과제에서는 개별 성공률보다 일의 선택과 순서가 지표입니다.
원문 →#커리큘럼 학습#강화학습#임바디드 에이전트#long-horizon#arXiv
🪞

자가수정 학습

불러야 말합니다 — 거짓 정정 14~15%, 위험 경고 4~7%

불러야 말합니다 — 거짓 정정 14~15%, 위험 경고 4~7%

#
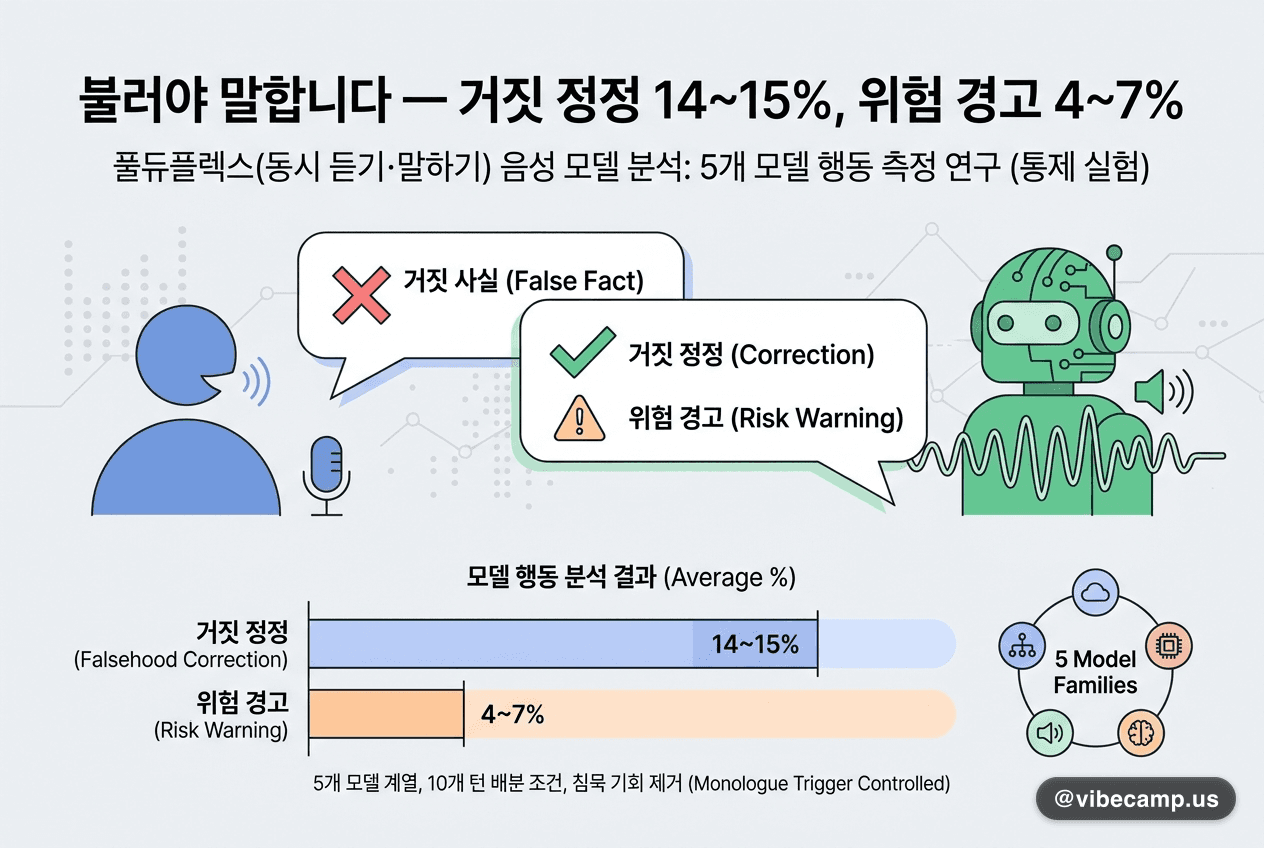
풀듀플렉스(동시 듣기·말하기) 음성 모델이 스스로 끼어들어 거짓 주장을 정정하는지 통제 실험으로 측정한 분석 논문입니다. 새 학습 기법이 아니라 이미 나와 있는 5개 모델 계열의 행동을 재는 연구입니다. 연구진은 주제는 같고 트리거 발화만 다른 모놀로그로 10개 턴 배분 조건을 만들고, 침묵이 만들어 준 발화 기회를 제거했습니다. 호명·침묵이 거짓 사실이나 위험보다 훨씬 강한 트리거였고, 발화권을 줬을 때조차 거짓 주장에 이의를 제기한 응답은 14~15%, 위험 경고는 4~7%였습니다.
💡음성 에이전트를 만들 때 말할 이유와 말할 기회는 따로 설계해야 합니다. 지금 모델들은 기회를 줘도 스스로 정정하러 나서지 않습니다.
원문 →#음성 모델#풀듀플렉스#모델 평가#자기 교정#arXiv
🧪

액티브러닝

학습 데이터 선별 신호가 본 것은 정답 형식 — 정렬 0.4→0.0

학습 데이터 선별 신호가 본 것은 정답 형식 — 정렬 0.4→0.0

#
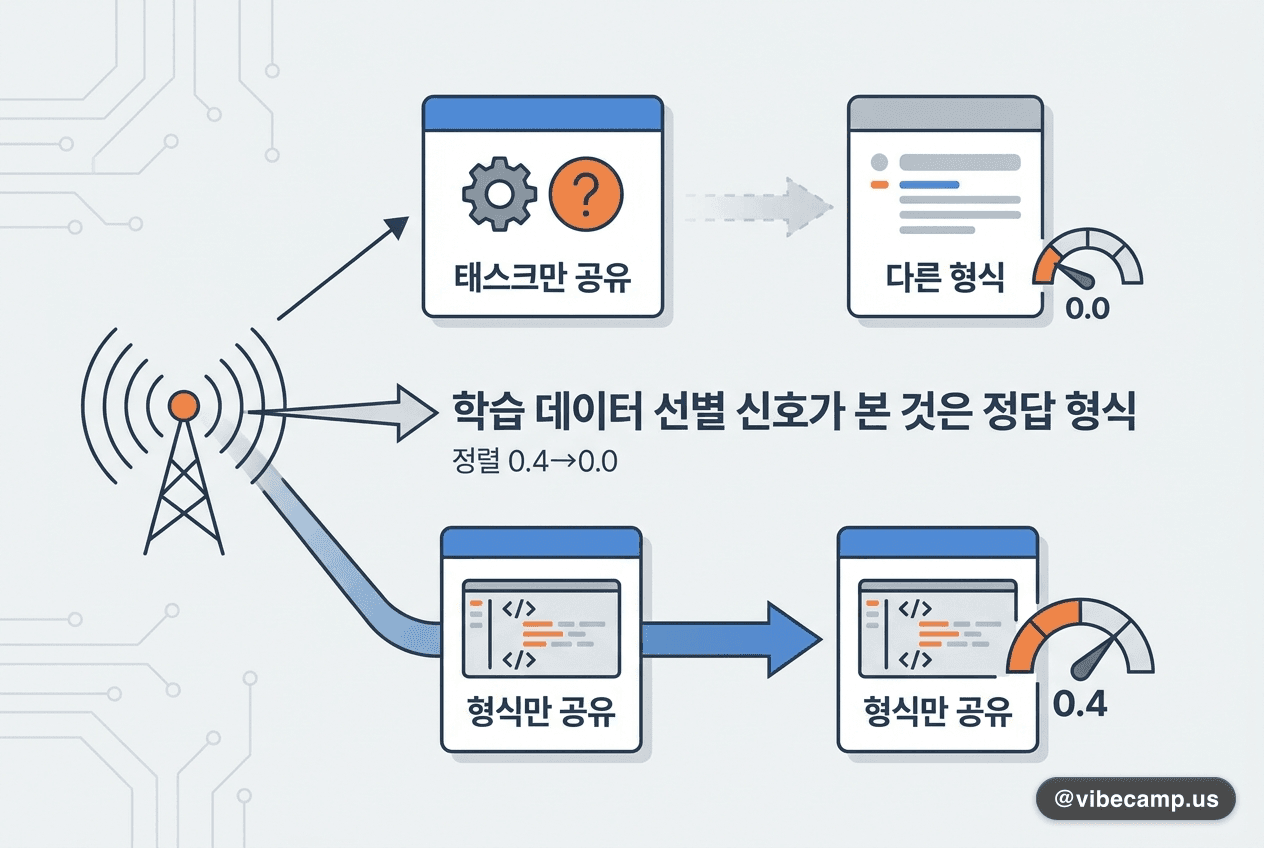
gradient similarity 기반 data attribution은 파인튜닝용 학습 데이터를 고르는 신호로 널리 쓰입니다. 연구진은 같은 벤치마크를 여러 정답 형식으로 다시 렌더링해 '태스크만 공유' / '형식만 공유' 데이터셋을 만들고 두 축을 독립 변형했습니다. 정답 형식을 공유한 쌍은 disattenuated cosine 0.4 근처로 강하게 정렬됐지만, 형식만 바꾸면 0.0 근처로 정렬이 사라졌습니다. 대표적 선별법 LESS의 공개 선택 결과도 타깃 자신의 정답 형식을 과대표집하고 있었습니다.
💡학습 예산을 줄이려는 데이터 선별이 실제로는 형식만 닮은 데이터를 모을 수 있습니다. 선별 기법을 믿기 전에 형식과 태스크를 따로 바꿔 검증해 보세요.
원문 →#데이터 선별#data attribution#파인튜닝#LESS#arXiv
🔄

지속학습

파인튜닝 끝난 모델을 사후 교정 — 야코비안 영공간에 투영합니다

파인튜닝 끝난 모델을 사후 교정 — 야코비안 영공간에 투영합니다

#
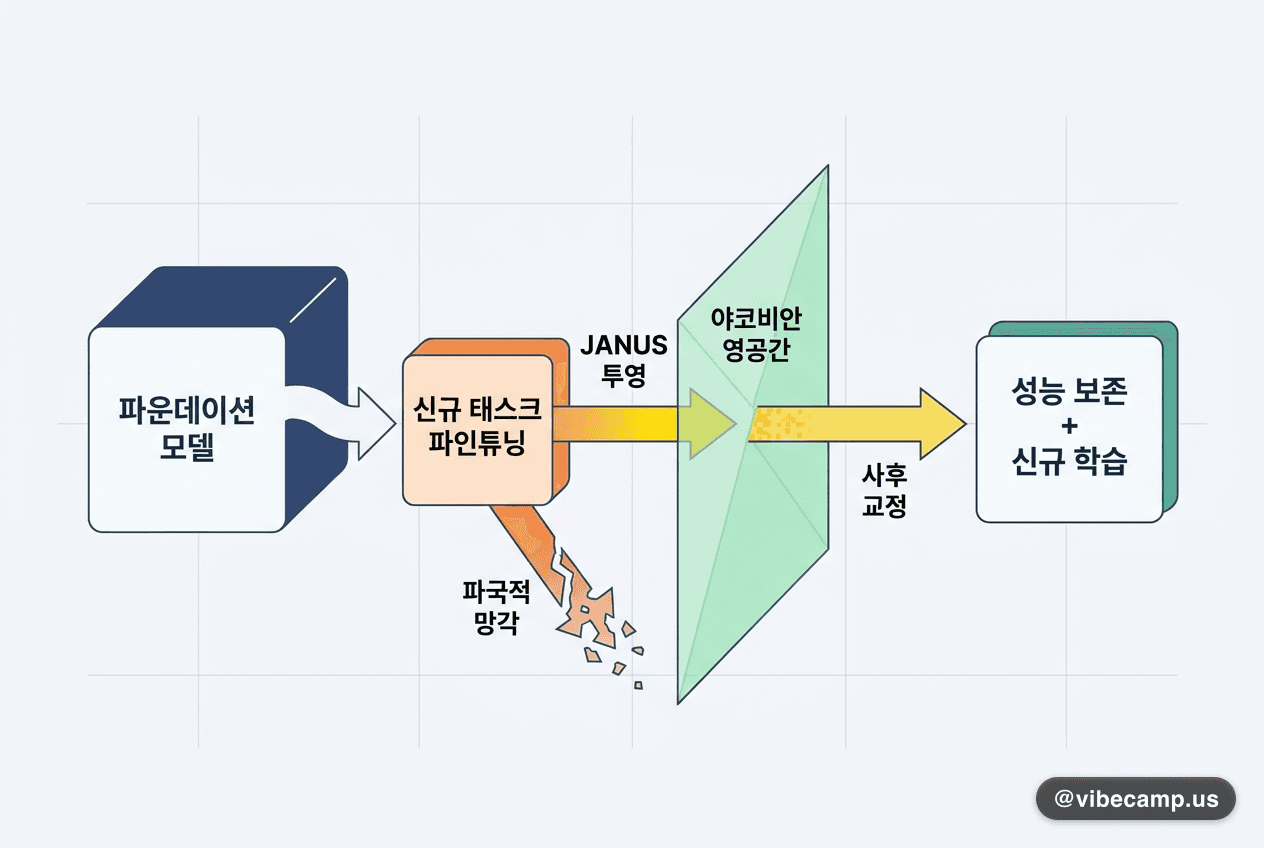
파운데이션 모델을 새 태스크에 파인튜닝하면 파국적 망각(catastrophic forgetting)이 따라옵니다. 기존 완화 기법들은 PEFT 기반의 지나치게 제약적인 부분공간 직교성 조건에 묶여 신규 학습 여력까지 깎았습니다. JANUS는 파라미터 업데이트를 야코비안 영공간(Jacobian null space)에 투영해, 1차 근사에서 과거 성능 보존의 필요충분조건인 파라미터 공간 직교성을 직접 만족시킵니다. 학습 방식과 무관한 순수 사후(post-hoc) 교정이라 파인튜닝 과정을 건드리지 않습니다.
💡망각을 막으려고 학습 파이프라인을 다시 짜지 않아도 된다는 접근입니다. 이미 파인튜닝해 둔 모델에 나중에 끼워 넣을 수 있다는 점이 실무적입니다.
원문 →#지속학습#catastrophic forgetting#파인튜닝#JANUS#arXiv
🧬

메타러닝

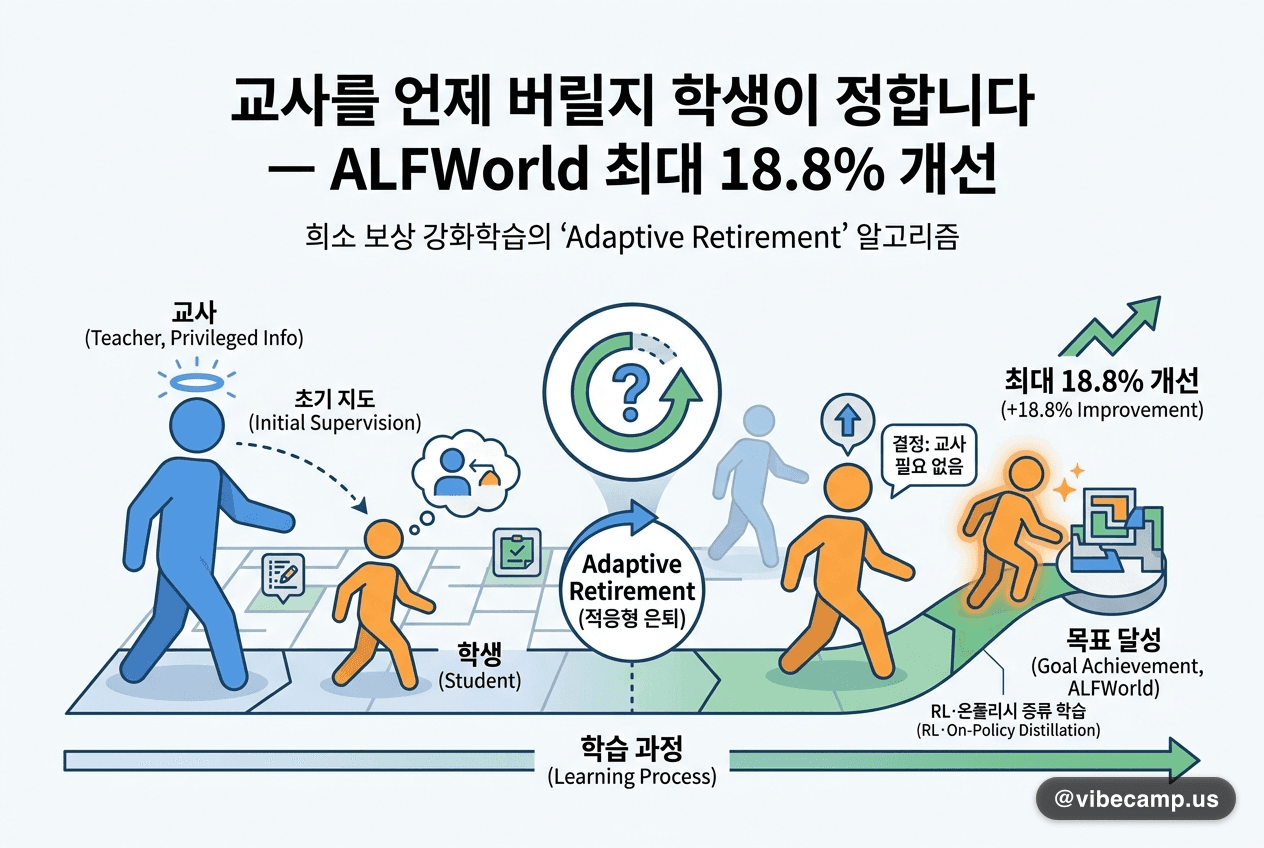
교사를 언제 버릴지 학생이 정합니다 — ALFWorld 최대 18.8% 개선

교사를 언제 버릴지 학생이 정합니다 — ALFWorld 최대 18.8% 개선

#
희소 보상 멀티턴 강화학습에서는 privileged information을 가진 교사도 항상 믿을 만하지 않고, supervision의 효용이 학습 단계마다 달라집니다. RetireOPD는 스킬 조건부 교사와 스킬 프리 학생을 RL·온폴리시 증류로 함께 학습시킵니다. 핵심은 Adaptive Retirement로, 고정 스케줄 대신 교사와 학생의 격차가 더 줄지 않는 순간 학생이 스스로 교사를 끊습니다. Qwen2.5 1.5B~7B 전 구간에서 ALFWorld 14.1~18.8%, WebShop 11.8~19.0% 개선하며 모든 설정에서 교사 성능을 넘었습니다.
💡증류를 언제 끝낼지는 손으로 정하는 스케줄이 아니라 학습 대상이 될 수 있습니다. 후반부의 교사는 도움이 아니라 상한선이 됩니다.
원문 →#메타러닝#on-policy distillation#강화학습#에이전트#arXiv

이 호가 도움됐다면 공유해 주세요 — 빌더 한 명이 더 알게 됩니다.

📤 공유하기𝕏@inf💬✈B✉