본문으로 건너뛰기
← vibecamp ai model 목록

vibecamp ai model · #26 · 2026-09-17

vibecamp ai model 2026-09-17 — 파라미터를 다 건드리지 않았습니다 — 태스크 100개 뒤 13.34%p

2026-09-17 AI 모델 일간 호 — 오늘 4개 카드를 정리했습니다.

4개 카드 · 적은 예제로 스스로 깨우치는 학습법 일간

📤 공유하기𝕏@inf💬✈B✉
📚

커리큘럼 학습

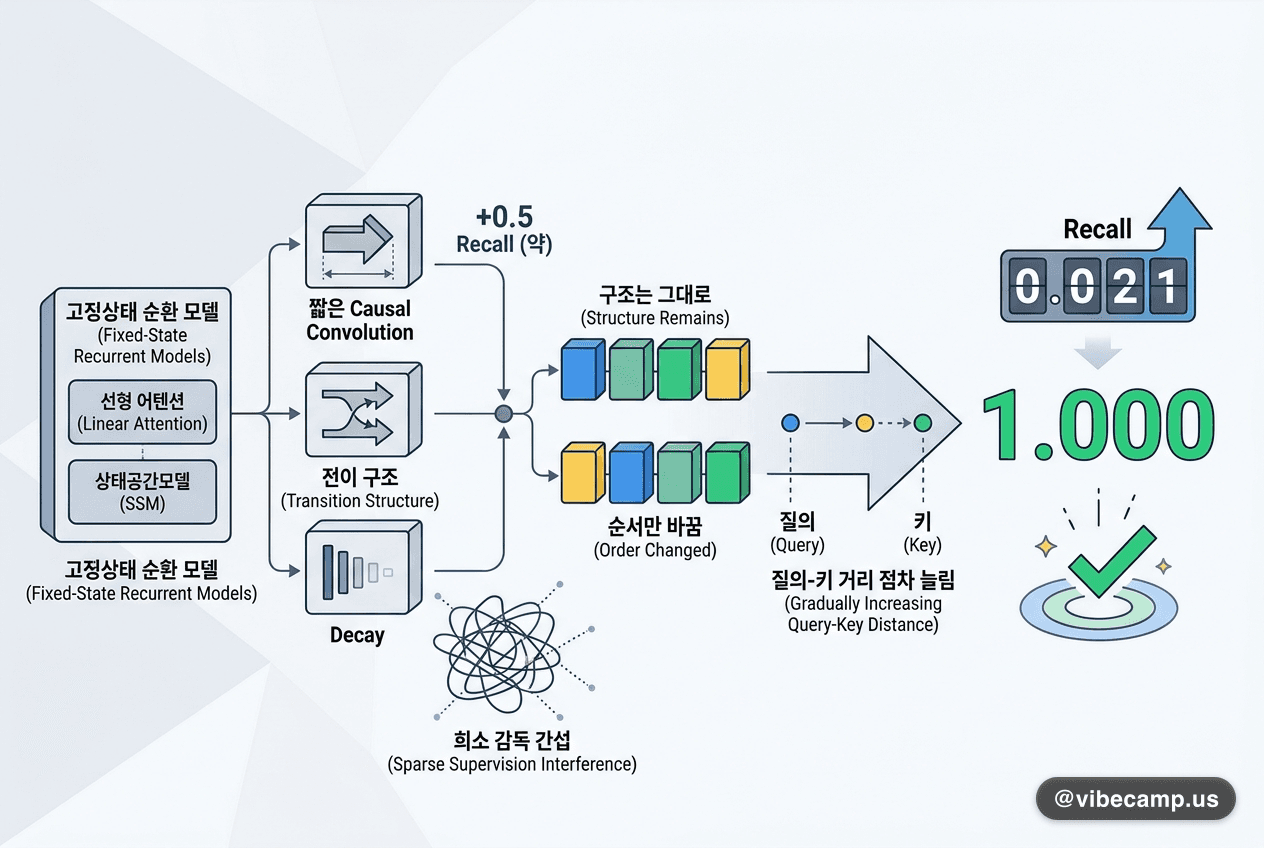
구조는 그대로 두고 순서만 바꿨더니 recall 0.021→1.000

구조는 그대로 두고 순서만 바꿨더니 recall 0.021→1.000

#
선형 어텐션과 상태공간모델(SSM) 같은 고정상태 순환 모델이 연상 기억에 약한 이유를 짧은 causal convolution·전이 구조·decay 세 축으로 분해했습니다. 가장 큰 요인은 convolution이었고(약 +0.5 recall), 진짜 원인은 용량이 아니라 희소 감독 아래의 간섭이었습니다. 구조는 그대로 둔 채 질의-키 거리를 점차 늘리는 커리큘럼만 적용하자 recall 0.021→1.000, 성공 시드 1/10→7/10(p=0.02). 저자가 예비 결과라고 밝힌 프리프린트입니다.
💡모델 구조를 바꾸기 전에 학습 순서를 먼저 의심해 볼 근거입니다. 같은 구조가 무엇을 언제 보느냐에 따라 거의 못 푸는 상태와 다 푸는 상태로 갈렸습니다.
원문 →#curriculum-learning#ssm#linear-attention#arxiv
🔄

지속학습

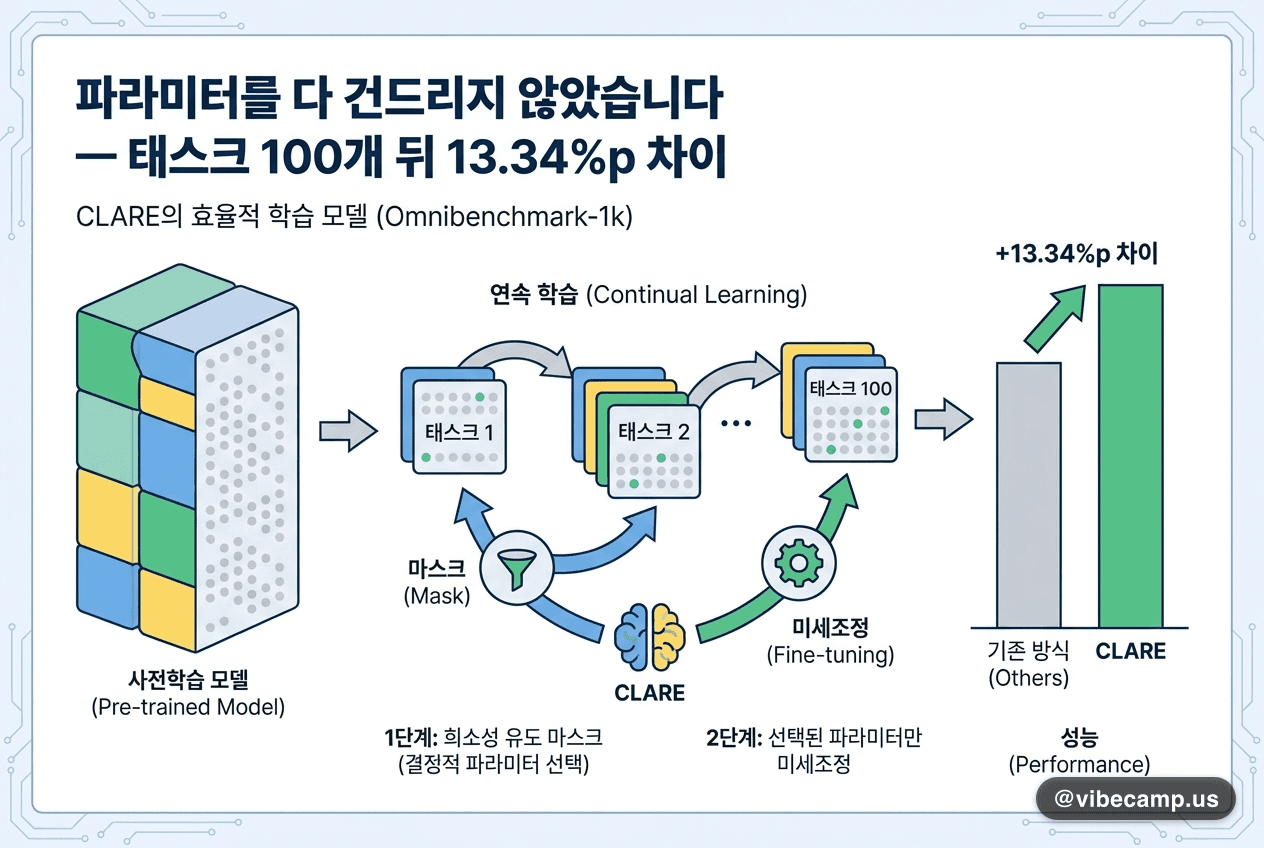
파라미터를 다 건드리지 않았습니다 — 태스크 100개 뒤 13.34%p 차이

파라미터를 다 건드리지 않았습니다 — 태스크 100개 뒤 13.34%p 차이

#
CLARE는 사전학습 모델을 이어서 학습할 때 태스크마다 어댑터(adapter)를 늘리지 않습니다. 먼저 희소성 유도 목적함수로 해당 태스크에 결정적인 파라미터만 골라 마스크(mask)를 만들고, 그다음 그 마스크가 선택한 파라미터만 미세조정하는 2단계 구조입니다. 긴 태스크 시퀀스 벤치마크 Omnibenchmark-1k에서 태스크 100개를 학습한 뒤 최종 정확도가 강력한 베이스라인 EASE보다 각각 4.64%p, 13.34%p 높았습니다. BMVC2026 채택 논문입니다.
💡태스크가 수십, 수백 개로 늘어나는 증분 학습의 병목은 용량이 아니라 태스크 간 간섭이었습니다. 어댑터를 늘리는 대신 어디만 건드릴지 고르는 쪽이 길게 버팁니다.
원문 →#continual-learning#sparsity#fine-tuning#arxiv
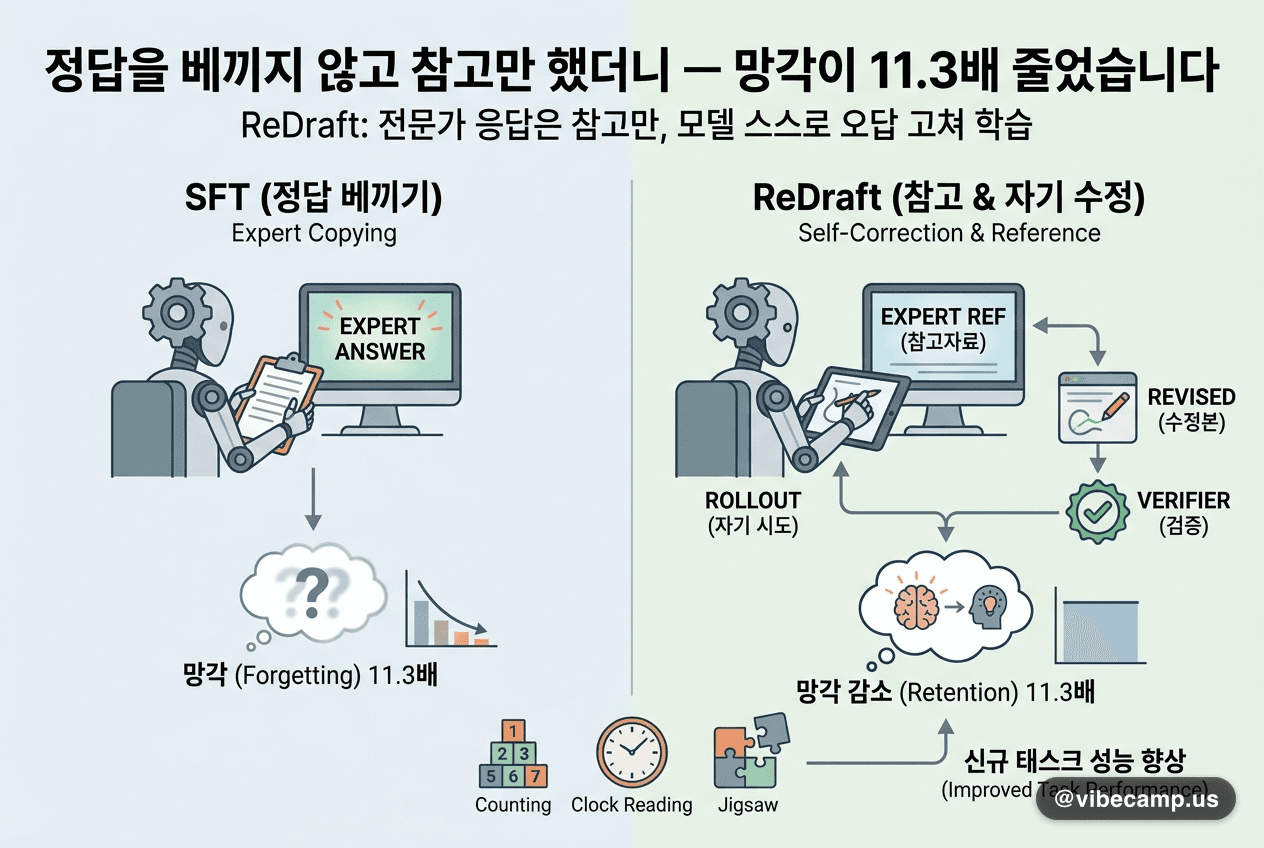
정답을 베끼지 않고 참고만 했더니 — 망각이 11.3배 줄었습니다

정답을 베끼지 않고 참고만 했더니 — 망각이 11.3배 줄었습니다

#
ReDraft는 전문가 응답을 그대로 베껴 학습하는 SFT 대신, 그 응답을 참고자료로만 씁니다. 모델이 자기 오답 롤아웃(rollout)을 스스로 고치게 하고, 검증기가 통과시킨 수정본만 남겨 학습합니다. Qwen2.5-VL-3B/7B의 Counting·Clock Reading·Jigsaw에서 신규 태스크 성능은 SFT 52.9점 대비 56.9점으로 앞섰고, 기존 태스크 손실은 16.6→1.5점으로 망각이 11.3배 줄었습니다. 자기증류(OPSD)와 비교해도 습득과 망각 양쪽에서 우위였습니다.
💡새 능력을 붙이면 옛 능력이 깎이는 딜레마의 실용적 답입니다. 정답 주입이 아니라 참고 후 자기수정, 검증 통과분만 학습이라는 데이터 만드는 순서가 핵심입니다.
원문 →#continual-learning#multimodal#post-training#arxiv
🧬

메타러닝

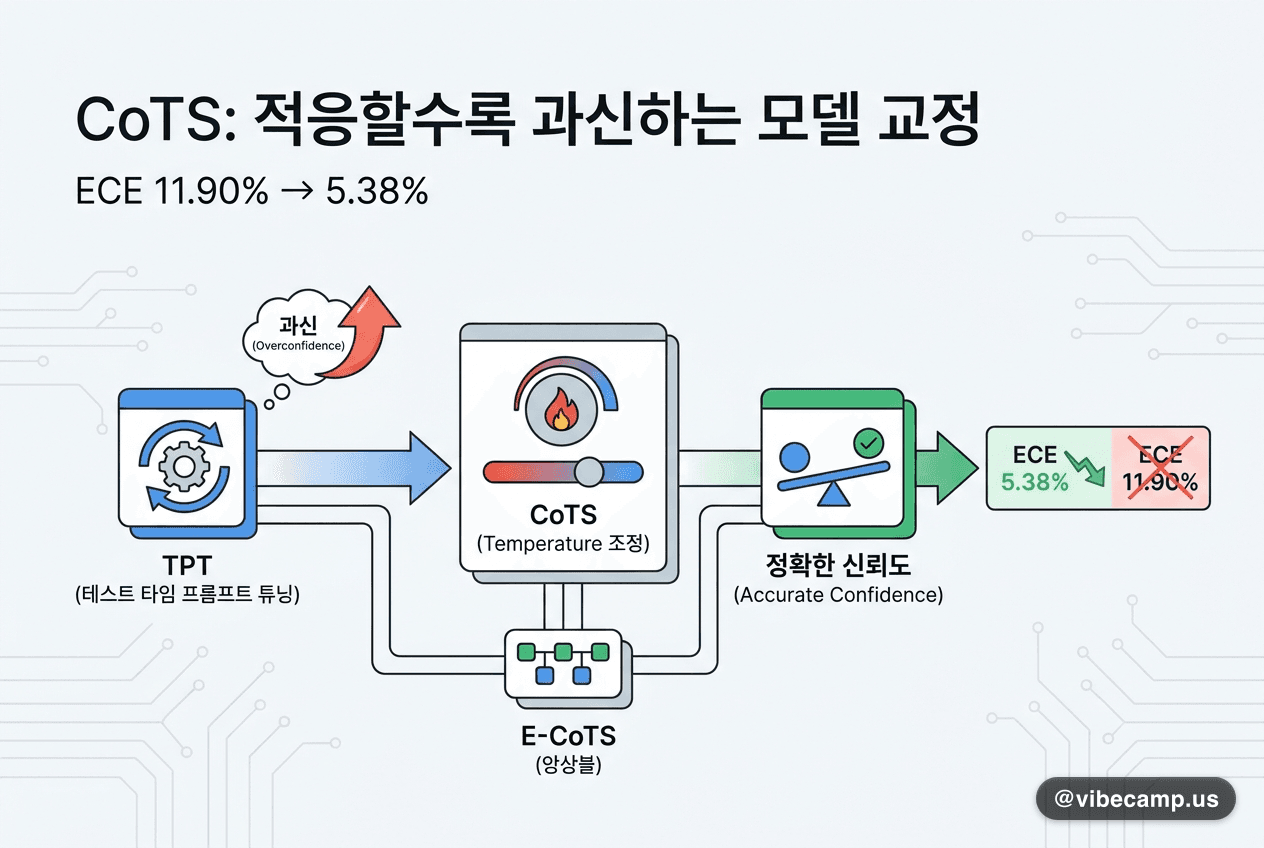
적응할수록 과신하는 모델 — 온도만 맞춰 ECE 11.90→5.38%

적응할수록 과신하는 모델 — 온도만 맞춰 ECE 11.90→5.38%

#
테스트 타임 프롬프트 튜닝(TPT)은 라벨 없이 추론 시점에 프롬프트만 갱신해 새 분포에 적응하지만, 적응할수록 확률값이 실제 정확도보다 부풀려집니다. CoTS는 적응 후 예측과 제로샷 예측 사이의 확신 격차를 줄이는 방향으로 온도(temperature)만 조정하는 사후 교정 기법입니다. 여기에 약-강 앙상블을 더한 E-CoTS는 ImageNet 변형군에서 평균 ECE를 11.90→5.38%로 낮추면서 정확도도 60.74→62.95%로 함께 끌어올렸습니다.
💡확률값을 기준으로 라우팅하거나 기권시키는 파이프라인이라면, 적응 뒤 교정은 선택이 아니라 필수 단계입니다. 정확도를 내주지 않고도 교정이 된다는 점이 특히 실무적입니다.
원문 →#meta-learning#test-time-adaptation#calibration#arxiv

이 호가 도움됐다면 공유해 주세요 — 빌더 한 명이 더 알게 됩니다.

📤 공유하기𝕏@inf💬✈B✉