본문으로 건너뛰기
← vibecamp ai model 목록

vibecamp ai model · #25 · 2026-09-15

vibecamp ai model 2026-09-15 — 검사를 8번에서 3번으로 — 설명이 특징 수집 순서를 결정합니다

2026-09-15 AI 모델 일간 호 — 오늘 8개 카드를 정리했습니다.

8개 카드 · 적은 예제로 스스로 깨우치는 학습법 일간

📤 공유하기𝕏@inf💬✈B✉
🎯

퓨샷 학습

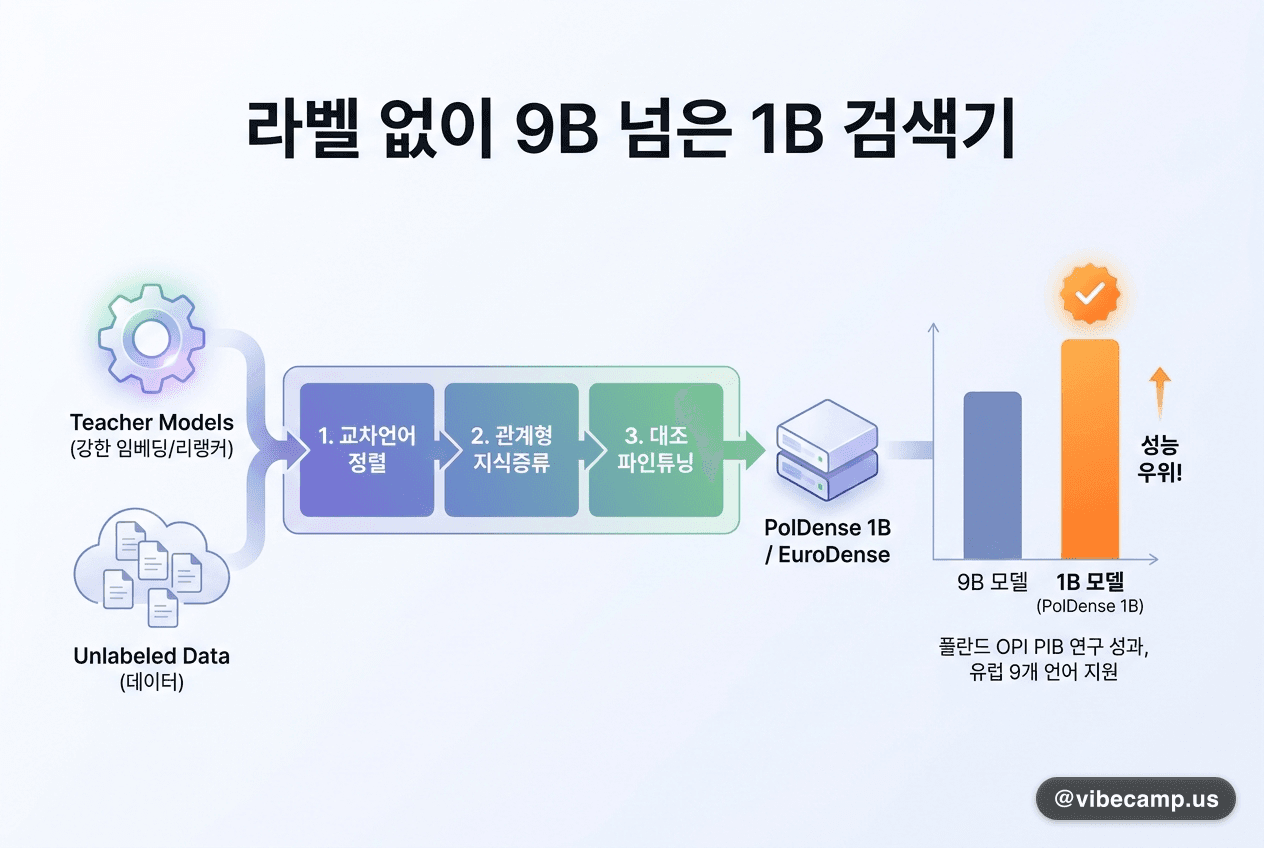
라벨 한 건 없이 학습한 1B 검색기가 9B 모델을 앞섰습니다

라벨 한 건 없이 학습한 1B 검색기가 9B 모델을 앞섰습니다

#
폴란드 국립정보처리연구소 계열 연구진이 사람이 붙인 관련성 라벨을 한 건도 쓰지 않고 경량 검색기를 학습시켰습니다. 강한 임베딩 모델과 리랭커를 교사로 세워 그 출력만으로 감독 신호를 만들고, 교차언어 정렬 → 관계형 지식증류 → 대조 파인튜닝 3단계로 학습합니다. 결과물은 폴란드어 6종 PolDense(17M~1B)와 유럽 9개 언어용 EuroDense(435M)입니다. 폴란드어 41개·다국어 150개 검색 태스크 평가에서 PolDense-1B는 최대 9B 파라미터 모델을 앞섰고, 1B 미만 구간에서는 EuroDense가 태스크·언어 평균 모두 1위이자 9개 언어 중 7개에서 선두였습니다. 모델은 전부 공개됐습니다.
💡저자원 언어 검색기는 라벨을 모으는 대신 강한 교사 모델의 출력을 증류하는 쪽이 빠릅니다 — 한국어에도 그대로 이식되는 레시피입니다.
원문 →#지식증류#dense retrieval#저자원 언어#경량 모델#오픈소스
📚

커리큘럼 학습

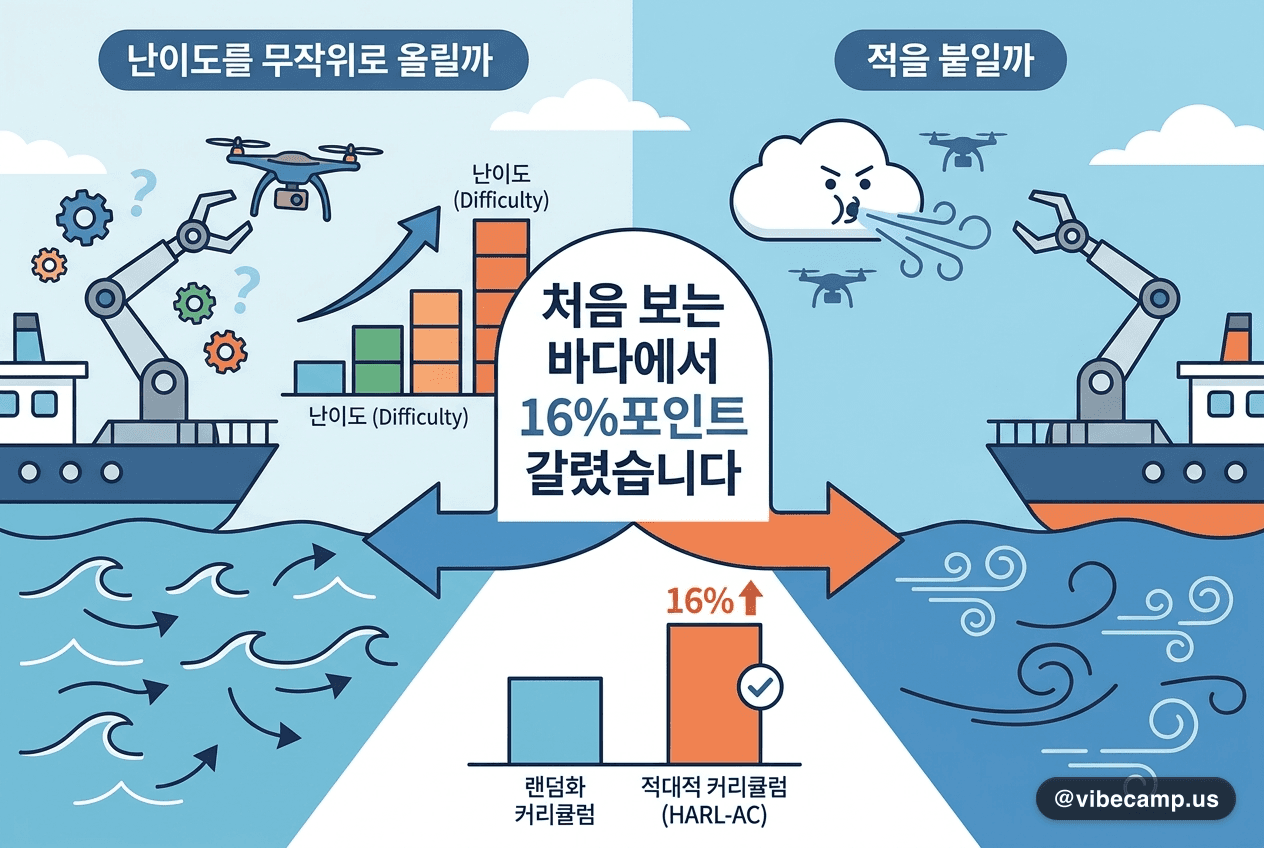
난이도를 무작위로 올릴까, 적을 붙일까 — 처음 보는 바다에서 16%포인트 갈렸습니다

난이도를 무작위로 올릴까, 적을 붙일까 — 처음 보는 바다에서 16%포인트 갈렸습니다

#
Maastricht University 등 연구진이 NVIDIA Isaac Lab에서 함정 갑판의 로봇 팔이 비행 중인 쿼드콥터를 공중에서 낚아채 회수하는 정책을 HAPPO로 학습시켰습니다. 난이도를 점점 올리는 도메인 랜덤화 커리큘럼과, 바람을 만드는 적대적 에이전트를 함께 학습시키는 커리큘럼(HARL-AC)을 정면 비교했습니다. 표준 조건에서는 두 방식 모두 최대 97.5% 성공률로 대등했지만, 학습 때 본 적 없는 해상 상태에서는 적대적 커리큘럼이 sea state 10 기준 중앙값 성공률이 16%포인트 높았고 충돌률을 최대 14% 낮췄습니다. 타임아웃이 조금 늘어나는 대신 더 신중하게 회수하는 행동을 학습한 결과입니다.
💡커리큘럼의 일반화 성능은 난이도의 크기가 아니라 난이도를 올려주는 주체가 가릅니다 — 스케줄러냐, 적대적 상대냐.
원문 →#커리큘럼 학습#adversarial training#멀티에이전트 RL#Isaac Lab#일반화
🪞

자가수정 학습

실패한 쿼리의 91.7%를 되살렸지만 — 정교한 피드백은 거의 무의미했습니다

실패한 쿼리의 91.7%를 되살렸지만 — 정교한 피드백은 거의 무의미했습니다

#
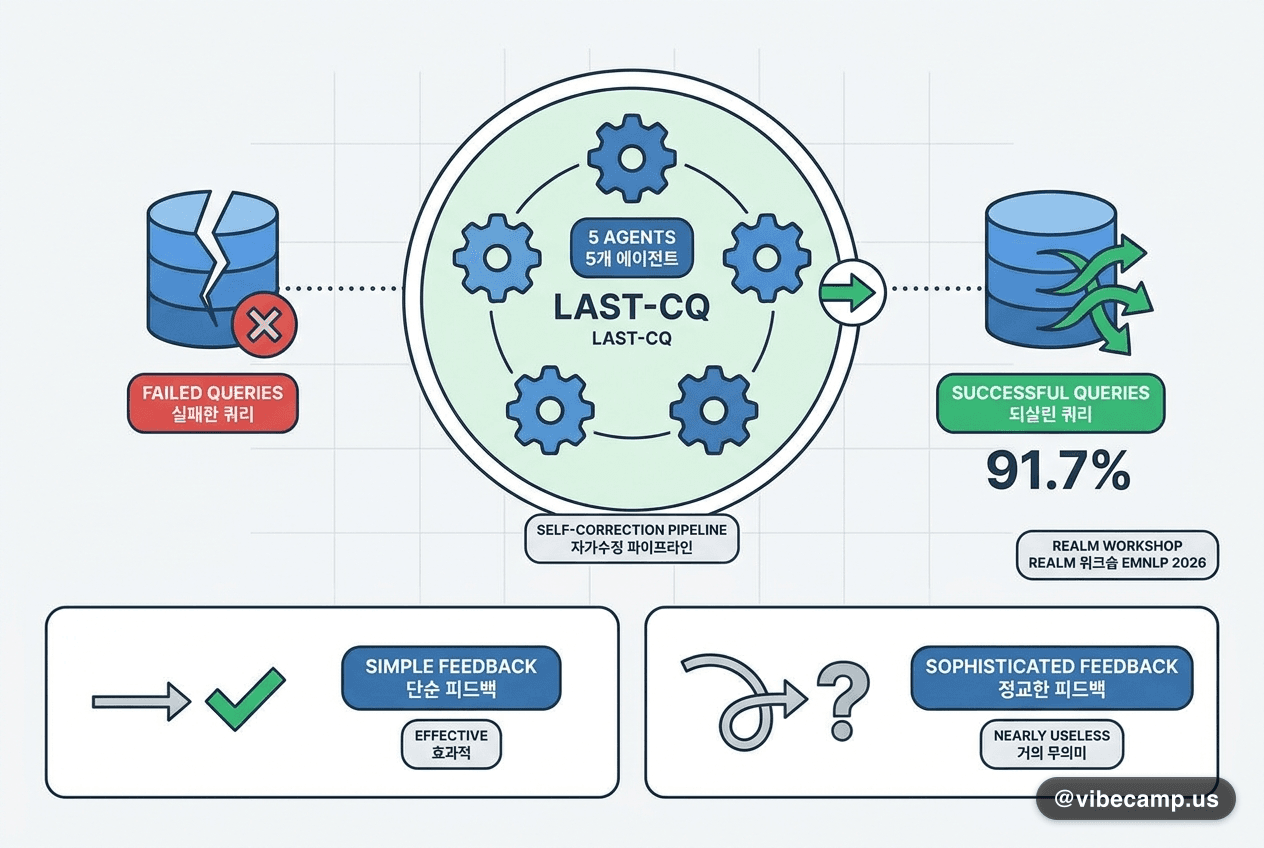
EMNLP 2026 REALM 워크숍에 채택된 LAST-CQ는 추가 학습 없이 실행 결과에 근거해 스스로 쿼리를 고치는 5개 에이전트 자가수정 파이프라인입니다. 연구진은 성능 향상이 어디서 오는지 구성요소별로 분해해, 실제 데이터베이스 쿼리 2,471건과 3개 벤더 규모 계층에 걸친 6개 백본에서 측정했습니다. 자가수정 단계는 실행 BLEU를 3.1~12.3% 끌어올렸고 단발 생성에서 실패한 쿼리의 91.7%를 회복했지만, 스키마를 반영한 정교한 피드백이 DB가 그냥 뱉는 에러 메시지와 사실상 같은 회복률을 냈습니다. 반대로 병렬 샘플링은 품질을 10~11% 떨어뜨렸고, LLM 심판 점수는 사람 라벨보다 9점 낙관적이었습니다.
💡자가수정은 피드백을 정교하게 깎기 전에 실행 에러 메시지부터 되먹이세요. 자체 LLM 평가치는 9점쯤 깎아 보는 편이 안전합니다.
원문 →#자가수정#self-refinement#text-to-Cypher#LLM-as-judge#에이전트
실기기에서 난 실패를 버리지 않았더니 — MobileGUI-VBench 87.4점

실기기에서 난 실패를 버리지 않았더니 — MobileGUI-VBench 87.4점

#
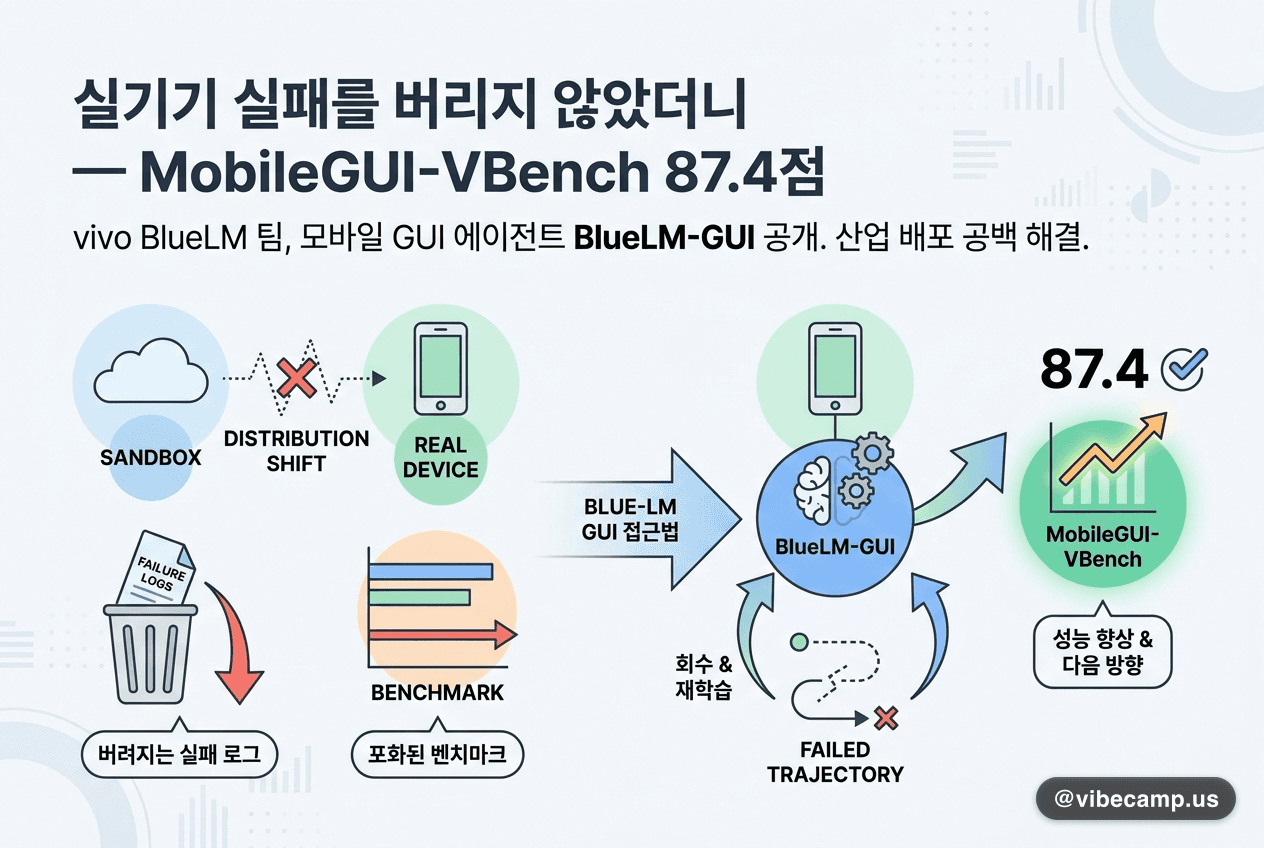
vivo BlueLM 팀이 모바일 GUI 에이전트 BlueLM-GUI를 공개했습니다. 저자들은 산업 배포에 세 가지 공백이 있다고 지적합니다 — 샌드박스 학습은 실제 단말과 분포가 어긋나고, 비싸게 얻은 실기기 실패 로그는 버려지며, 고정된 벤치마크는 포화돼 다음 개선 방향을 알려주지 못합니다. BlueLM-GUI는 실기기에서 실패한 궤적을 회수해 다시 학습 신호로 되먹이고 벤치마크도 함께 갱신하는 자기개선 플라이휠로 이 셋을 동시에 공략합니다. 총 35B·활성 3B 규모 모델은 MobileGUI-VBench에서 87.4점으로 가장 강한 비공개 모델을 5.1점 앞섰고, AndroidWorld에서는 84.9점으로 오픈소스 최고이자 비공개 모델과 대등했습니다.
💡운영에서 나온 실패 로그가 가장 싼 학습 데이터입니다. 실패를 회수해 되먹이는 경로를 설계 단계에서 미리 뚫어두세요.
원문 →#GUI 에이전트#자기개선#플라이휠#모바일 AI#오픈소스 모델
🧪

액티브러닝

검사를 8번에서 3번으로 — 설명이 특징 수집 순서를 결정합니다

검사를 8번에서 3번으로 — 설명이 특징 수집 순서를 결정합니다

#
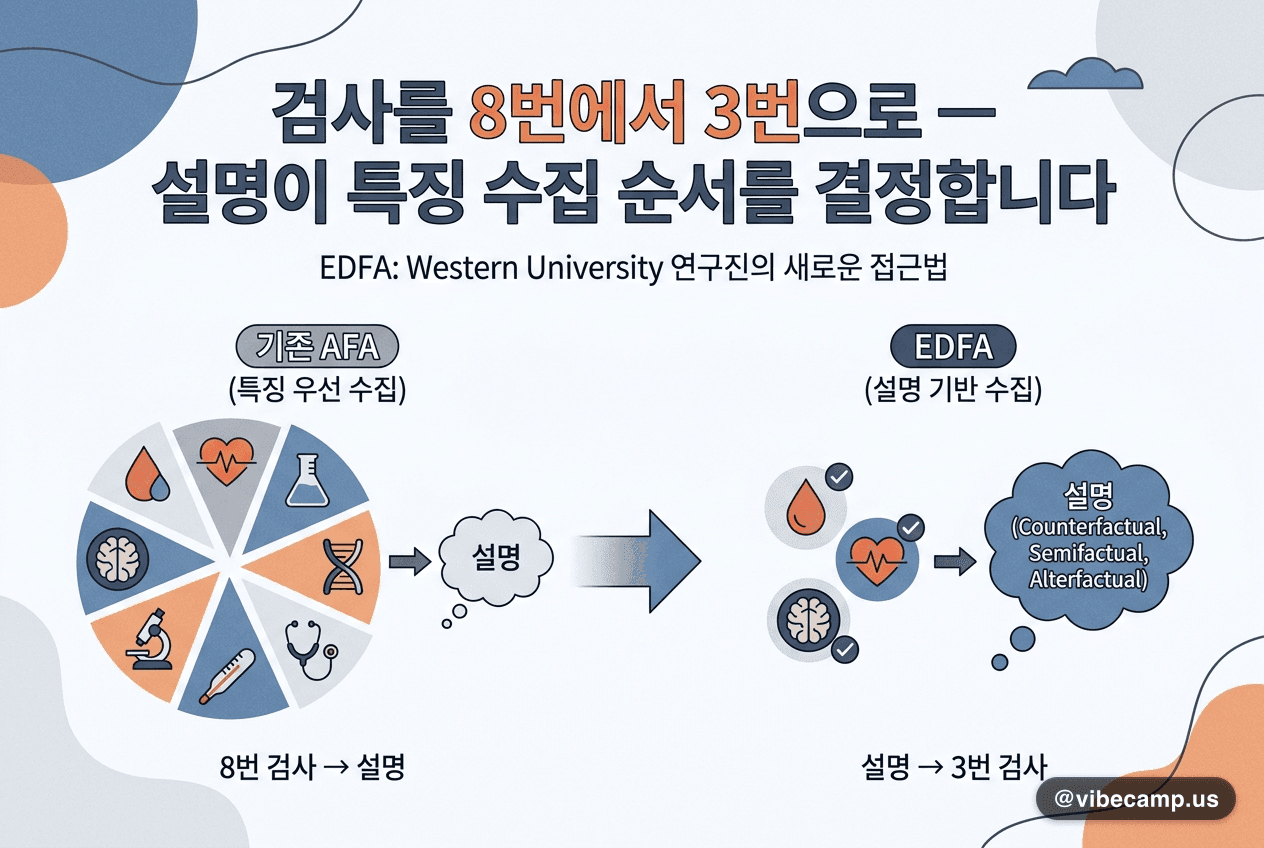
기존 액티브 특징 획득(AFA)은 특징을 다 모은 뒤에야 설명을 붙였습니다. Western University 연구진의 EDFA는 순서를 뒤집어, counterfactual·semifactual·alterfactual 설명을 마르코프 블랭킷 이론으로 통합하고 단위 비용당 설명 가치가 높은 특징만 골라 수집합니다. 공개 데이터셋 7종 실험에서 최신 AFA 베이스라인보다 훨씬 적은 특징을 모으고도 정확도는 대등했고, 한 사례에서는 베이스라인 DIME이 8회 획득한 것을 3회로 끝냈습니다. 부분 정보 단계에서 조기 종료한 사용자의 80% 이상이 전체 정보를 모은 뒤에도 유효한 recourse를 유지함을 95% 신뢰수준에서 분포 무가정으로 보증했습니다.
💡데이터 수집에 비용이 붙는다면, 예측에 도움되는 특징이 아니라 사용자가 행동할 근거를 만드는 특징을 먼저 물어야 합니다.
원문 →#액티브 러닝#active feature acquisition#설명가능성#recourse#arXiv
골드 라벨 0건으로 도메인 추출기 만들기 — 경량 모델이 뽑고 LLM이 채점합니다

골드 라벨 0건으로 도메인 추출기 만들기 — 경량 모델이 뽑고 LLM이 채점합니다

#
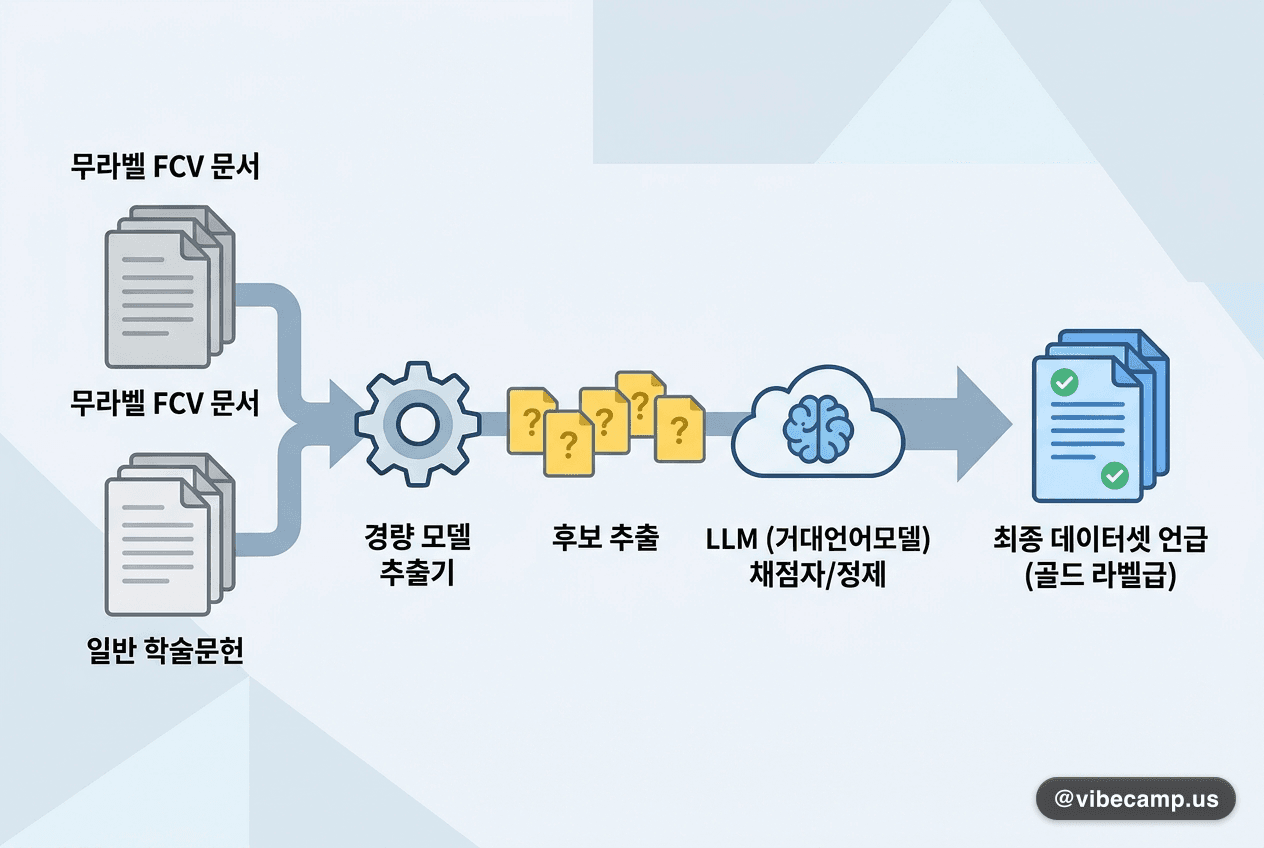
World Bank 데이터그룹 계열 연구진이 강제 이주·분쟁취약(FCV) 문서에서 데이터셋 언급을 찾아내는 추출기를 수작업 라벨 코퍼스 없이 만들었습니다. 액티브 러닝이라기보다 약지도(weakly supervised) 학습에 LLM 라벨 정제를 붙인 파이프라인에 가깝습니다. 일반 학술문헌으로 학습한 경량 모델이 라벨 없는 도메인 문서에서 후보를 뽑으면, 프런티어 LLM이 문맥에서 검증·기각하고 추출 경계를 교정한 뒤, 합성·대조 예시를 더해 경량 모델을 다시 파인튜닝합니다. 독립 골드 벤치마크 1,706개 문단에서 언급 단위 정밀도 74.1%·재현율 70.5%, 데이터셋 참조가 실제로 포함된 문단만 보면 정밀도 89.5%, 문단 단위로는 정확도 88.2%·특이도 88.6%였습니다.
💡라벨 예산이 없는 도메인에서는 사람 대신 LLM을 채점자로 세우는 쪽이, 수천 건 수작업보다 먼저 시도해볼 값싼 경로입니다.
원문 →#약지도 학습#weak supervision#LLM 라벨링#정보 추출#arXiv
🔄

지속학습

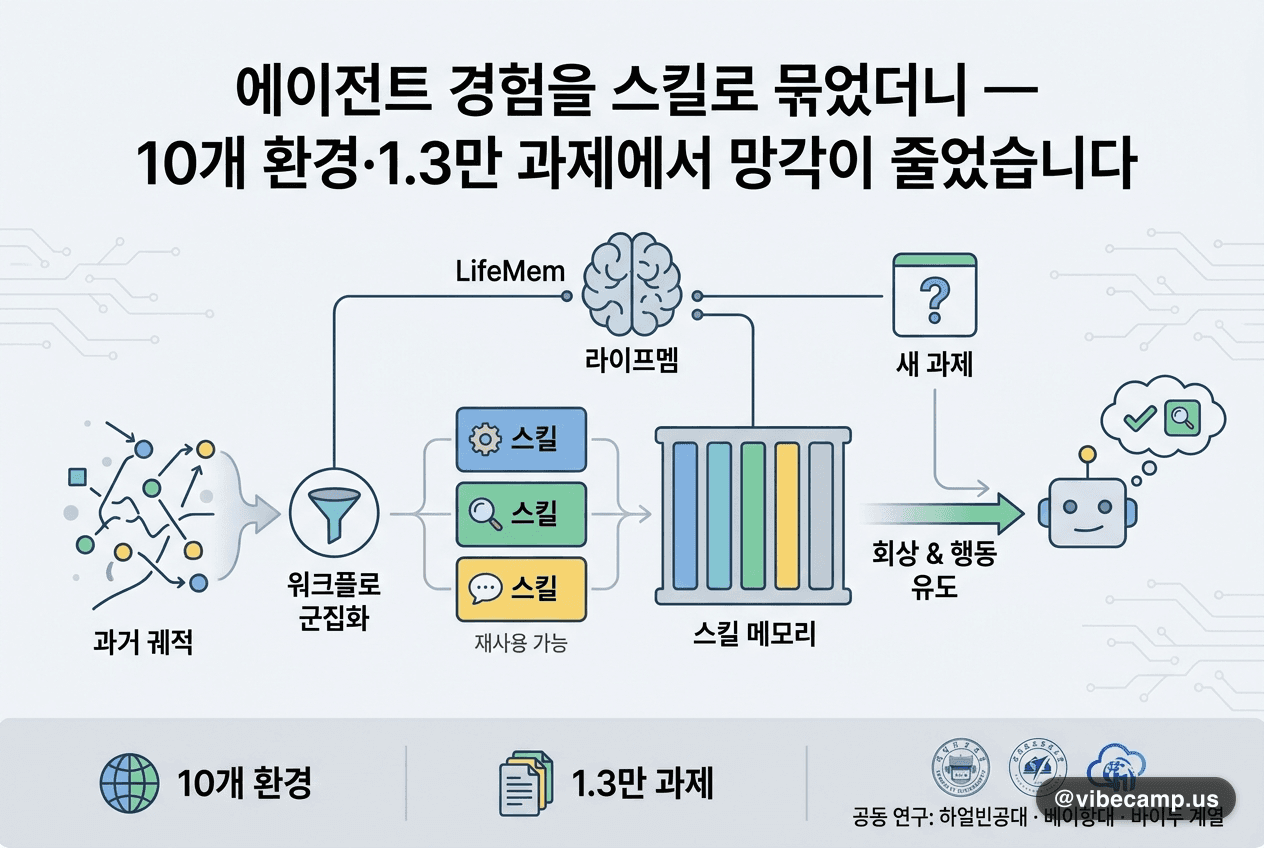
에이전트 경험을 스킬로 묶었더니 — 10개 환경·1.3만 과제에서 망각이 줄었습니다

에이전트 경험을 스킬로 묶었더니 — 10개 환경·1.3만 과제에서 망각이 줄었습니다

#
하얼빈공대·베이항대·바이두 계열 공동 연구진이 LLM 에이전트용 평생학습 메모리 프레임워크 LifeMem을 공개했습니다. 쌓인 상호작용 궤적을 밑에 깔린 워크플로 기준으로 군집화해 재사용 가능한 스킬로 뽑아두고, 새 과제를 만나면 관련 스킬과 궤적만 회상해 행동을 유도하는 구조입니다. 10개 환경·1.3만여 과제와 새로 주석한 궤적 2천 건으로 검증한 결과, 이미 배운 과제의 망각을 줄이면서 교차 과제 전이 성능은 기존 방식보다 앞섰습니다. 추가 분석에서는 구조적으로 비슷한 궤적을 메모리 안에서 통합할수록 성능이 올랐고, 과제가 주어지는 순서(task streaming) 자체가 학습 결과를 좌우했습니다.
💡에이전트 메모리는 로그로 쌓지 말고 워크플로 단위로 묶으세요. 어떤 과제를 어떤 순서로 주느냐까지가 학습 설계의 일부입니다.
원문 →#평생학습#continual learning#에이전트 메모리#파국적 망각#arXiv
🧬

메타러닝

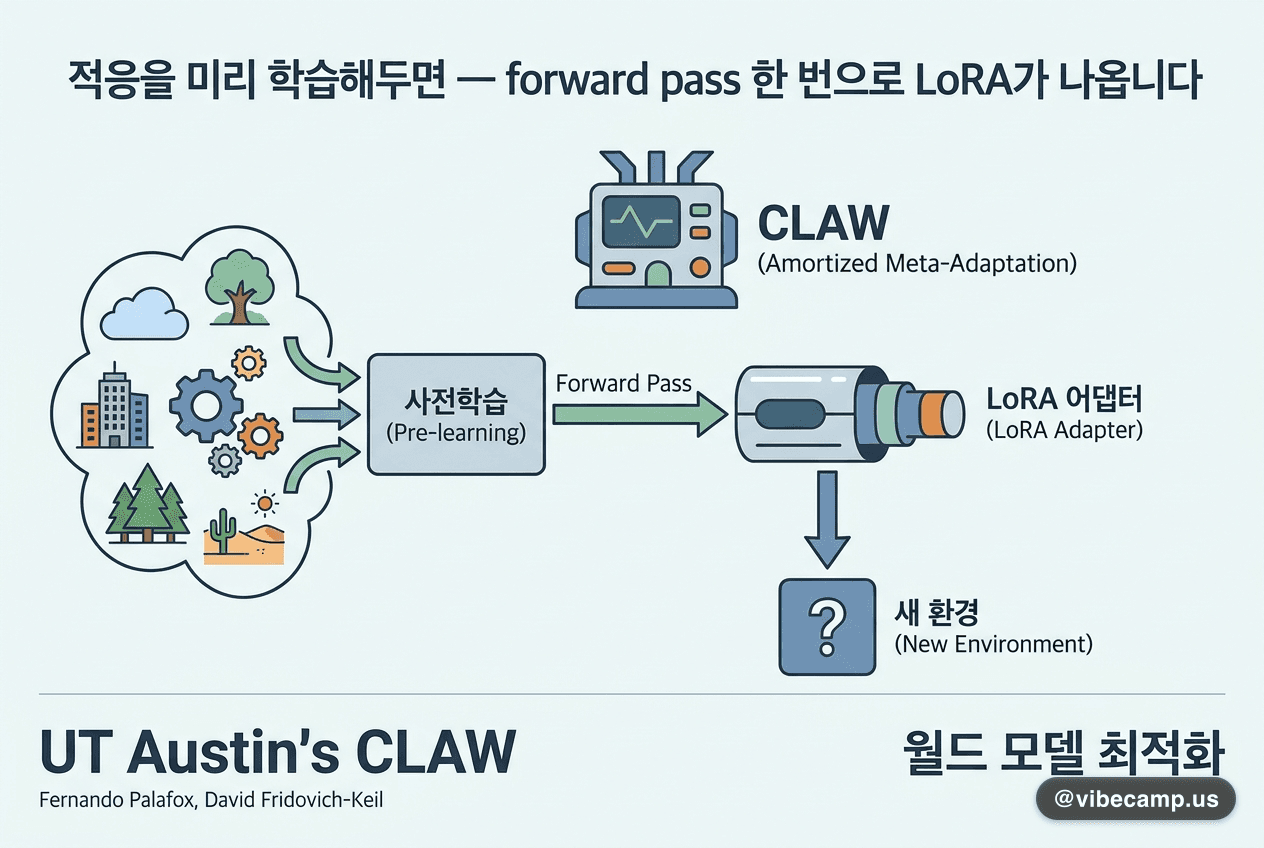
적응을 미리 학습해두면 — forward pass 한 번으로 LoRA가 나옵니다

적응을 미리 학습해두면 — forward pass 한 번으로 LoRA가 나옵니다

#
UT Austin의 Fernando Palafox와 David Fridovich-Keil이 월드 모델을 새 환경에 맞추는 amortized 메타적응 기법 CLAW를 제안했습니다. 하이퍼네트워크가 테스트 시점에 저랭크(LoRA) 어댑터를 단 한 번의 forward pass로 생성하는 방식으로, 사전학습 단계에서 다양한 환경으로의 적응을 시뮬레이션하며 하이퍼네트워크와 베이스 월드 모델을 함께 학습합니다. 테스트할 때는 베이스를 동결한 채 소량의 transition 배치만 넣으면 됩니다. 동역학·신체구조·보상이 서로 다른 locomotion·manipulation 환경군에서 수 초 분량의 테스트 시점 데이터만으로 gradient 기반 적응과 in-context learning을 모두 능가했고, 이득의 원천이 context conditioning이 아니라 표현력 있는 어댑터임을 ablation으로 확인했습니다.
💡테스트 시점 파인튜닝이 비싸다면, 적응 과정 자체를 사전학습에 녹여 넣는 amortization이 대안입니다.
원문 →#메타러닝#LoRA#월드 모델#hypernetwork#model-based RL

이 호가 도움됐다면 공유해 주세요 — 빌더 한 명이 더 알게 됩니다.

📤 공유하기𝕏@inf💬✈B✉
vibecamp ai model 2026-09-15 — 검사를 8번에서 3번으로 — 설명이 특징 수집 순서를 결정합니다 | vibecamp ai model