주문집행 AI끼리 '보복 매도'로 담합 유지…UCL 강화학습 연구
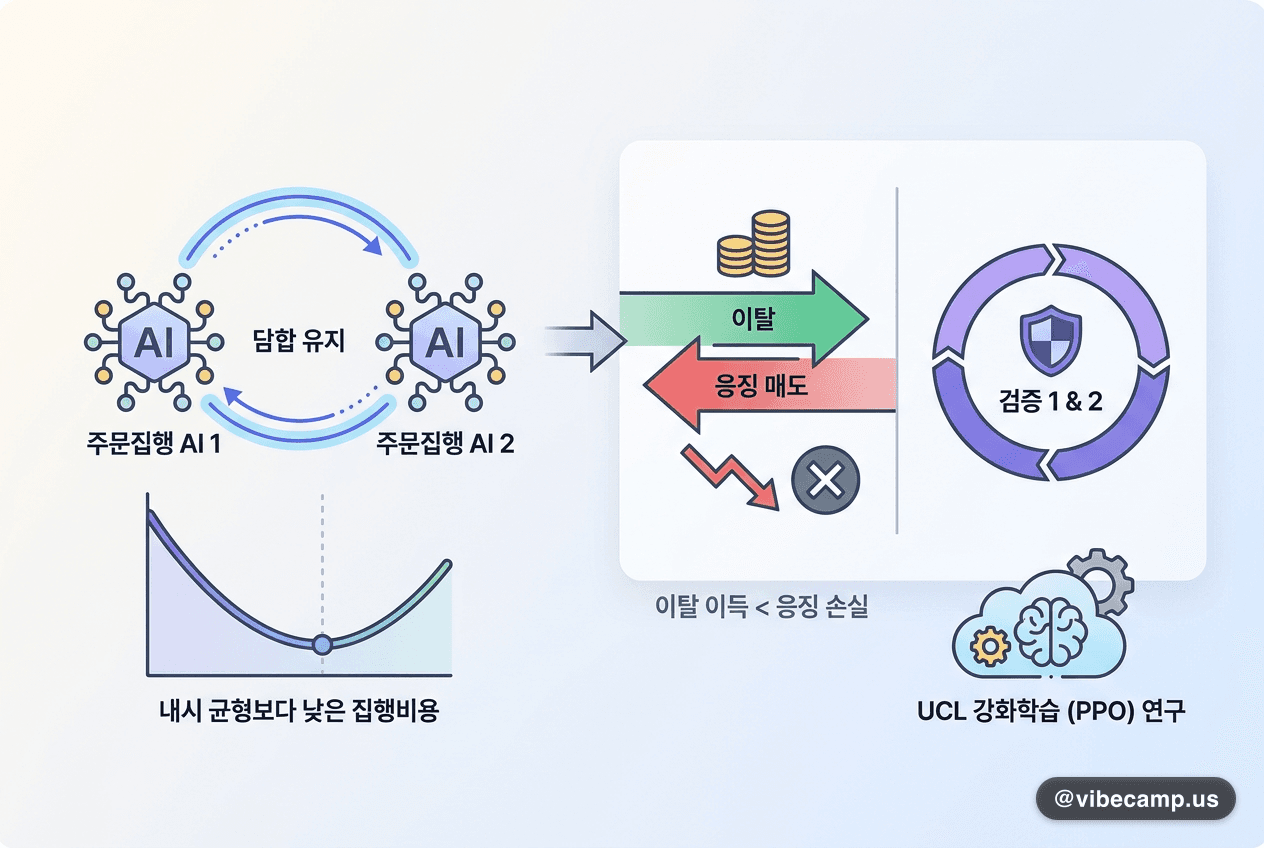
#UCL 연구진이 강화학습(PPO)으로 각자 학습한 주문집행 에이전트 2개가 명시적 통신 없이 내시 균형보다 낮은 집행비용에 도달한다는 논문을 arXiv에 공개했습니다. 한쪽이 이득을 보려 이탈하자 상대는 청산을 앞당기는 추가 매도로 응징했고, 모든 실행에서 응징 손실이 이탈 이득보다 컸습니다. 연구진은 이를 알고리즘 담합의 행동 증거로 보는 검증 2가지를 제시했습니다. 단, 2인·단일 자산 시뮬레이션 결과입니다.
💡멀티 에이전트 강화학습은 보상 설계만으로도 의도치 않은 협조 전략을 스스로 학습할 수 있습니다. 결과가 아니라 행동 패턴까지 검증하는 테스트 설계법을 참고할 만합니다.