본문으로 건너뛰기
← vibecamp ai builder 목록

vibecamp ai builder · #82 · 2026-10-01

vibecamp ai builder 2026-10-01 — 구글 Gemini 4 Argon 발표, 출력 1M 토큰·DeepSWE 7

2026-10-01 AI 빌더 일간 호 — 오늘 11개 카드를 정리했습니다.

11개 카드 · AI Agent 를 만드는 사람의 일간

📤 공유하기𝕏@inf💬✈B✉
🛠

빌더 신호

Gemini 4 Argon 발표 키 아트 — 파란 배경에 Gemini 4 Argon 로고와 숫자 4

구글 Gemini 4 Argon 발표, 출력 1M 토큰·DeepSWE 77.9%

#
구글이 9/30 새 프런티어 모델 Gemini 4 Argon을 발표했습니다. 출력 토큰 한도를 64K→1M 토큰으로 늘렸고, 코딩 벤치마크 DeepSWE v1.1에서 77.9%로 최고 기록(SOTA)을 냈다고 밝혔습니다. 다만 현재는 Fairwind Program을 통해 선별된 사이버 방어 조직에만 단계적으로 제공되며, 개발자·기업 공개 시점은 정해지지 않았습니다. 출시 시 도입가는 1M 토큰당 입력 $2, 출력 $10입니다.
💡출력 1M 토큰은 대규모 코드 마이그레이션처럼 긴 산출물을 한 번에 뽑는 장기 에이전트 작업(long-horizon agent)을 겨냥합니다. 일반 공개 전까지는 설계 방향을 읽는 참고 자료로 보세요.
원문 →#gemini#google#frontier-model#long-horizon#cybersecurity
OpenAI 발표 대표 이미지 — 'Disrupting a coordinated model-distillation campaign' 제목 타이포그래피

OpenAI, 숨은 추론 빼내는 모델 증류 캠페인 적발·차단

#
OpenAI는 9/30 모델의 숨겨진 추론(protected reasoning)을 빼내 다른 모델 학습에 쓰려던 증류(distillation) 캠페인을 적발·차단했다고 밝혔습니다. 7/1 시작, 7/24~25 4,000명 이상이 16,000건으로 급증했고 15,000명 이상 클러스터를 7/28까지 막았습니다. 암호화된 추론을 다른 대화에서 복호화시키는 수법도 있었습니다. OpenAI는 핵심 클러스터를 Kimi 개발사 Moonshot AI 관련 개인들로 지목했는데, 이는 OpenAI 측 주장입니다.
💡추론 모델 API로 서비스를 만든다면 모델이 내놓는 추론 산출물 자체가 재사용·유출되는 공격면이 될 수 있다는 점을 보안 설계에 넣어 둘 만합니다.
원문 →#openai#distillation#ai-security#reasoning-model
Cloudflare 블로그 대표 이미지 — 'Cloudflare Containers, rebuilt to scale agent sandboxes' 제목과 모래상자 일러스트

Cloudflare, 에이전트 샌드박스용 컨테이너 재설계…기동 648ms

#
Cloudflare가 9/30 Containers를 에이전트용 샌드박스(sandbox)에 맞게 재설계했다고 발표했습니다. 에이전트는 작업마다 샌드박스를 즉석에서 만들고 멈췄다 재개하기 때문에, 이제 코드에서 런타임에 샌드박스별 이미지·인스턴스 타입을 고를 수 있습니다. 기동은 6배 빨라져 중앙값이 4초대→648ms로 줄었고, 파일시스템 스냅샷이 퍼블릭 베타로, Sandbox SDK가 1.0으로 나왔습니다. Base44·Kilo Code가 사례로 소개됐습니다.
💡코딩 에이전트나 평가 환경을 작업 단위 격리 공간으로 띄우려는 빌더라면, 기동 지연과 상태 보존 문제를 어떻게 풀었는지 참고할 만한 구조입니다.
원문 →#cloudflare#sandbox#agent-infra#containers
🏆

해커톤·대회

Elastic 'Forge the Future Hackathon 2026' 뭄바이 행사 배너

Elastic 인도 해커톤 대상 Vigil, 영업 통화 규정 위반 자동 감사

#
Elastic이 인도 'Forge the Future Hackathon 2026' 수상작을 9/30 Elastic{ON} Mumbai에서 시상했습니다. 8,000명 등록·300개 아이디어 중 20팀이 벵갈루루 2일 결선에 올랐습니다. 대상 Vigil은 다국어 영업 통화를 전사해 SEBI/AMFI 규정 위반 발언을 하이브리드 검색(hybrid search)으로 찾아 정확한 오디오 타임스탬프와 규정 조항에 매칭합니다. 준우승은 Eyewitness·MediAudit-X, 상금은 미공개입니다.
💡심사 기준이 '데모가 아닌 프로덕션급 신뢰성'이었다는 점이 핵심입니다. 규정 문서를 근거로 인용하는 검색+에이전트 조합이 실무형 해커톤에서 강하다는 신호입니다.
원문 →#hackathon#elastic#rag#compliance#india
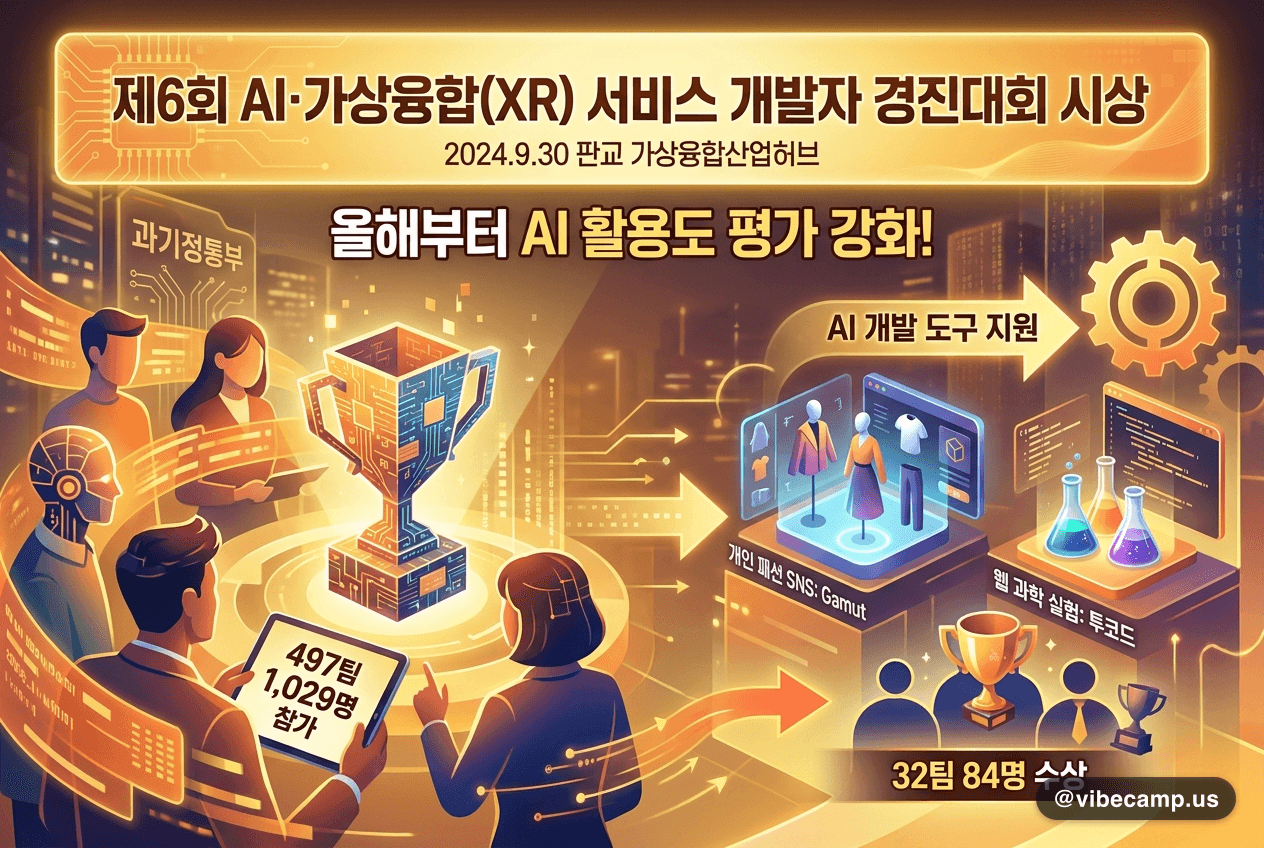
과기정통부 AI·XR 경진대회 시상, 올해부터 'AI 활용도' 평가

과기정통부 AI·XR 경진대회 시상, 올해부터 'AI 활용도' 평가

#
과기정통부가 9/30 판교 가상융합산업허브에서 제6회 'AI·가상융합(XR) 서비스 개발자 경진대회' 시상식을 열었습니다. 497팀 1,029명이 참가해 32팀 84명이 수상했습니다. 개발자 부문 대상은 AI·3D 기반 개인 패션 SNS 'Gamut'과 웹 기반 과학 실험 학습 서비스 '투코드'가 받았습니다. 올해부터 참가자에게 AI 개발 도구를 지원하고 AI 활용도를 평가에 반영했습니다. 총상금은 5월 공고 기준 7,800만원입니다.
💡정부 공모전에서 AI 도구 활용이 평가 항목이 됐습니다. 최우수상 JARVIS(MR 협업)·말을 보다(AI 글래스)처럼 AI와 XR·멀티모달 인터페이스를 엮은 작품이 눈에 띕니다.
원문 →#hackathon#korea#xr#government-contest
💰

매출·사례

GPU 서버 랙이 늘어선 데이터센터 이미지 (GMI Cloud 투자 유치 보도 대표 이미지)

GMI Cloud $668M 조달…지분 $223M, 나머지 $445M은 신용한도

#
GPU 인프라·추론 서비스를 제공하는 GMI Cloud가 9/30 보도자료로 총 $668M 조달을 발표했습니다. 이 중 시리즈B 지분 투자는 $223M(리드 ARCHIV, NVIDIA 참여)이고, 대부분인 $445M은 CTBC 주도 신용한도(credit facility)입니다. 계약 ARR(contracted ARR)은 $600M을 넘어 2025년 말 대비 9배 이상, 실가동 ARR은 4.5배 이상 늘었으며 주당 약 4조 토큰을 처리한다고 밝혔습니다.
💡계약 ARR과 실가동 ARR을 나눠 공개한 점이 지표 읽기의 좋은 교재입니다. 헤드라인 조달액도 지분 투자와 부채성 신용한도를 구분해 읽는 습관이 필요합니다.
원문 →#gpu-cloud#inference#funding#arr
ElevenLabs 공지 이미지 — '$22BN valuation, Led by T. Rowe Price · Wellington Management'

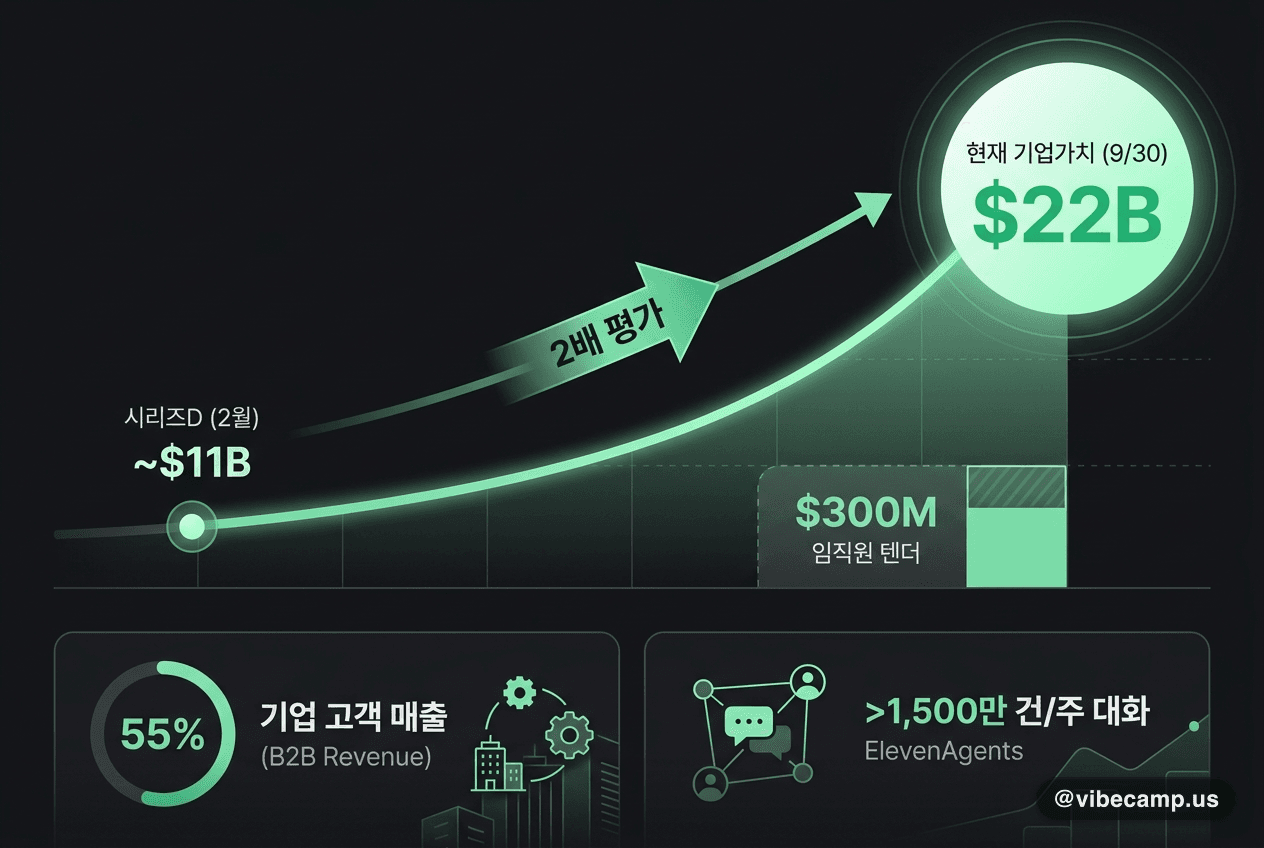
ElevenLabs 기업가치 $22B…$300M 임직원 텐더로 2배 평가

#
ElevenLabs가 9/30 공식 블로그에서 $300M 규모 임직원 텐더(employee tender)를 마쳐 기업가치 $22B를 인정받았다고 밝혔습니다. 2월 시리즈D 대비 2배입니다. 텐더는 임직원 보유 주식 매각이라 회사로 들어온 신규 자금은 아닙니다. 기업 고객이 매출의 55%를 차지하고, ElevenAgents는 주당 1,500만 건 이상 대화를 처리해 2월 대비 3배가 됐으며 ARR도 3배 이상 늘었습니다. 절대 ARR 금액은 공개되지 않았습니다.
💡모델 회사가 에이전트 플랫폼(애플리케이션 레이어)을 직접 만들 때 매출이 기업 중심으로 옮겨가는 사례입니다. 배수·비중만 공개된 지표는 절대액과 구분해 읽으세요.
원문 →#voice-ai#elevenlabs#valuation#enterprise
🎙

빌더 인터뷰

The Pragmatic Engineer 에피소드 커버 — 'Distributed databases with Peter Mattis', Cockroach Labs CTO 공식 게재 사진

AI로 코딩에 복귀한 CockroachDB CTO, 코드리뷰의 미래를 말하다

#
Cockroach Labs 공동창업자·CTO 피터 매티스(Peter Mattis)가 9/30 공개된 The Pragmatic Engineer 팟캐스트(약 102분)에서 관리 업무로 멀어졌던 코딩에 AI 에이전트로 복귀한 경험을 이야기했습니다. 그는 에이전트가 좋아지면서 검토를 점점 덜 하게 된다며, 올해나 내년쯤 어셈블리를 보지 않듯 코드를 보지 않게 될 수 있다고 전망했습니다(의역). 일주일 걸릴 실험 여러 개를 동시에 에이전트에 맡기는 방식을 연구조교 무리에 빗댔습니다.
💡그는 도메인 전문가가 가장 크게 증폭된다고 봅니다. 에이전트 산출물을 처음엔 꼼꼼히 검토하다 신뢰가 쌓이면 줄여 가는 방식은 지금 적용해 볼 만한 멘탈 모델입니다.
원문 →#interview#podcast#code-review#agentic-workflow
🦅

claw 생태계

GitHub 저장소 카드 — pydantic/pydantic-ai

Pydantic AI v2.52.0, 하네스 본체 편입·샌드박스 동일 API

#
파이썬 에이전트 SDK Pydantic AI가 9/30 v2.52.0을 냈습니다. 하네스(pydantic-ai-harness)를 본체로 편입해 0.36→0.52로 맞췄고, ctx.workspace로 Coder·Shell·FileSystem을 로컬·E2B·Fly Sprites 샌드박스에서 같은 API로 실행합니다. 터미널 에이전트 pydantic-clai2 첫 릴리스, web_fetch 보안 권고도 함께입니다. 프레임워크는 2024년부터 공개된 프로젝트입니다(⭐20,295, MIT).
💡에이전트 코드를 mypy·pyright로 미리 검증하고 같은 도구 코드를 로컬에서 샌드박스로 옮길 수 있습니다. v1에서 web_fetch를 쓴다면 1.107.7 이상으로 올리세요.
원문 →#pydantic-ai#agent-harness#python#type-safety
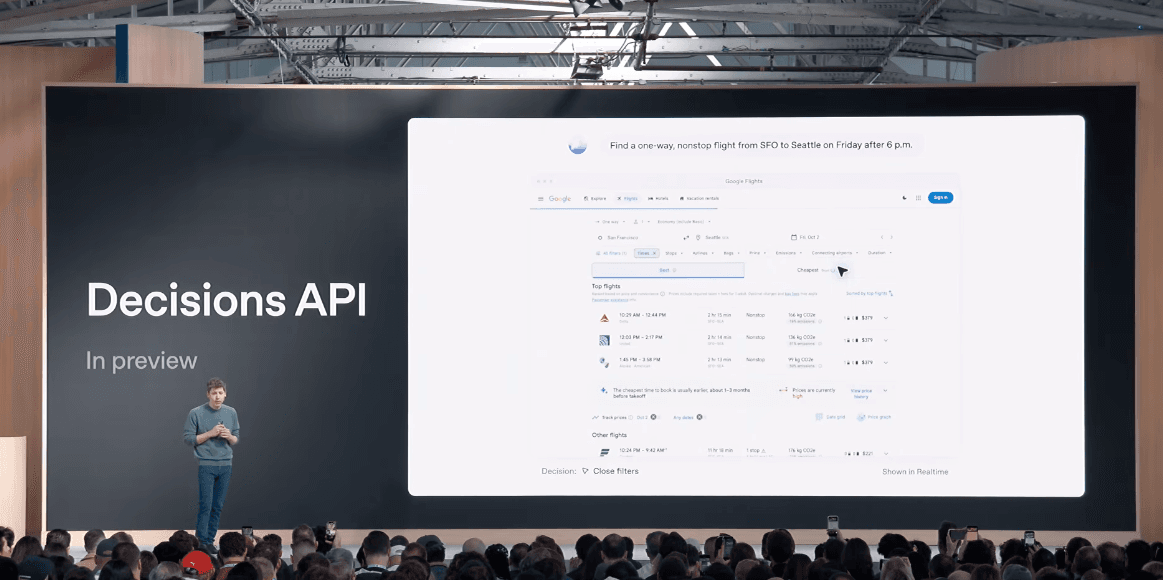
OpenAI 발표 무대 스크린에 표시된 'Decisions API — In preview' 데모 화면

OpenAI Decisions API, 닫힌 선택지 분류를 약 150ms에 응답

#
OpenAI가 9/29 DevDay에서 발표한 Decisions API가 9/30 clawfit에 새 신호로 등재됐습니다. GPT-6 Luna 특화 버전 기반으로, 질문과 닫힌 답 목록·맥락을 주면 답 1개와 신뢰도 점수만 돌려주는 제약형 분류(constrained classification) 엔드포인트입니다. The New Stack 보도에 따르면 응답은 약 150ms로 일반 Luna 호출의 1.6초보다 빠릅니다. 현재 제한 프리뷰이며 가격은 공개되지 않았습니다.
💡에이전트의 라우팅·다음 행동 고르기를 범용 LLM 호출에서 전용 판정 엔드포인트로 떼어 내는 흐름입니다. jeff·jeeves 같은 오픈소스 판정 모델과 지연·비용을 비교해 보세요.
원문 →#openai#classification#routing#agent-design
GitHub 저장소 카드 — nobodywho-ooo/nobodywho 로컬 LLM 추론 엔진

NobodyWho, 모바일·Godot에서 LLM을 오프라인 실행하는 엔진

#
NobodyWho는 GGUF 모델을 Android·iOS/macOS·Flutter·React Native·Godot·Python에서 오프라인으로 돌리는 온디바이스 추론 엔진(on-device inference)입니다. 최신 메이저 릴리스는 9/14(v4.0.0)로 신규 출시는 아니며, 9/30 clawfit에 모바일 우선 추론 엔진 첫 신호로 등재됐습니다. 함수 시그니처에서 문법을 자동 생성하는 타입 안전 툴 콜링, STT·TTS·VAD 내장, API 키 없는 로컬 실행이 특징입니다.
💡서버 비용 없이 기기 안에서 툴 호출·음성 에이전트를 만들 수 있는 선택지입니다. 다만 EUPL-1.2는 수정분 공개 의무가 있어 상용 앱 탑재 전 라이선스 검토가 필요합니다.
원문 →#on-device#local-llm#mobile#godot

이 호가 도움됐다면 공유해 주세요 — 빌더 한 명이 더 알게 됩니다.

📤 공유하기𝕏@inf💬✈B✉