본문으로 건너뛰기
← vibecamp ai builder 목록

vibecamp ai builder · #80 · 2026-09-29

vibecamp ai builder 2026-09-29 — Claude Sonnet 5.5 공개 — 가격은 그대로, 속도 30%+

2026-09-29 AI 빌더 일간 호 — 오늘 11개 카드를 정리했습니다.

11개 카드 · AI Agent 를 만드는 사람의 일간

📤 공유하기𝕏@inf💬✈B✉
🛠

빌더 신호

우주선 창 너머로 지구가 보이는 배경 위에 'Claude Sonnet 5.5' 문구가 적힌 공식 발표 이미지

Claude Sonnet 5.5 공개 — 가격은 그대로, 속도 30%+ 향상

#
Anthropic이 9/28 Claude 5.5 패밀리의 두 번째 모델 Sonnet 5.5를 공개했습니다. Sonnet 5보다 30% 이상 빠르고, 토큰 효율이 좋아져 대부분 작업에서 작업당 비용이 최대 30% 줄어든다고 밝혔습니다. 토큰 단가는 Sonnet 5와 같은 입력 $2·출력 $10(100만 토큰당)입니다. 코딩 에이전트 벤치마크 Terminal-Bench 4.0은 70.6%, 업무 품질 지표 GDPval-AA는 1844로 Opus 5.5(1846)와 거의 같습니다.
💡Opus를 기본값으로 쓰던 에이전트 파이프라인이라면 모델 ID를 claude-sonnet-5-5로 바꿔 같은 작업의 속도와 작업당 비용을 직접 비교해 볼 때입니다.
원문 →#claude#anthropic#llm-release#coding-agent
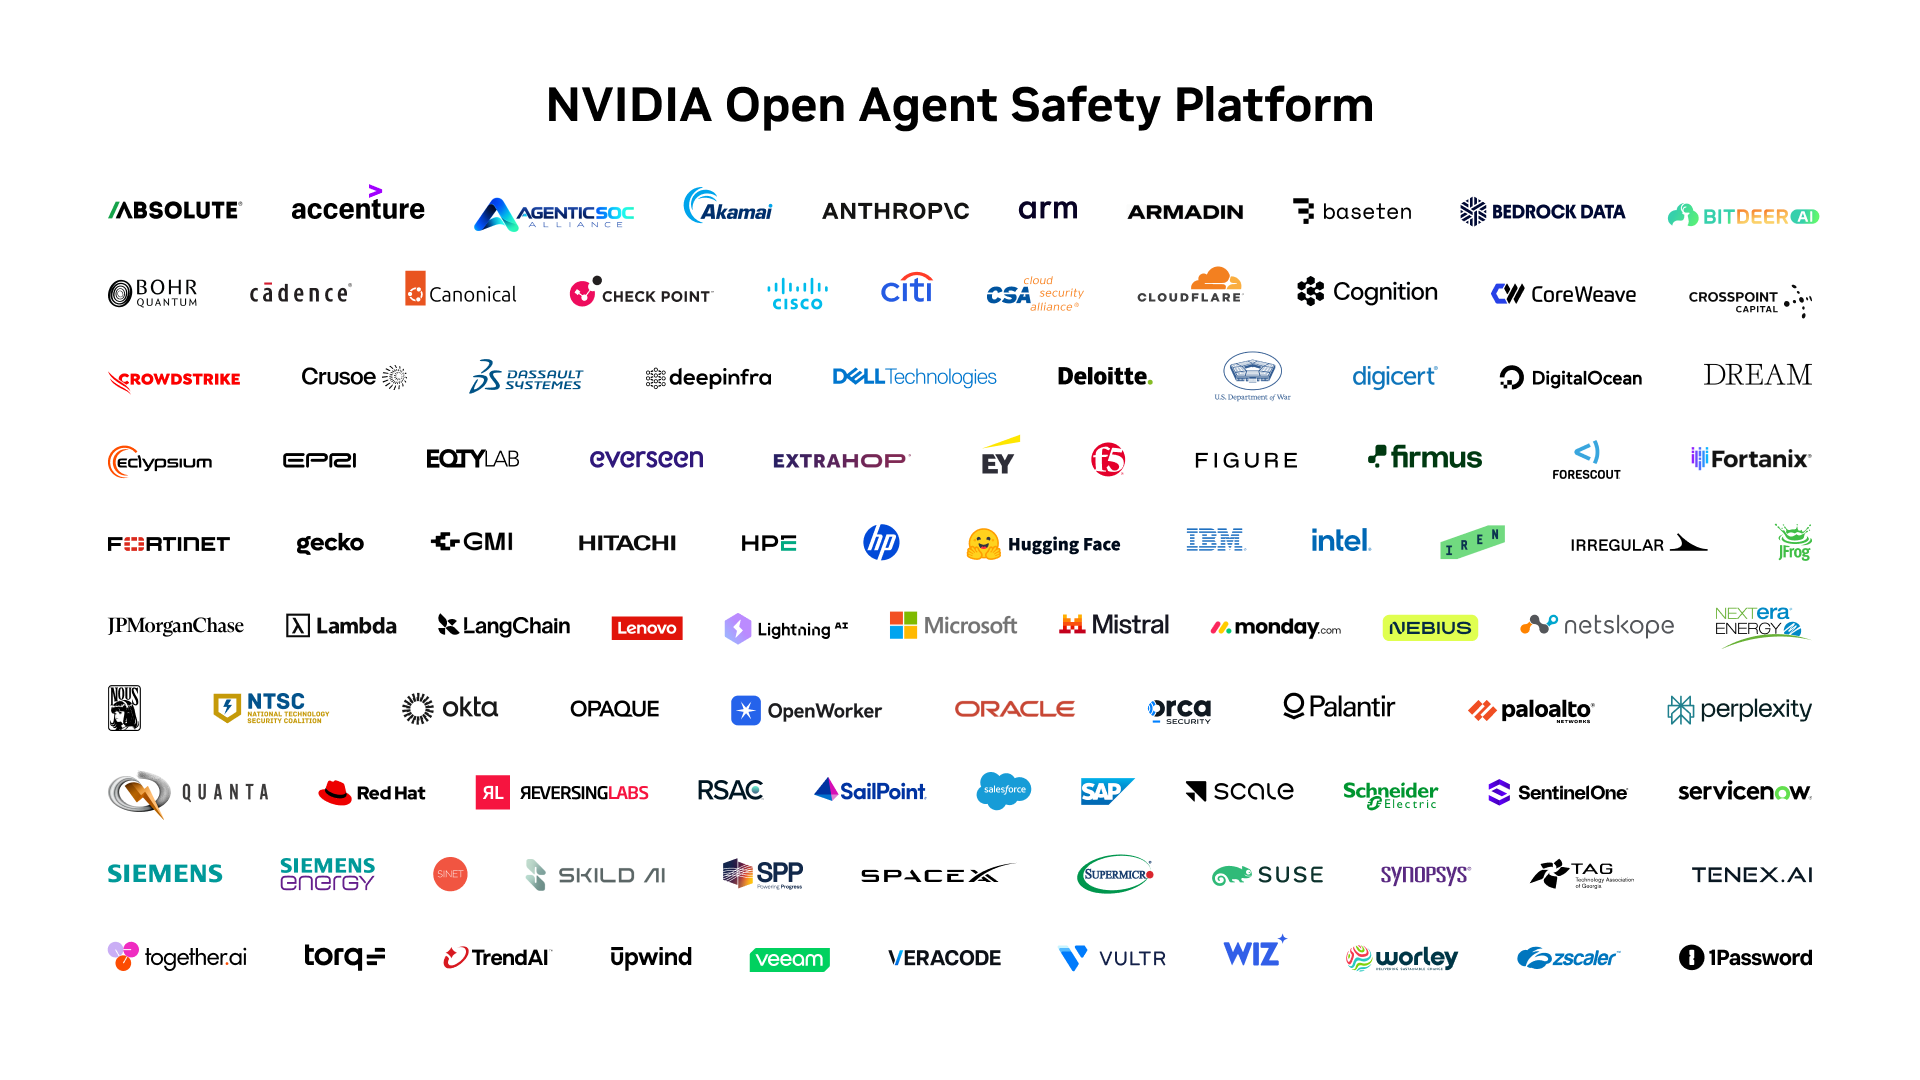
NVIDIA Open Agent Safety Platform 제목 아래 참여 파트너사 로고가 나열된 공식 보도 이미지

NVIDIA, 에이전트 격리 플랫폼 공개 — 런타임·하드웨어로 권한 통제

#
NVIDIA가 9/28 에이전트를 테스트부터 배포까지 보호하는 Open Agent Safety Platform을 발표했습니다. 오픈소스(Apache-2.0) 런타임 OpenShell이 에이전트의 정책 경계를 강제하고, BlueField-4 DPU 위에서 도는 레퍼런스 설계 Sentry가 에이전트를 감시하다 위반 시 밀리초 단위로 격리합니다. NVIDIA는 최근 보안 사고들이 이런 필요를 드러냈다고 설명했고, Anthropic·Microsoft·Cisco 등 100여 곳이 참여합니다.
💡에이전트 권한을 프롬프트나 하네스 규칙에만 맡기고 있다면, 런타임 계층에서 접근 정책을 강제하는 샌드박스(sandbox) 설계를 OpenShell로 먼저 실험해 볼 만합니다.
원문 →#nvidia#agent-security#sandbox#open-source
firelex/jeff 깃허브 저장소 카드 — Qwen3.5·Gemma 4 기반 제로샷 분류 파인튜닝 모델

집에서 학습한 0.8B 판정 모델 Jeff, 결정 한 번에 약 30ms

#
독립 개발자 firelex가 9/28 판정 모델 Jev와 같은 요청 형식을 쓰는 초소형 분류 모델 Jeff를 공개해 HN 457점을 받았습니다. 상황과 선택지를 평문으로 주면 한 번의 순전파(forward pass)로 선택지별 확률을 돌려줍니다. Qwen3.5·Gemma 4를 파인튜닝했고, 워크스테이션 GPU 1장으로 0.8B는 약 2시간에 학습합니다. 결정당 22~29ms이며 2B 모델은 종합 83.1%로 Jev(83.0%)와 비슷합니다. 다만 README는 추론형 과제에선 약하다고 밝힙니다.
💡에이전트 라우터나 가드처럼 '고르기만 하면 되는' 분기를 매번 LLM에 묻고 있다면, 로컬 소형 분류 모델로 지연과 비용을 줄일 여지가 있습니다.
원문 →#small-model#classification#fine-tuning#open-source
🏆

해커톤·대회

예레반 Firebird Build 해커톤 시상식에서 상금 보드를 든 수상 팀과 참가자들의 단체 사진

예레반 24시간 Codex 해커톤, 1위는 하드웨어 연동 AI 제어

#
아르메니아 예레반 AI9 캠퍼스에서 9/26~27 열린 Firebird Build 해커톤 결과가 9/28 발표됐습니다. 500명 이상이 지원했고 OpenAI Codex로 24시간 안에 동작하는 프로토타입을 만들었습니다. 1위 PhotonicsAI는 하드웨어와 연동한 AI 제어 환경으로 $50,000와 OpenAI 크레딧 $12,000를 받았습니다. 2위는 로보틱스용 VLA 모델 학습 인프라, 3위 EXPM은 취약점 탐지·수정·테스트를 하는 에이전트 보안 플랫폼입니다. 총상금은 $105,000입니다.
💡상위 3팀이 모두 물리 세계나 검증 루프에 붙는 도구였습니다. 코딩 에이전트로 누구나 빨리 만드는 시대에는 '무엇에 연결하느냐'가 차별점이 됩니다.
원문 →#hackathon#openai-codex#robotics#vla
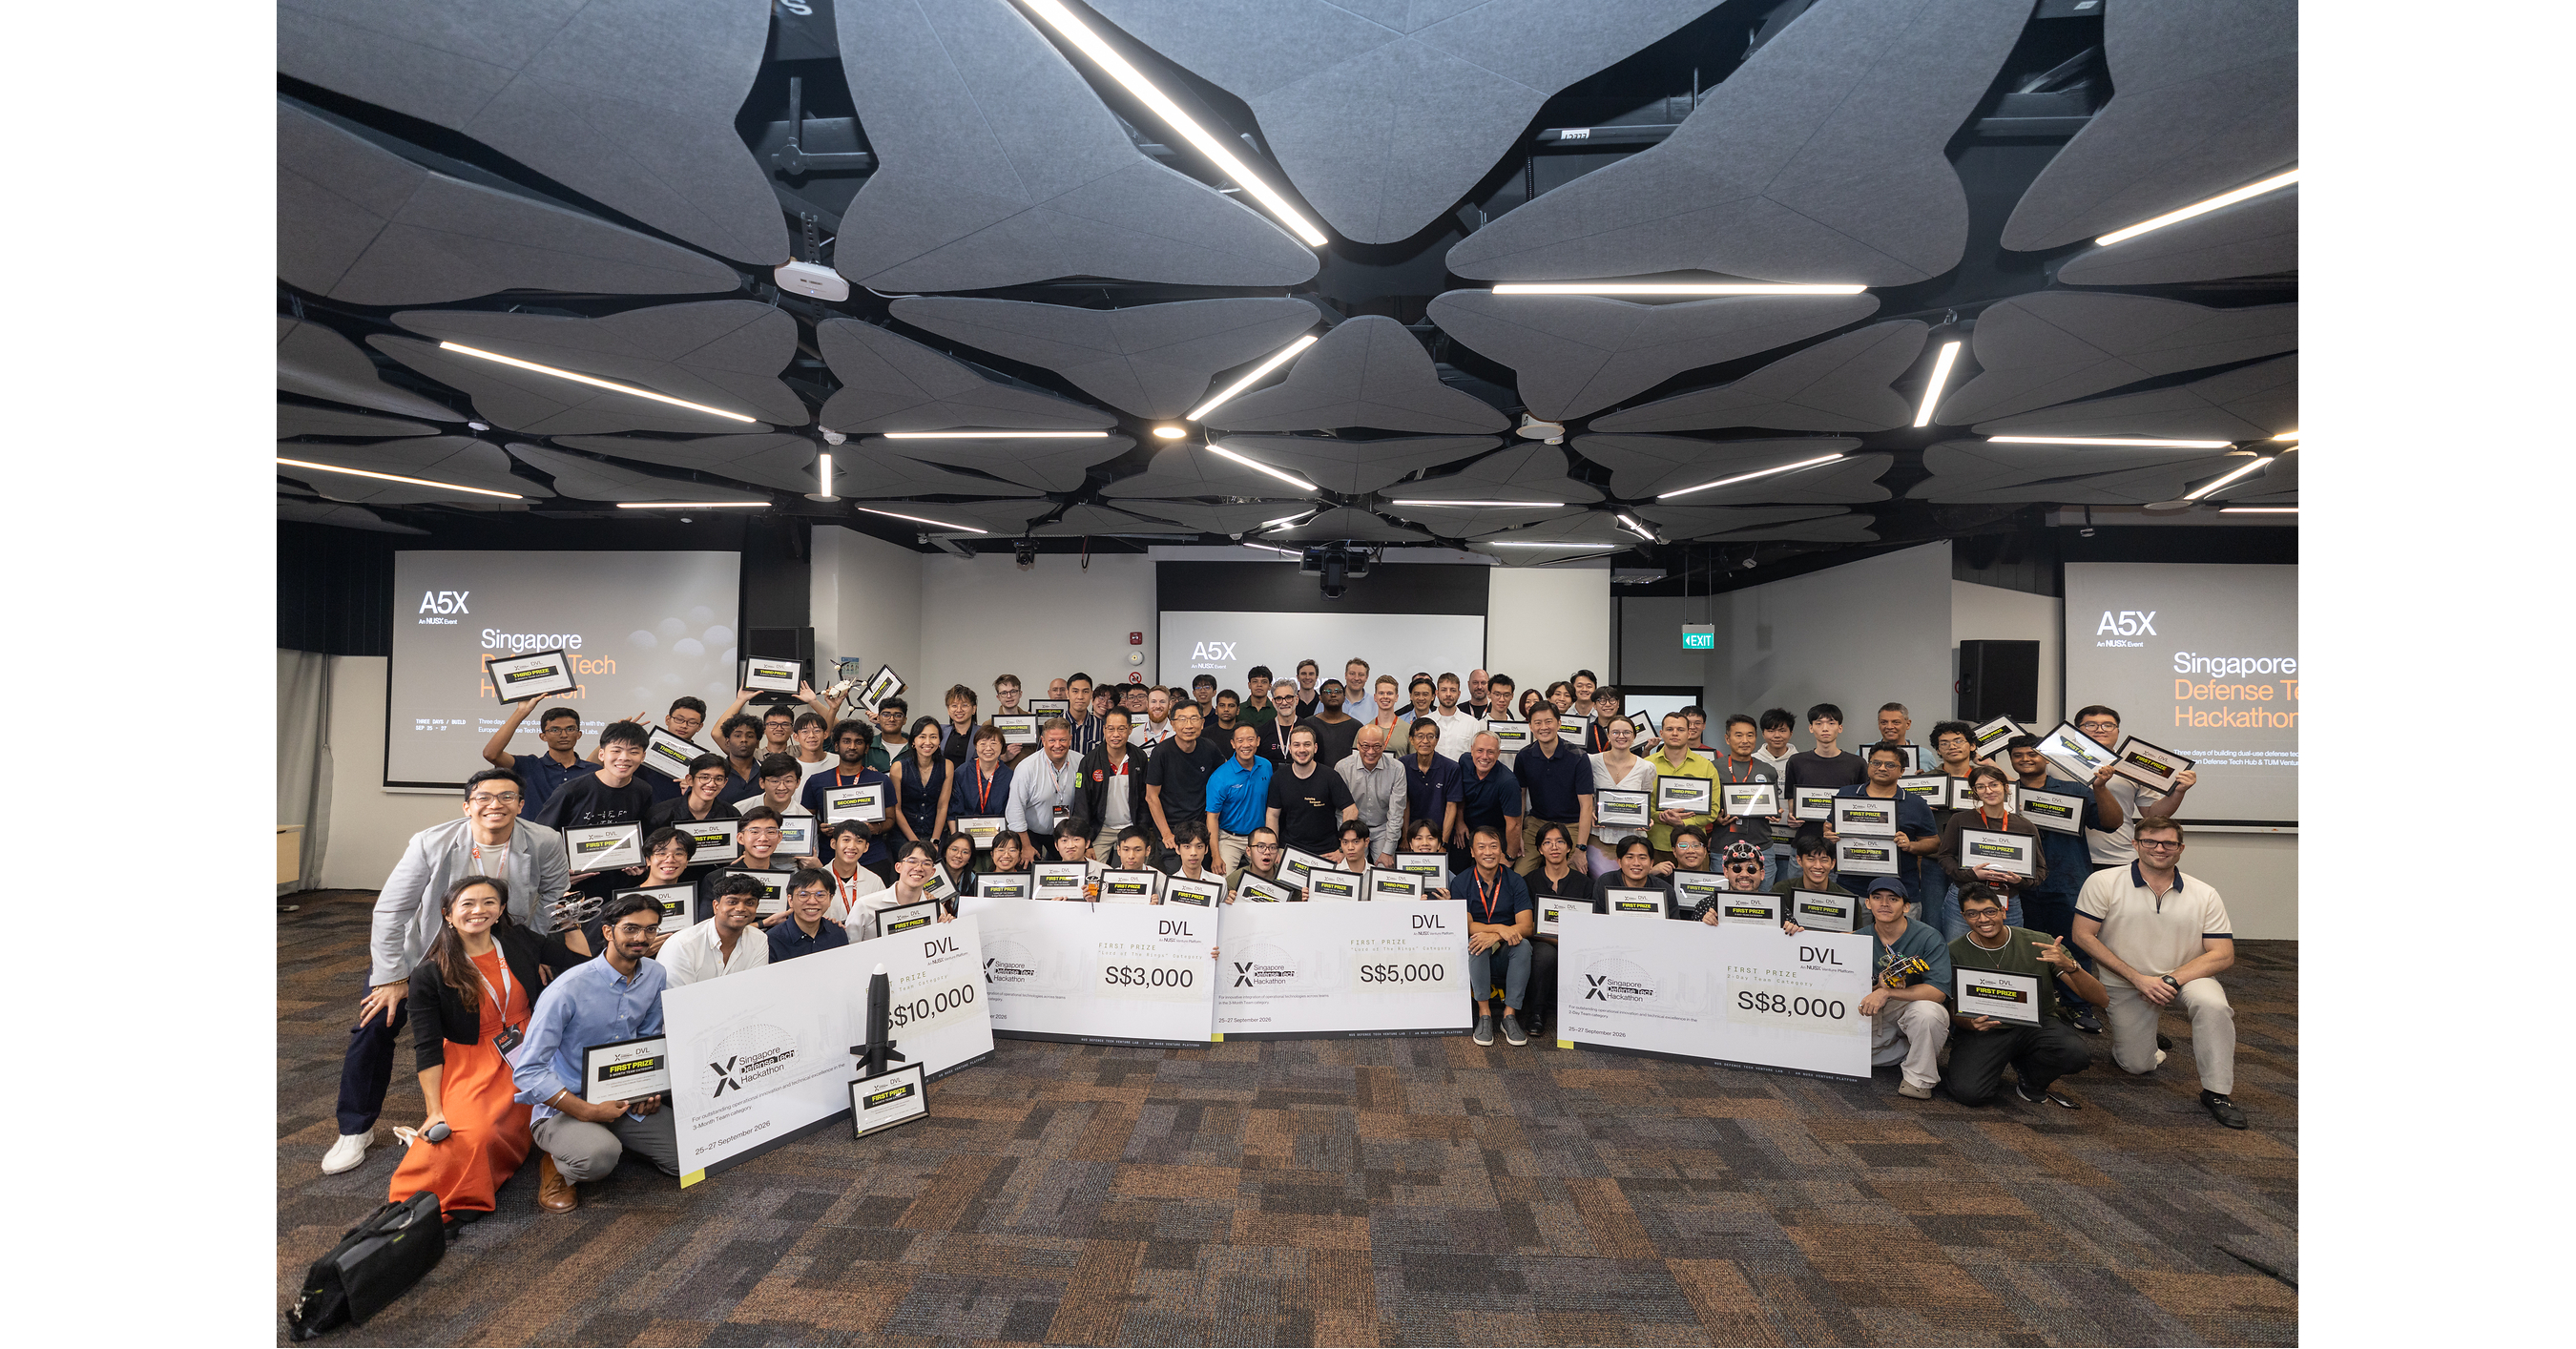
싱가포르 국방 테크 해커톤 참가자와 수상 팀이 상금 보드를 들고 모인 단체 사진

싱가포르 국방 테크 해커톤 시상 — 뇌-컴퓨터 인터페이스가 1위

#
싱가포르국립대 NUSX가 9/25 개막한 첫 싱가포르 국방 테크 해커톤이 9/28 시상을 마쳤습니다. 1,000명 이상이 지원해 약 300명이 선발됐고 60여 팀이 참가했습니다. 48시간 트랙에서는 39팀 중 NeuroMech가 손을 쓰지 않고 무인 지상차량을 조종하는 뇌-컴퓨터 인터페이스(BCI)로 1위에 올랐습니다. 여러 팀의 기술을 하나로 묶은 팀에 주는 '반지의 제왕' 통합상도 따로 있었고, 현금 상금은 5만 싱가포르달러 이상입니다.
💡개별 우승과 별도로 '다른 팀 기술과 합치기'에 상을 주는 구조는, 해커톤이나 사내 대회를 설계할 때 팀 간 협업을 끌어내는 장치로 참고할 만합니다.
원문 →#hackathon#bci#defense-tech#singapore
💰

매출·사례

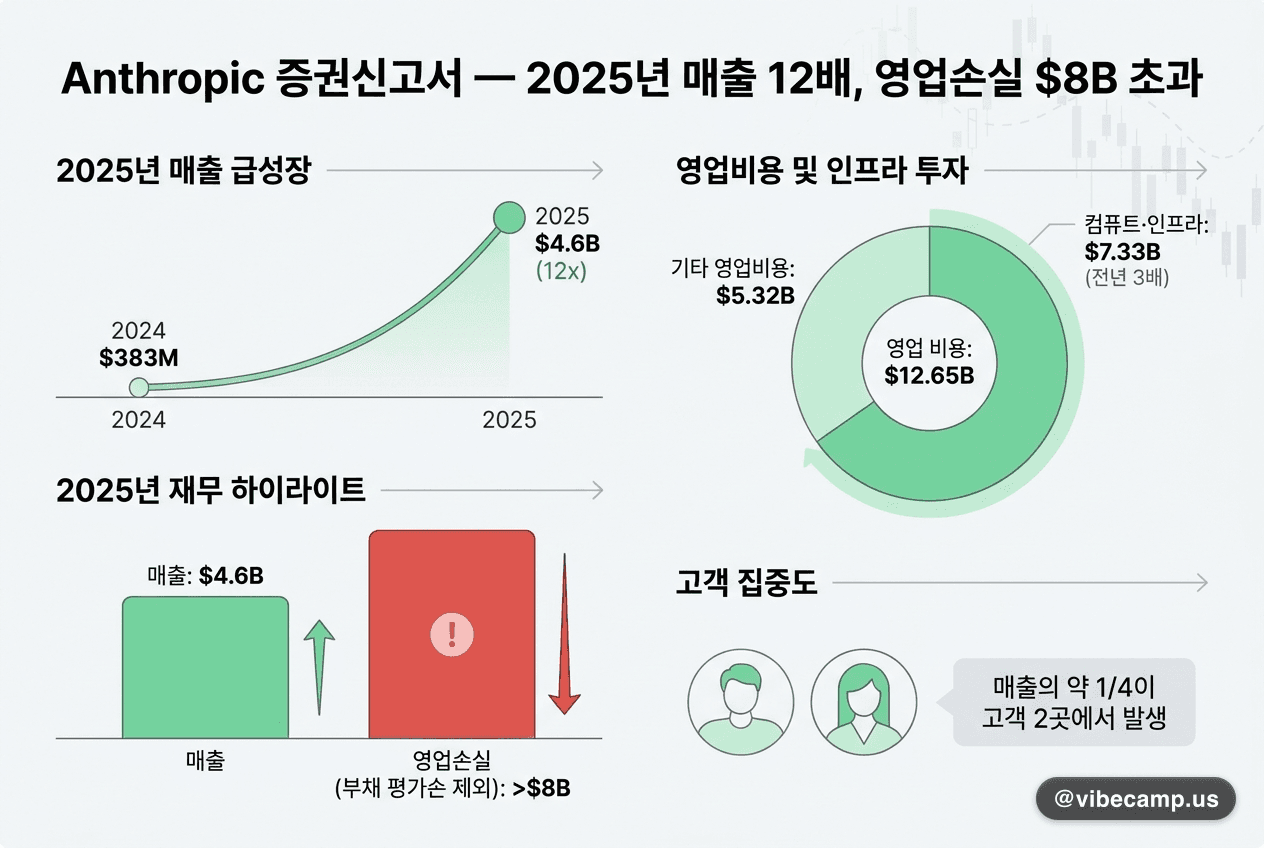
Anthropic 증권신고서 — 2025년 매출 12배, 영업손실 $8B 초과

Anthropic 증권신고서 — 2025년 매출 12배, 영업손실 $8B 초과

#
Reuters가 입수한 Anthropic의 IPO 증권신고서에 따르면, 2025년 매출은 약 $4.6B로 한 해 동안 12배 늘었습니다. 같은 해 영업손실은 부채 평가손을 빼고도 $8B를 넘었습니다. 컴퓨트·인프라에 쓴 돈은 $7.33B로 전년의 3배이며, 총 영업비용 $12.65B의 절반 이상입니다. 매출의 약 4분의 1이 고객 2곳에서 나왔다는 점도 위험 요인으로 적혔습니다. 상장 시 기업가치는 2조 달러를 넘을 수 있다고 전해집니다.
💡모델 공급사조차 비용의 절반 이상이 컴퓨트이고 고객 집중 위험을 안고 있습니다. 내 서비스의 토큰 원가율과 대형 고객 의존도를 숫자로 점검해 보세요.
원문 →#anthropic#ipo#unit-economics#compute-cost
주황색 로봇 모양 AI 에이전트 캐릭터 수십 개가 격자 위에 늘어선 3D 일러스트

개인 에이전트 Instinct, 초대제 상태로 기업가치 $10B

#
일상 잡무를 대신 처리하는 개인 에이전트 Instinct가 9/28 Sequoia·Benchmark·Coatue로부터 시리즈C $1B를 유치했다고 발표했습니다. 기업가치는 $10B로, 한 달여 전 알려진 $2.5B의 4배입니다. 사용자가 문자나 전화로 부탁하면 Instinct가 자체 폰과 컴퓨터로 여행 계획, 장보기, 잊힌 구독 해지까지 끝냅니다. 아직 초대제(early access) 단계이며 매출은 공개하지 않았습니다. 격리 샌드박스와 단기 자격증명 같은 신뢰 장치도 함께 내세웠습니다.
💡새 앱 대신 문자·전화처럼 이미 쓰는 채널에 에이전트를 붙이고, 권한 위임 신뢰를 기본값으로 설계한 점이 1인 빌더도 재현해 볼 만한 패턴입니다.
원문 →#personal-agent#funding#series-c#agent-ux
🎙

빌더 인터뷰

Latent Space 인터뷰 에피소드 썸네일 — 'MUTABLE SOFTWARE' 문구와 대담 참여자 두 사람

Claude Code 팀 "프롬프팅은 Claude라는 청중을 향한 글쓰기"

#
Latent Space 팟캐스트가 9/29 Anthropic Claude Code 팀 Thariq Shihipar 인터뷰를 공개했습니다. 그는 프롬프팅을 "Claude라는 특정 청중을 향한 대중 연설이나 글쓰기"에 빗대며, 모델이 어떻게 생각하는지 멘탈 모델을 세우는 것이 핵심 역량이라고 말합니다. Claude.md가 결국 사라질 수 있는 이유, 가장 똑똑한 모델이 많은 작업에서 가장 싼 모델이 될 수 있다는 관점, 하네스를 사용자가 고쳐 쓰는 'mutable software'도 다룹니다.
💡그는 "하네스는 매우 빨리 낡는다"고 말합니다. Claude.md와 커스텀 스캐폴딩에 과투자하기보다 모델이 발전하면 걷어낼 수 있게 가볍게 설계하세요.
원문 →#claude-code#prompting#harness#podcast
🦅

claw 생태계

Cloudflare 블로그 'Introducing cf: the agentic CLI for the entire Cloudflare API' 대표 일러스트

Cloudflare, 에이전트 네이티브 CLI cf 공개

#
Cloudflare가 9/28 새 CLI cf를 오픈 베타로 공개했습니다. 기존 Wrangler가 쌓아온 명령은 약 280개였는데, cf는 스키마 기반 생성으로 Cloudflare API 3,000개 이상의 작업 전체를 덮습니다. 기본 출력은 JSON이고 에이전트에게는 압축형으로 내보내며, cf cli search로 필요한 명령을 자연어로 찾게 했습니다. 설정도 TOML 대신 타입이 붙은 cloudflare.config.ts로 바뀝니다. Cloudflare는 "에이전트에게 cf를 주면 워커 설정·배포·모니터링부터 Access 보호, 도메인 구매, WAF까지 한 도구로 맡길 수 있다"고 설명합니다(의역). Wrangler는 18개월간 병행 유지됩니다. clawfit은 이를 L4 에이전트 네이티브 CLI 신호로 등재하고 '도구 자체 탐색 명령' 패턴에 주목했습니다.
💡💡 에이전트에게 클라우드 조작을 맡긴다면 MCP 서버를 따로 붙이기 전에 벤더 공식 CLI의 JSON 출력과 검색 명령부터 확인하세요. 단, 아직 베타입니다.
원문 →#L4#cli#cloudflare#agent-native
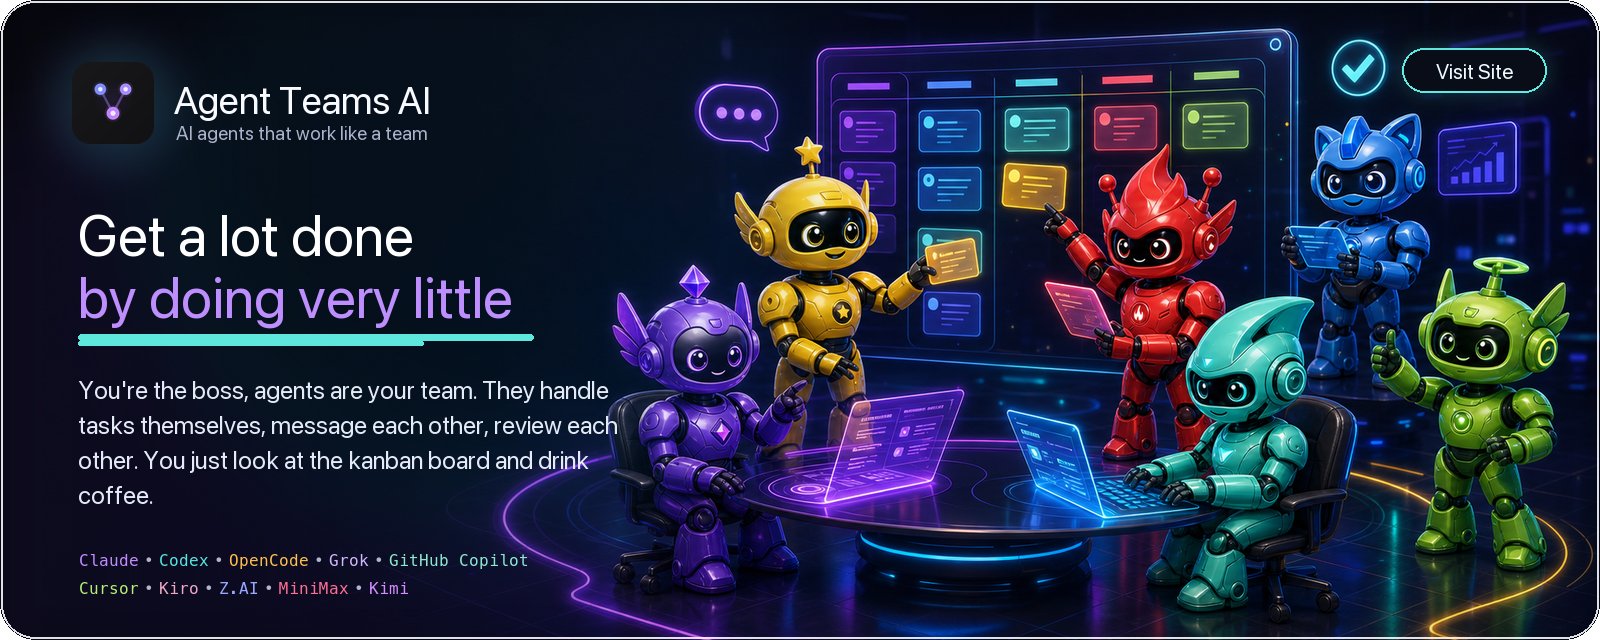
한 명의 관리자가 여러 AI 에이전트 팀에 작업을 위임하는 구조와 칸반·토큰 사용량 대시보드를 보여주는 Agent Teams AI 헤더 이미지

칸반 보드로 굴리는 에이전트 팀, Agent Teams AI

#
멀티 에이전트 오케스트레이션 도구 Agent Teams AI(⭐2,184, AGPL-3.0)가 9/28 v2.17.0과 v2.17.1을 잇달아 냈습니다. 역할이 다른 에이전트로 팀을 꾸리면 에이전트들이 병렬로 일하고, 사람은 칸반 보드에서 태스크 상태가 바뀌는 것을 지켜봅니다. README는 "앉아서 지켜보라 — 에이전트가 알아서 처리하는 동안 칸반 보드의 태스크 상태가 바뀐다"고 소개합니다. 에이전트 간 피어 리뷰(승인·반려·코멘트), 팀 간 메시지, 토큰 예산 관리를 갖췄고 Claude Code·Codex·OpenCode·Cursor 등을 연결합니다. clawfit은 9/27 OpenRig·Octop에 이은 '선언적 에이전트 팀 토폴로지' 3번째 신호로 보고 L3 조정 계층으로 분류했습니다.
💡💡 에이전트 여러 개를 병렬로 돌린다면, 리뷰 게이트를 사람이 볼지 에이전트끼리 맡길지와 팀·태스크별 토큰 예산 한도부터 먼저 정해 두세요.
원문 →#L3#multi-agent#orchestration#kanban
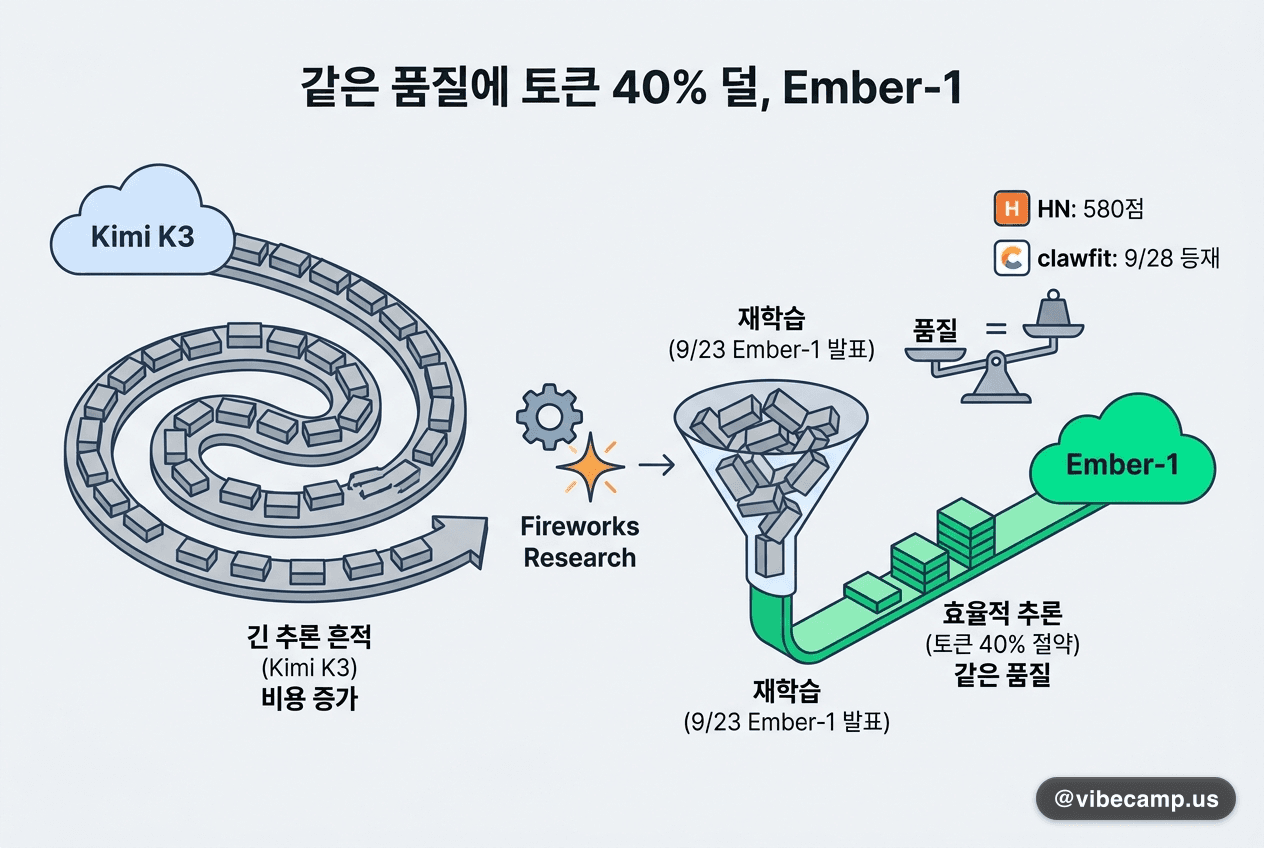
같은 품질에 토큰 40% 덜, Ember-1

같은 품질에 토큰 40% 덜, Ember-1

#
Fireworks Research가 9/23 발표한 추론 모델 Ember-1이 HN에서 580점을 받으며 9/28 clawfit에 등재됐습니다. Kimi K3를 기반으로 불필요한 추론만 줄이도록 재학습해 "Kimi K3 품질을 토큰 40% 적게" 낸다고 밝혔습니다. 배경은 K3의 긴 추론 흔적이 대규모 자동 코딩 비용을 키웠고, 추론 강도(reasoning effort)를 낮추는 방식은 품질 손실이 컸다는 점입니다. 외부 벤치마크와 고객 A/B 테스트로 검증했다지만 벤치마크별 절감폭은 5.9~51.9%로 편차가 큽니다. 2주간 서버리스로 제공하는 research release이며, 원문에 가중치 공개 언급은 없습니다. clawfit은 '작업당 추론 토큰'을 별도 평가 축으로 봐야 한다는 신호로 분류했습니다.
💡💡 에이전트 비용을 비교할 때 토큰 단가뿐 아니라 '작업당 추론 토큰 수'를 따로 재 보세요. 40%는 Fireworks 자체 측정이라 내 태스크로 확인이 필요합니다.
원문 →#L1#llm#token-efficiency#fireworks

이 호가 도움됐다면 공유해 주세요 — 빌더 한 명이 더 알게 됩니다.

📤 공유하기𝕏@inf💬✈B✉