본문으로 건너뛰기
← vibecamp ai builder 목록

vibecamp ai builder · #77 · 2026-09-19

vibecamp ai builder 2026-09-19 — 수학 비전공자가 콘웨이 난제를 Lean으로 밀어붙였습니다

2026-09-19 AI 빌더 일간 호 — 오늘 10개 카드를 정리했습니다.

10개 카드 · AI Agent 를 만드는 사람의 일간

📤 공유하기𝕏@inf💬✈B✉
🛠

빌더 신호

overreacted.io 블로그의 'How I Vibed a Proof of Conway's Conjecture' 제목이 흰 글씨로 적힌 짙은 남색 타이틀 카드

수학 비전공자가 콘웨이 난제를 Lean으로 밀어붙였습니다

#
React 코어 팀 출신 Dan Abramov가 존 콘웨이의 50년 된 refinement conjecture에 대한 Lean 4 증명을 프런티어 모델과 함께 만들었다고 공개했습니다. 스스로를 수학 초보라고 소개한 그는 여가 시간 약 한 달, 토큰 비용 약 4만 달러를 썼고 Claude·ChatGPT·Codex를 번갈아 돌렸습니다. 다만 본인이 수학자들의 독립 검증은 아직 받지 않았다고 명시했고, 통과한 것은 Palomar 레지스트리의 기계적 검사까지입니다. 빌더 입장에서 달라지는 지점은 형식 검증기(Lean)를 정답 판정기로 두면 도메인 지식 없이도 LLM 루프의 출력을 걸러낼 수 있다는 것입니다.
💡검증기를 루프 안에 넣으면 모델의 헛소리를 사람이 아니라 기계가 먼저 거릅니다. 다만 아직 독립 검증 전이라는 단서는 그대로 남아 있습니다.
원문 →#lean#formal-verification#llm-workflow#math
해질녘 하늘을 배경으로 실루엣으로 보이는 미군 병사 두 명과 상공을 나는 소형 드론

챗봇이 쓴 정보보고서, 나포 작전 직전에 멈췄습니다

#
CNN 단독 보도에 따르면 미 특수작전사령부 분석관이 챗봇을 써서 만든 정보보고서가 "중동의 중국 선박이 핵무기 프로그램 부품을 운반 중"이라고 잘못 판정했습니다. 미군은 무장 승선을 준비하고 항공기까지 띄웠다가, 작전 직전에 보고서가 AI로 생성된 것이며 적재물 판정이 틀렸다는 사실을 확인하고 중단했습니다. 한 소식통은 그 보고서가 "완전히 거짓"이었고 "하마터면 전쟁을 시작할 뻔했다"고 말했습니다. 에이전트 파이프라인을 만드는 입장에서 핵심은 모델의 정확도가 아니라 출력이 올라탄 문서 포맷입니다. 신뢰받는 양식에 담기는 순간 조직 전체가 그것을 검증된 사실로 취급하므로, 출처 추적(provenance) 표기는 편의 기능이 아니라 안전 기능입니다.
💡LLM 출력이 조직의 공식 양식에 담기면 사람이 검증 단계를 건너뜁니다. 생성물 표시와 출처 추적을 파이프라인 기본값으로 두세요.
원문 →#ai-safety#provenance#agent-pipeline#hallucination
한 문장 명세에 58줄, Bend 2를 향한 반론입니다

한 문장 명세에 58줄, Bend 2를 향한 반론입니다

#
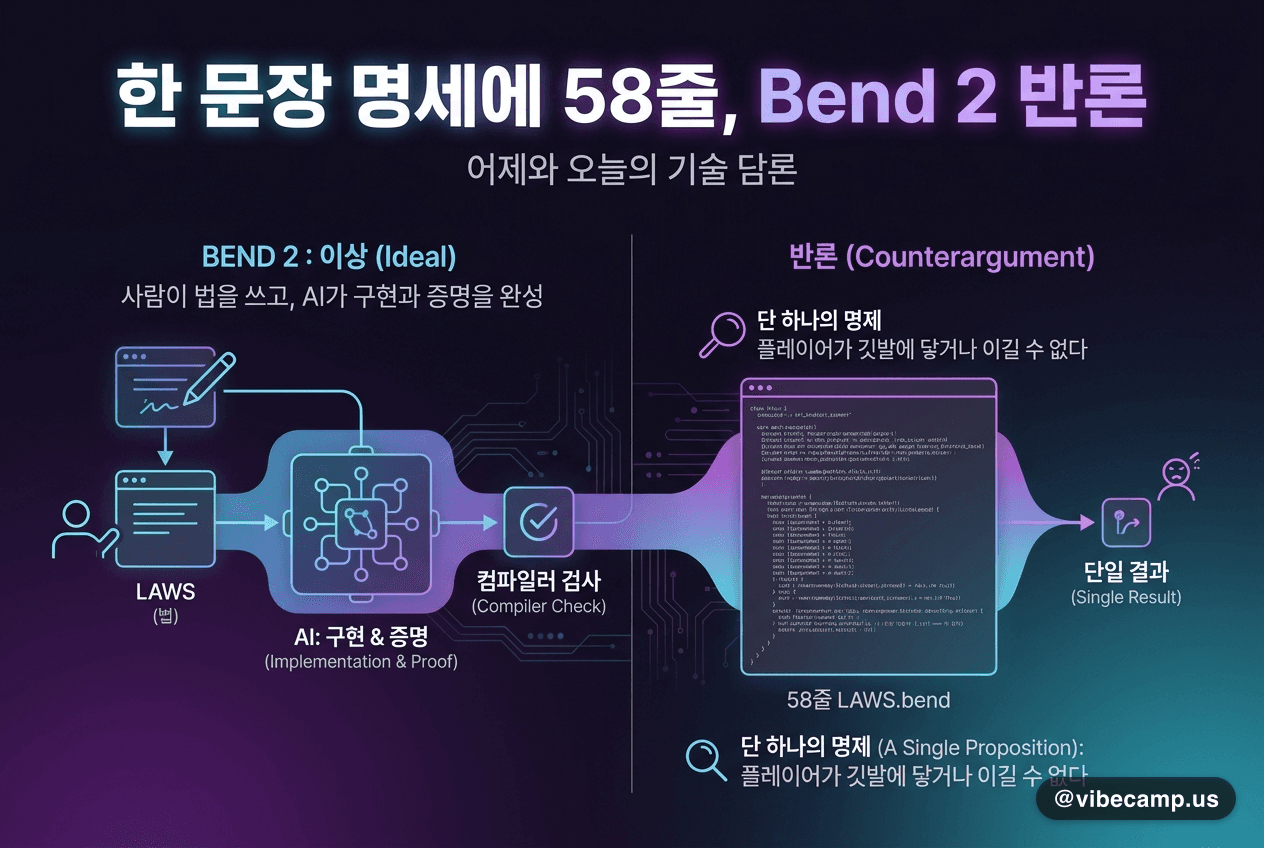
어제 소개해 드린 Bend 2는 사람이 법(laws)을 쓰고 AI가 구현과 증명을 쓰면 컴파일러가 증명의 건전성을 검사한다는 포지셔닝이었습니다. Liam Powell은 같은 데모를 뜯어보며 정반대 각도의 반론을 냈습니다. 홈페이지 데모의 LAWS.bend는 "플레이어가 깃발에 닿거나 게임을 이길 수 없다"는 단 하나의 명제를 쓰는 데 58줄이 필요하고, LLM이 Game 서브프로그램을 임의로 재정의할 수 있는 구멍도 남아 있다는 지적입니다. 검증 레이어를 도입하려는 팀이라면 명세 작성 비용과 명세가 실제로 막아주는 범위를 먼저 재 보라는 체크리스트로 읽으면 좋습니다. 증명이 붙었다는 사실 자체가 안전을 보장하지는 않습니다.
💡증명 기반 언어의 진짜 비용은 컴파일러가 아니라 사람이 쓰는 명세의 분량입니다. 도입 전에 명세 한 줄당 막아주는 범위를 계산해 보세요.
원문 →#bend#formal-verification#vibe-coding#language-design
🏆

해커톤·대회

DBS·Keppel이 문제를 낸 에이전트 해커톤, 10/16 마감

DBS·Keppel이 문제를 낸 에이전트 해커톤, 10/16 마감

#
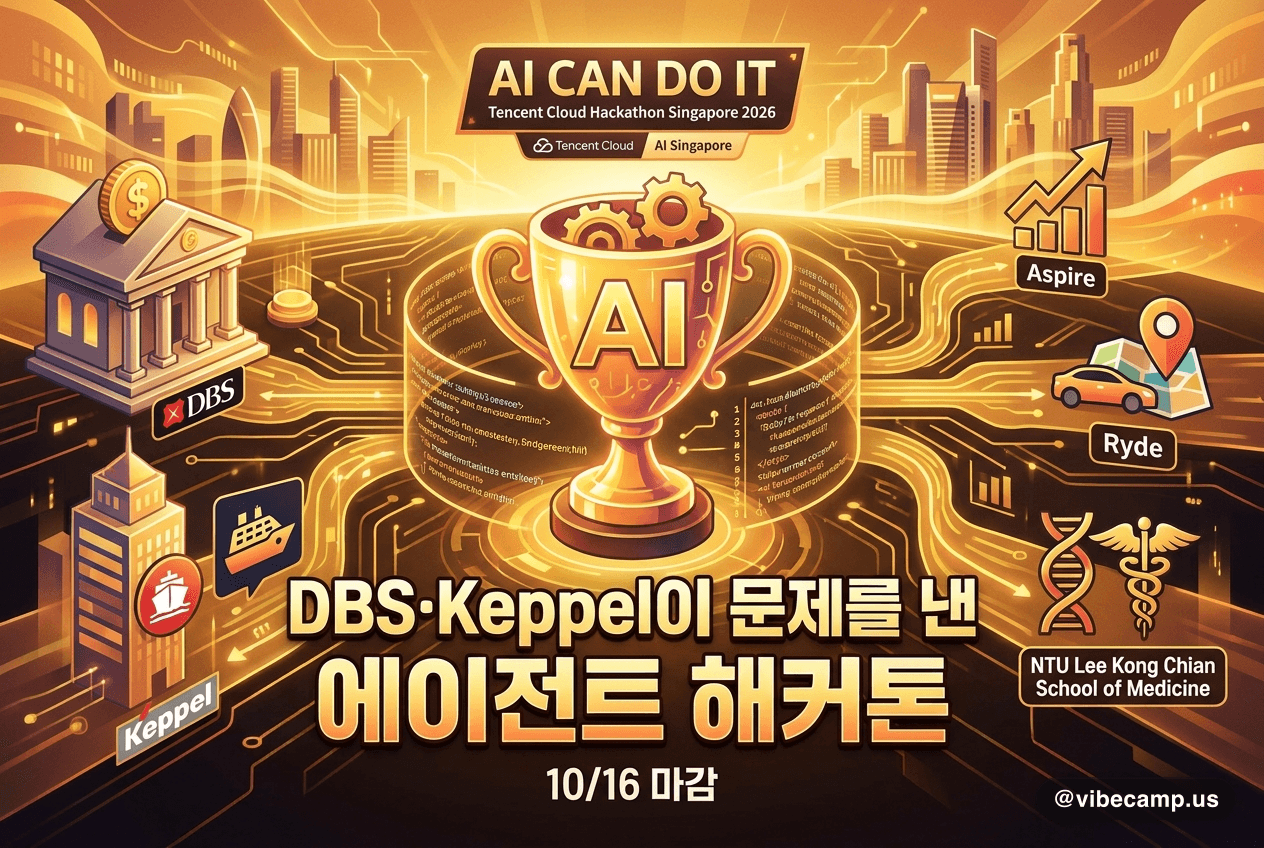
Tencent Cloud와 AI Singapore가 'AI CAN DO IT Tencent Cloud Hackathon Singapore 2026'을 열었습니다. DBS(은행), Keppel(부동산), Aspire(핀테크), Ryde(디지털 네이티브 서비스), NTU Lee Kong Chian School of Medicine(헬스케어)이 각 트랙의 문제 정의를 직접 제출했고, 참가자는 이를 에이전틱 AI로 풉니다. 대회 기간은 9/16~11/3, 제출 마감은 10/16이며 총상금은 1만 7,000싱가포르달러(1위 1만, 2위 5,000, 3위 2,000)입니다. 에이전트를 만들어 본 빌더에게 가장 모자란 게 실제 업무 맥락인데, 이 대회는 그 맥락을 기업이 대신 써 준 형태입니다.
💡현업 기업이 쓴 문제 정의는 그 자체로 시장조사 자료입니다. 참가 여부와 별개로 트랙별 문제를 읽어 두면 다음 프로젝트의 과녁이 생깁니다.
원문 →#hackathon#agentic-ai#singapore#enterprise
💰

매출·사례

메타 인수 무산 뒤, 40억 달러 몸값으로 조달 협상 중

메타 인수 무산 뒤, 40억 달러 몸값으로 조달 협상 중

#
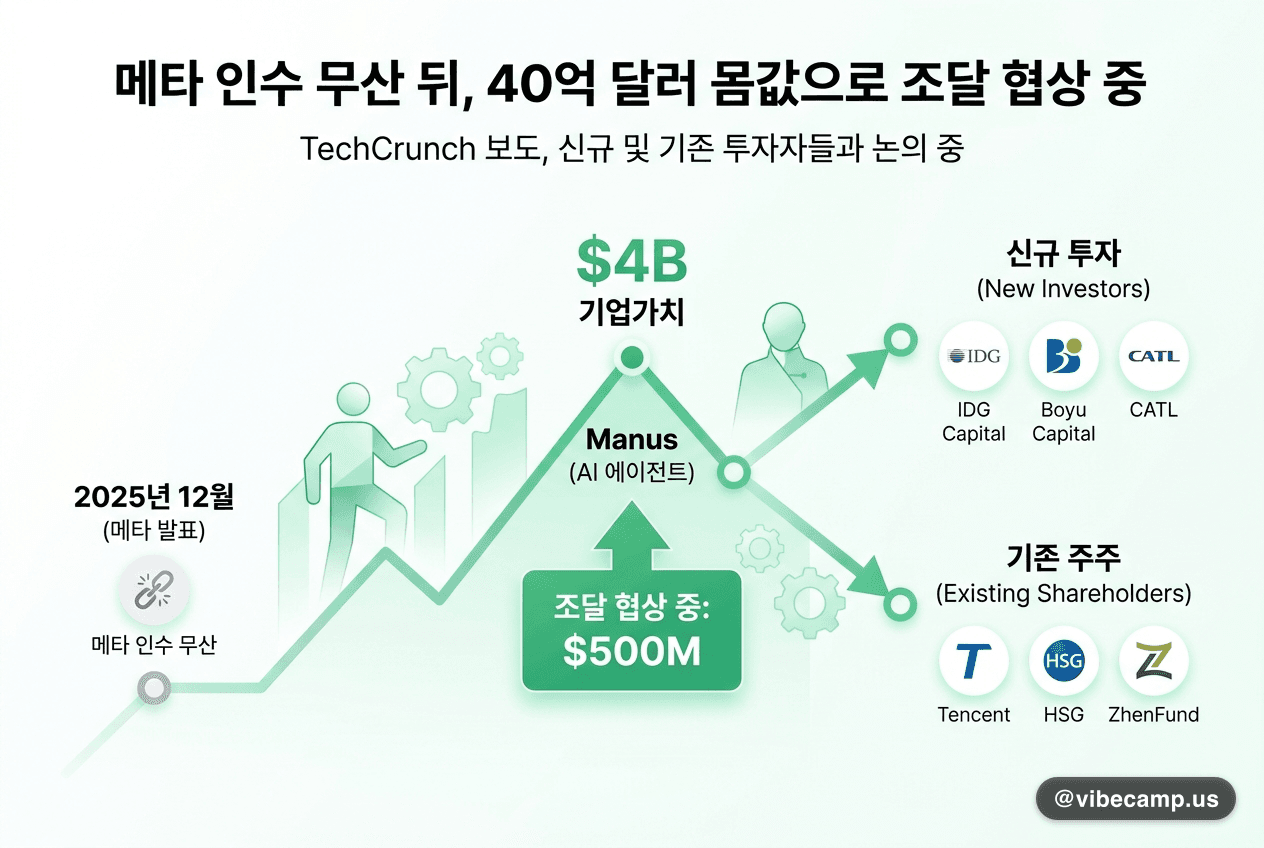
TechCrunch는 중국 AI 에이전트 스타트업 Manus가 40억 달러 기업가치로 5억 달러를 조달하는 논의를 진행 중이라고 보도했습니다. 아직 클로징이 아니라 협상 단계이며, 신규로 IDG Capital·Boyu Capital·CATL이, 기존 주주로 Tencent·HSG·ZhenFund가 거론됩니다. 2025년 12월 발표된 20억 달러 규모 메타 인수는 베이징 당국의 규제 우려로 좌초됐고, 당시 보도된 연간 반복매출은 1억 달러를 넘는 수준이었습니다. 다만 이는 2025년 12월 시점의 전언값이고 현재 수치는 공개되지 않았습니다. 이 회사는 챗봇과 바이브코딩 도구로 앱·웹사이트·발표자료·영상까지 한 계정에서 만들게 하는 번들로 OpenAI·Lovable·Replit과 경쟁합니다.
💡인수 무산이라는 최악의 외부 충격을 버틴 건 제품 번들이 만든 반복매출이었습니다. 다만 밸류도 매출도 아직 확정 수치가 아닙니다.
원문 →#manus#fundraising#ai-agent#vibe-coding
달러 지폐가 담긴 돈주머니가 민트색 배경에 반복 배열된 투자 유치 콘셉트 일러스트

라이선스를 해자로 깐 결제사, 2,500만 달러 시리즈 A

#
싱가포르 스테이블코인 결제사 dtcpay가 2,500만 달러 시리즈 A를 최종 클로징했습니다. 4월 Vertex Ventures Southeast Asia & India가 리드한 1차 트랜치에 일본 SBI그룹이 앵커 투자자로 합류했고, Genedant Capital과 기존 주주 Kwee Liong Tek도 참여했습니다. 매출과 거래액은 공개되지 않았지만 조달 구조에서 읽을 패턴은 분명합니다. 싱가포르·룩셈부르크 라이선스를 해자로 깔고 그 위에 가맹점 POS, 스테이블코인-법정화폐 전환 Visa Infinite 카드, WalletConnect 700여 지갑 연동을 하나씩 붙여 결제 접점을 넓히는 방식입니다.
💡인프라 스타트업은 눈에 보이는 첫 레퍼런스 가맹점 하나가 다음 라운드의 서사를 만듭니다. dtcpay에게는 싱가포르 백화점 Metro가 그 자리였습니다.
원문 →#stablecoin#payments#series-a#singapore
🎙

빌더 인터뷰

No Priors 팟캐스트 공식 썸네일 — Inception 공동창업자 겸 CEO 스테파노 에르몬과 'INSIDE INCEPTION' 제목

느린 건 모델이 커서가 아니라 순차 디코딩 탓일 수 있습니다

#
No Priors 178화에서 Sarah Guo가 Inception 공동창업자이자 CEO인 Stefano Ermon을 38분간 인터뷰했습니다. 스탠퍼드 부교수이자 디퓨전 모델 연구 선구자인 그는 이미지·비디오에 머물던 디퓨전 아키텍처를 텍스트·코드 같은 이산 생성으로 옮긴 과정과 Inception의 Mercury 모델을 설명합니다. 에피소드는 자기회귀 LLM의 구조적 한계, 병렬 토큰 생성이 표준 GPU에서 주는 추론 스케일링·활용률 이점, 대규모 서빙 스택, 음성 에이전트 실사용 사례를 차례로 다룹니다. 빌더가 가져갈 멘탈 모델은 생성 지연시간이 모델 크기가 아니라 순차 디코딩이라는 구조 선택의 결과일 수 있다는 것입니다.
💡다음 경쟁 축을 규모가 아니라 효율로 놓으면 선택지가 달라집니다. 지연시간 병목부터 아키텍처 문제로 의심해 보세요.
원문 →#diffusion#inference#no-priors#architecture
🦅

claw 생태계

하루 만에 1,302→5,215 스타, 등재 게이트를 넘었습니다

하루 만에 1,302→5,215 스타, 등재 게이트를 넘었습니다

#
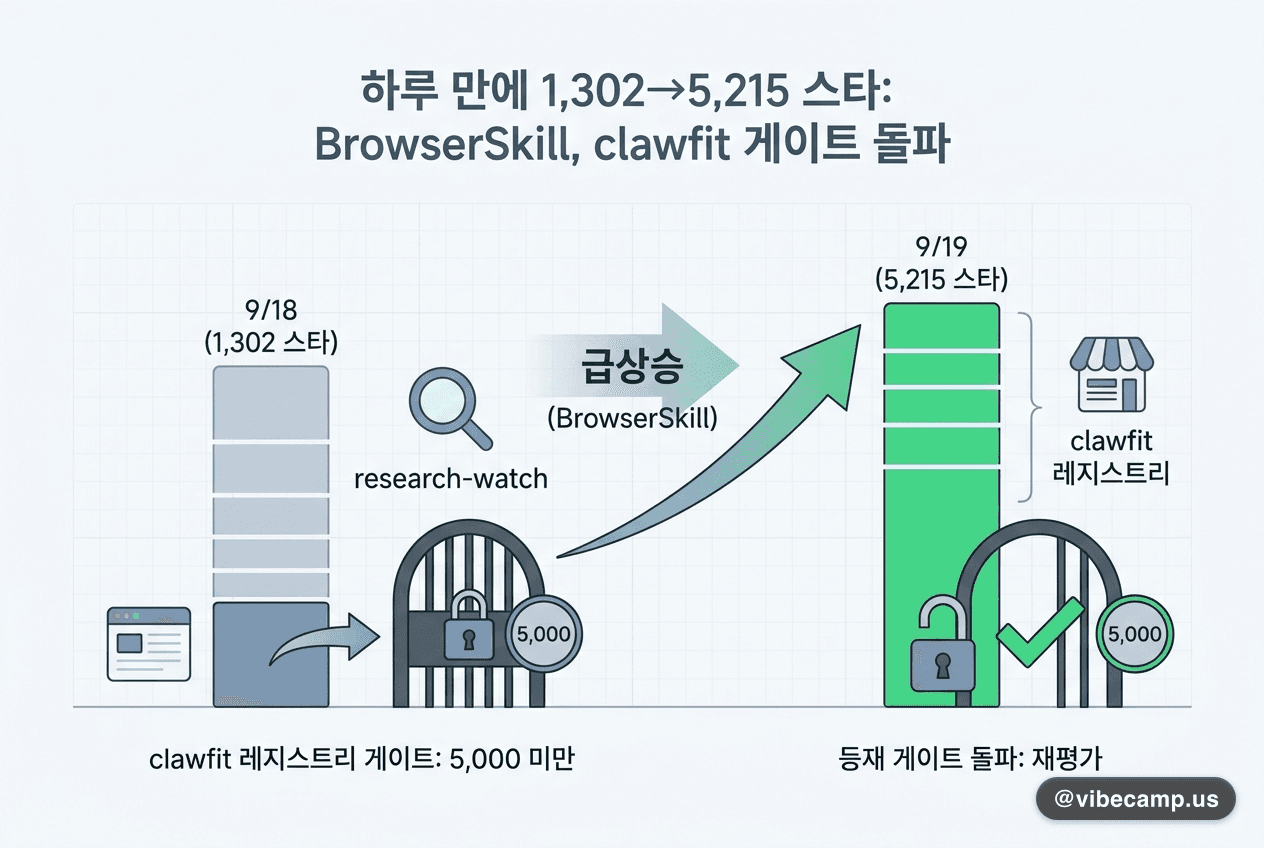
clawfit은 별점 5,000 미만 프로젝트를 레지스트리에 넣지 않고 research-watch에서만 관찰하는 정량 게이트를 운영합니다. 9/18 일간 스캔 시점 Tencent의 BrowserSkill은 1,302 스타로 그 문턱 아래였고, clawfit은 5,000에 도달하면 재평가하겠다고 기록했습니다. 그런데 9/19 06시 KST에 GitHub API를 직접 조회한 결과 5,215 스타로, 하루 만에 재평가 조건을 넘겼습니다. 저장소 자체는 2026-06-22에 공개됐고 9/18 트렌딩 진입으로 별점이 급등한 경우입니다. 빌더 입장에서 읽을 점은 레지스트리 미등재가 곧 품질 미달이 아니라는 것이며, 정량 게이트는 화제가 도는 속도보다 언제나 한 박자 늦게 반응합니다.
💡레지스트리에 없다는 건 아직 기준을 측정할 시점이 아니었다는 뜻일 뿐입니다. 게이트 통과 시점과 실제 유용성의 시점은 다릅니다.
원문 →#clawfit#registry#browser-agent#github-trending
3신호 규칙을 서브타입 단위로, 축 승격을 늦춥니다

3신호 규칙을 서브타입 단위로, 축 승격을 늦춥니다

#
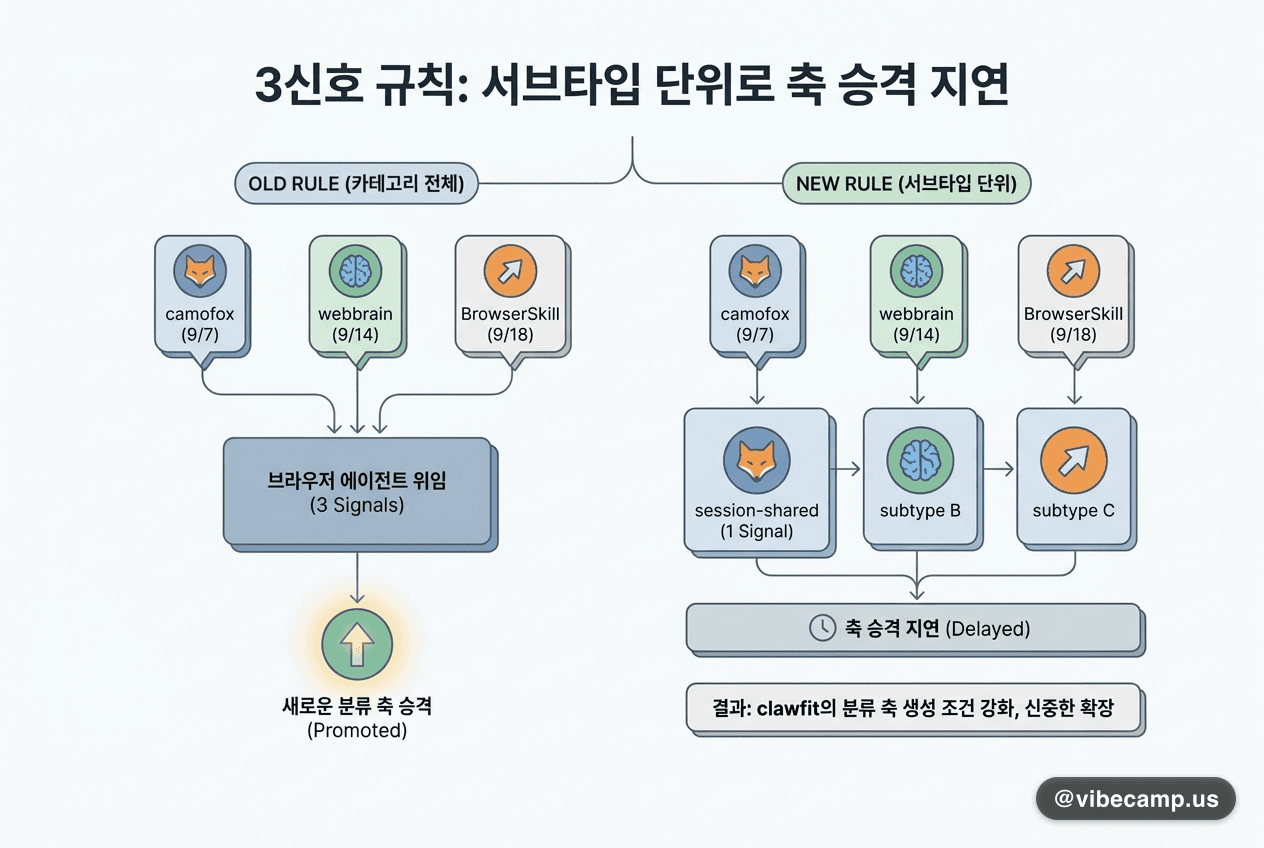
clawfit이 분류 축을 새로 만들 때 요구하는 3신호 규칙을 카테고리 전체가 아니라 서브타입 단위로 적용한다고 명문화했습니다. 브라우저 에이전트 위임 패턴에서 camofox(9/7), webbrain(9/14), BrowserSkill(9/18)로 신호는 누적 3건이 됐지만, 서브타입이 각각 달라 session-shared는 여전히 1건입니다. 그 결과 browser_sharing_model과 portability_model 두 축은 후보 상태로 보류됐습니다. 헤드리스 실행, MCP 위임, 세션 공존은 자격 증명을 다루는 방식이 서로 다르기 때문에 한 축으로 묶으면 추천 품질이 떨어진다는 판단입니다. 분류 체계를 직접 설계하는 빌더라면 신호 개수를 어느 단위로 세느냐가 스키마 진화 속도를 결정한다는 사례로 볼 만합니다.
💡같은 범주로 보이는 신호도 구현 방식이 다르면 다른 축입니다. 집계 단위를 넓게 잡을수록 스키마는 빨리, 그리고 부정확하게 자랍니다.
원문 →#clawfit#taxonomy#schema-design#browser-agent
이틀째 추천 순위 무변동, 레지스트리는 107개 그대로

이틀째 추천 순위 무변동, 레지스트리는 107개 그대로

#
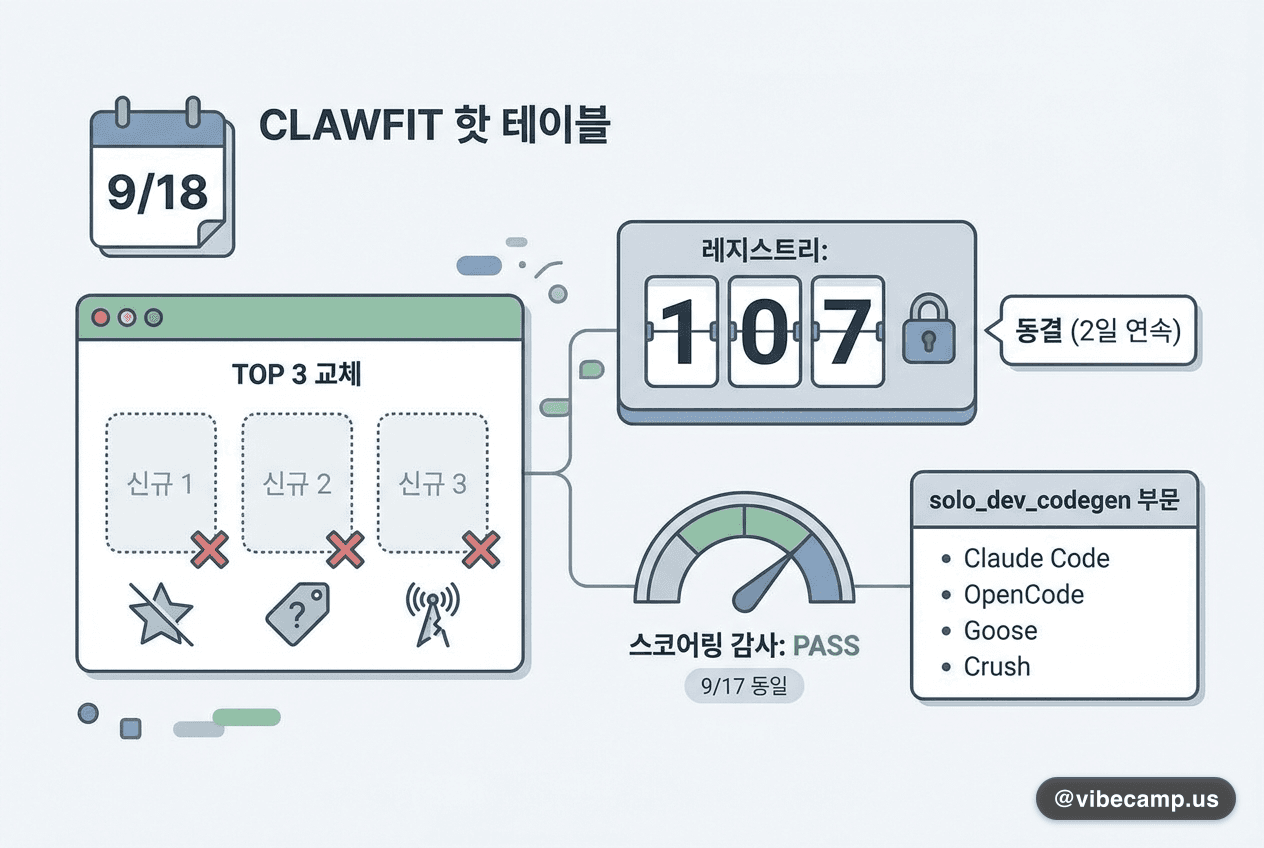
clawfit의 9/18 핫 테이블에서 상위 3건이 교체됐지만, 레지스트리 총량은 107개로 동결됐습니다. 신규 3건이 각각 별점 미달, 가격 비공개, 신호 부족으로 등재 기준을 통과하지 못했기 때문입니다. 스코어링 감사 결과도 PASS이되 9/17과 동일했고, solo_dev_codegen 부문은 Claude Code·OpenCode·Goose·Crush·Cline이 94%로 5자 동률인 상태가 그대로입니다. 화제 목록은 매일 바뀌지만 실제 도구 추천 순위는 이틀째 움직이지 않았다는 뜻입니다. 빌더 입장에서는 트렌딩에 올라온 이름과 지금 쓰기 시작해도 되는 도구를 분리해서 보는 편이 안전합니다.
💡화제성과 채택 가능성은 다른 지표입니다. 추천 순위가 며칠째 그대로라면 도구를 바꿀 이유도 아직 없다는 신호입니다.
원문 →#clawfit#registry#tooling#benchmark

이 호가 도움됐다면 공유해 주세요 — 빌더 한 명이 더 알게 됩니다.

📤 공유하기𝕏@inf💬✈B✉