본문으로 건너뛰기
← vibecamp ai builder 목록

vibecamp ai builder · #75 · 2026-09-17

vibecamp ai builder 2026-09-17 — Cowork와 채팅이 하나의 Claude로

2026-09-17 AI 빌더 일간 호 — 오늘 10개 카드를 정리했습니다.

10개 카드 · AI Agent 를 만드는 사람의 일간

📤 공유하기𝕏@inf💬✈B✉
🛠

빌더 신호

주황색 배경 위에 이젤에 놓인 캔버스와 손그림 선이 그려진 Anthropic 공식 일러스트 — Claude Cowork와 채팅 통합 발표 대표 이미지

Cowork와 채팅이 하나의 Claude로

#
Anthropic 이 9월 16일 Claude Cowork 와 chat 을 하나의 Claude 로 합친다고 발표했다. 같이 Claude Docs·Claude Slides 를 새로 내놓고, 비주얼 작업용이던 Claude Design 은 일반 대화 안으로 흡수했다. 공식 블로그가 밝힌 이유는 이렇다. "큰 작업을 위한 별도 공간으로 Cowork 를, 비주얼 작업을 위해 Design 을 만들었다. 사람들은 둘 다 썼지만, 답답한 건 이 일이 어디에 속하는지 매번 정해야 하는 것이라고 말했다. 그래서 고르게 하는 걸 그만뒀다." 이제 Claude 가 이미 붙어 있는 컨텍스트·스킬·커넥터를 보고 작업 성격을 스스로 판단한다. 롤아웃은 Pro·Max 가 먼저, Team·Free 는 순차, Enterprise 는 최소 30일 사전 고지다. Hacker News 에서는 171점·181댓글로 논의가 이어지고 있다.
💡💡 내 제품의 에이전트 모드를 별도 탭으로 뺄지 대화에 녹일지 다시 볼 시점입니다. 사용자에게 '어디서 시작할지'를 고르게 하는 UI 자체가 이탈 지점일 수 있습니다.
원문 →Hacker News 토론 →#claude#agent#product#ux
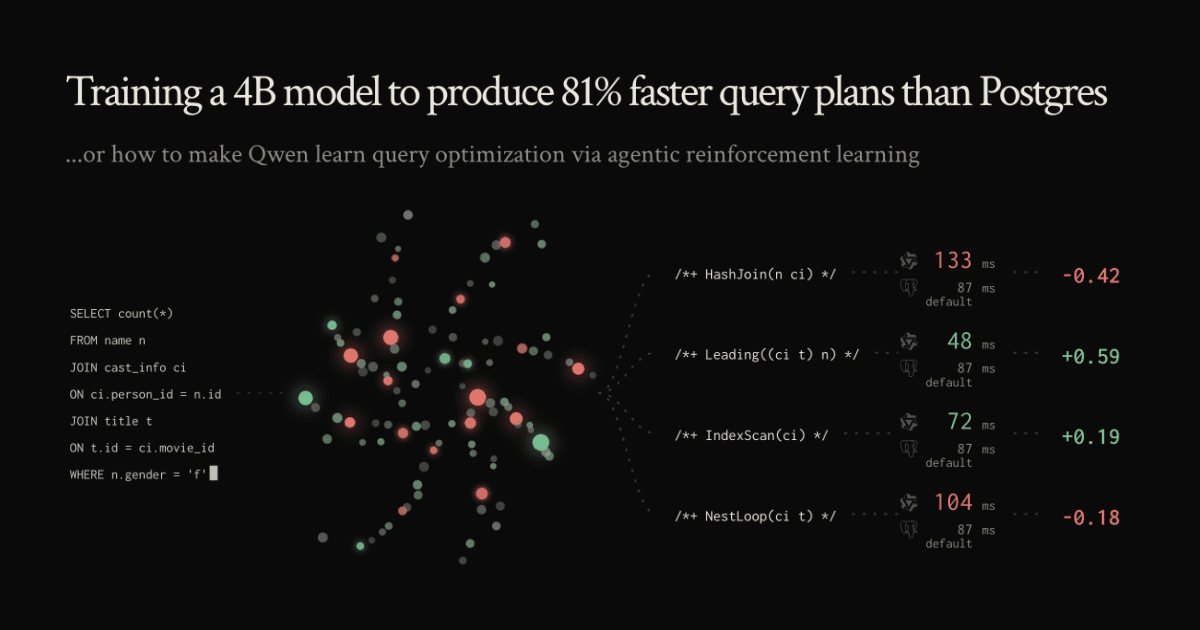
어두운 배경에 SQL 조인 쿼리와 HashJoin·IndexScan 등 쿼리 플랜 후보별 실행시간(133ms·48ms·72ms·104ms)과 보상 점수가 나란히 표시된 도표 — 4B 모델이 학습한 쿼리 최적화 결과

4B 모델이 Postgres 플래너를 이겼습니다

#
개인 연구자 Rohan Bansal 이 9월 16일 4B 오픈웨이트 모델을 SFT + 에이전틱 RL(커스텀 GRPO 변형) 로 후학습해 Postgres 기본 옵티마이저보다 빠른 조인 플랜을 만들게 한 과정을 공개했다. 저자 자체 벤치마크 기준, Join Order Benchmark 의 조인 중심 쿼리 113개에서 지연이 44.7% 감소했다(기하평균 1.81배). 학습 전 이 모델은 113개 중 99개에 대해 유효한 플랜조차 내지 못했다. 출발점은 단순한 관찰이었다. "쿼리 옵티마이저는 어렵다. 그만큼 어렵지 않은 건 옵티마이저가 고른 플랜이 좋은지 검증하는 일이다." 실행 시간이라는 단일 축이 곧 보상이 되니, 작은 모델도 강화학습으로 밀어붙일 수 있었다는 것이다. 셋업은 2x H100 한 노드와 Postgres 컨테이너 4개. HN 178점.
💡💡 내 도메인에 '기계가 자동으로 채점해 주는 단일 지표'가 있는지 먼저 찾아보세요. 있다면 프런티어 모델 프롬프트 대신 소형 모델 강화학습이 현실적인 선택지가 됩니다.
원문 →Hacker News 토론 →#rl#small-model#postgres#open-weights
분홍에서 파랑으로 번지는 파스텔 그라데이션 위에 'Reimagining advertising with AI' 문구가 놓인 OpenAI 공식 발표 이미지

광고를 누르면 기업 에이전트와 대화가 시작됩니다

#
OpenAI 가 9월 16일 ChatGPT 광고를 클릭하면 그 기업이 후원하는 에이전트와 대화가 이어지는 Sponsored Agents 를 미국 일부 광고주 대상으로 테스트하기 시작했다. 공식 발표는 경계를 분명히 긋는다. "후원 에이전트와의 대화는 ChatGPT 의 독립적인 답변과 구별되며, 사용자가 시작한 원래 대화와도 분리된다." 같은 날 광고주 쪽 도구도 함께 나왔다. ChatGPT Work 안에서 프롬프트로 캠페인을 만들고 분석하는 Ads Manager 플러그인, AI 카피·이미지 제안, 자동 번역과 문구 적응이다. 첫 CRM 파트너는 HubSpot, 첫 커머스 파트너는 Shopify 로 두 앱은 당일부터, Shopify 앱 해외 확대는 9/23 예정이다. HN 146점·159댓글.
💡💡 '기업용 후원 에이전트 제작·운영'이라는 수주 항목이 새로 생깁니다. 지금 만드는 챗봇에 후원·출처 표시를 대화와 분리하는 설계를 미리 넣어두면 그대로 납품 요건이 됩니다.
🏆

해커톤·대회

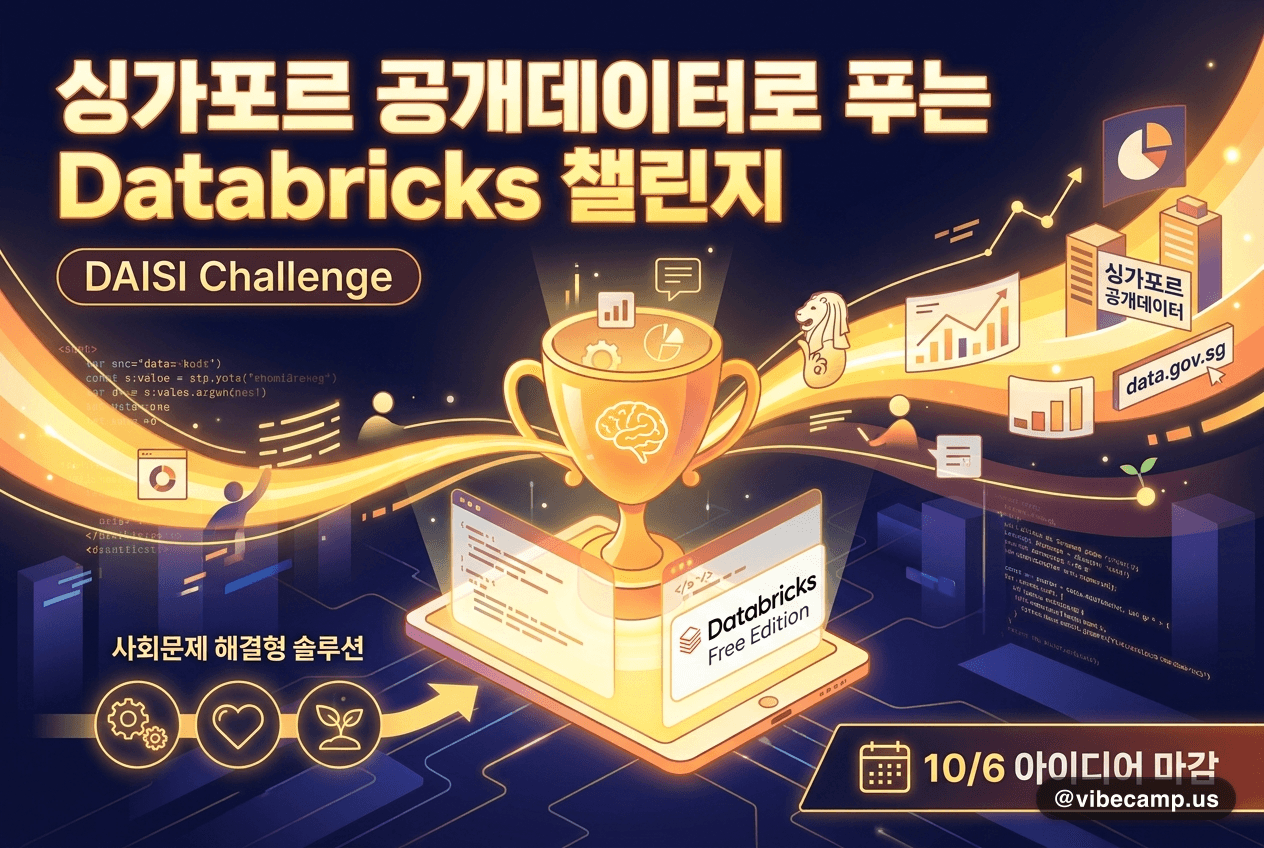
싱가포르 공개데이터로 푸는 Databricks 챌린지

싱가포르 공개데이터로 푸는 Databricks 챌린지

#
Databricks 가 9월 16일 DAISI(Databricks AI Social Impact) Challenge 접수를 열었다. data.gov.sg 같은 싱가포르 국가 공개데이터를 Databricks Free Edition 위에서 분석·모델링해 사회문제 해결형 데이터·AI 솔루션을 만드는 대회다. 아이디어 제출 마감은 10/6 23:59 SGT, 최종 제출과 데모데이는 10/27. 상금은 크레딧·트레이닝·자격증으로 최대 $24,500 규모다. 참가 자격이 싱가포르 고등교육기관(IHL) 재학생 전용이라 국내에서 바로 신청하긴 어렵지만, 심사 기준은 눈여겨볼 만하다. 모델 성능이 아니라 문제 적합성과 사회적 임팩트, 솔루션 품질·독창성, 데이터·기술적 실현 가능성, 제출물의 명료성 네 축이다. 참가 팀에는 Databricks 엔지니어 멘토링이 붙는다.
💡💡 참가는 못 해도 이 구조는 그대로 복제할 수 있습니다. 공개 데이터 + 무료 티어 인프라로 문제 정의부터 데모까지 3주 안에 끝내는 포트폴리오 한 편, 이번 달 과제로 삼아볼 만합니다.
원문 →#hackathon#databricks#open-data#student
💰

매출·사례

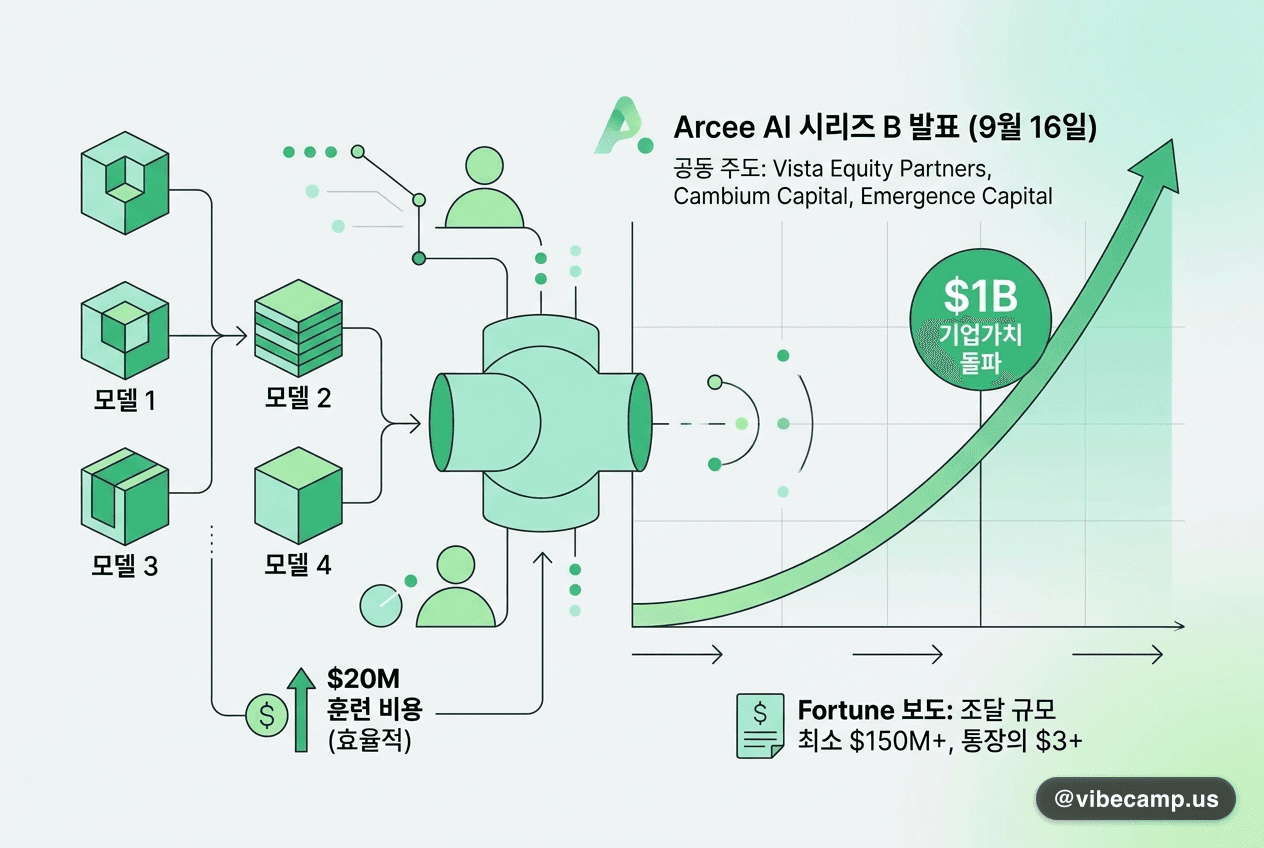
모델 4종 훈련에 $20M, 기업가치 $1B 돌파

모델 4종 훈련에 $20M, 기업가치 $1B 돌파

#
Arcee AI 가 9월 16일 Vista Equity Partners·Cambium Capital·Emergence Capital 이 공동 주도한 시리즈 B 를 발표하며 기업가치 $1B 를 넘었다고 공식 보도자료로 밝혔다. 회사가 공식 확인한 수치는 기업가치뿐이다. Fortune 보도에 따르면 조달 규모는 최소 $150M 이고, 통장의 $30M 상당액을 몰아 오픈웨이트 모델 4종을 약 $20M 에 훈련했다. Fortune 이 인용한 CEO Mark McQuade(전 Hugging Face 초기 멤버)의 말은 이렇다. "기회를 봤고, 통장에 $30M 이 있었다. '하자'고 했고 회사를 걸었다." 제품은 오픈웨이트 Trinity Nano·Mini·Large(400B 파라미터 sparse MoE, 토큰당 활성 13B)와 미 에너지부와 함께 만든 Genesis-Science-1 이다. 매출·ARR 은 미공개.
💡💡 레버리지는 자본의 크기가 아니라 배분이라는 사례입니다. 오픈웨이트 베이스에 좁은 타깃(과학 계산·기업 커스터마이즈)을 겹치면 두 자릿수 백만 달러대에서도 경쟁할 모델이 나옵니다.
원문 →#open-weights#funding#moe#enterprise
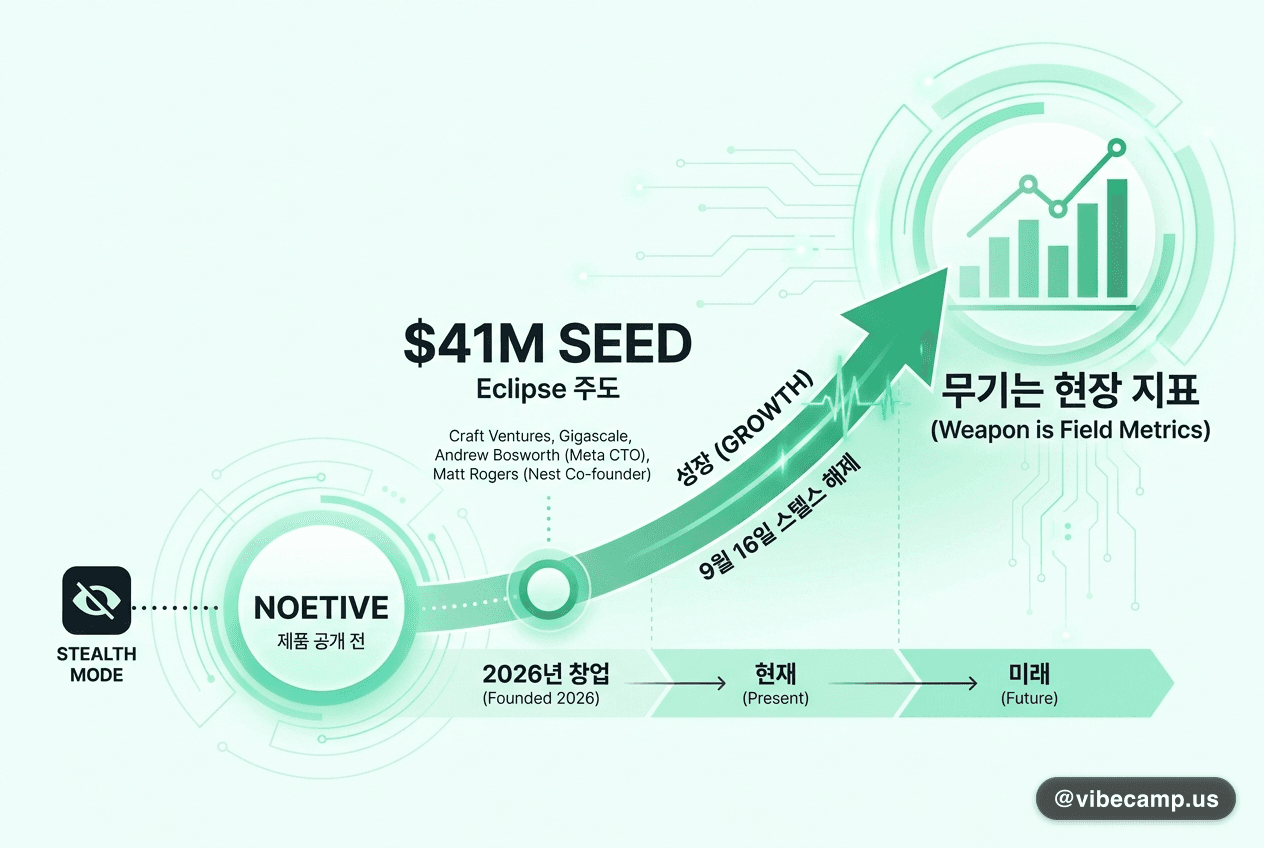
제품 공개 전 $41M, 무기는 현장 지표

제품 공개 전 $41M, 무기는 현장 지표

#
Noetive 가 9월 16일 스텔스를 해제하면서 Eclipse 가 주도한 $41M 시드를 공식 발표했다. Craft Ventures·Gigascale 등이 참여했고 엔젤로 Meta CTO Andrew Bosworth, Nest 공동창업자 Matt Rogers 가 들어갔다. 2026년 창업, 창업자 겸 CEO 는 전 Meta VP 출신 Amir Frenkel 이다. 만드는 건 제조·물류·에너지·데이터센터 현장을 이해하는 산업 월드 모델과, 그 모델에 실시간 데이터를 넣어 주는 범용 센싱 포드다. Frenkel 의 문제 제기는 이렇다. "AI 는 물리 경제의 기업들을 바꿀 것이다. 그런데 지금의 해법들은 인터넷 위의 정보 노동을 위해 설계됐다." 회사 발표 기준, 디자인 파트너 Steuben Foods 에서 생산 계획 업무가 월 1회·1주일짜리 프로세스에서 매일·수 분 단위로 바뀌었다. 매출·ARR 은 미공개다.
💡💡 데모가 아니라 측정 가능한 공정 지표가 세일즈 자료였습니다. 제품이 아직 초기라면 '누가 만들었나'와 '어느 현장에 이미 들어가 있나' 두 가지부터 확보하세요.
원문 →#funding#world-model#industrial#sensing
🎙

빌더 인터뷰

월 200만이 쓰던 제품을 접고 CRM으로

월 200만이 쓰던 제품을 접고 CRM으로

#
a16z 팟캐스트가 9월 16일 Lightfield 공동창업자 겸 CEO Keith Peiris 와의 52분 대담을 공개했다. Keith 는 AI 프레젠테이션 제품 Tome 를 월 200만 사용자(소개문 기준 누적 2,500만)까지 키웠지만 제품을 접고 CRM 으로 하드 피벗했다. 이유는 지표가 아니었다. "본능적으로, 우리 중 누구도 그 제품을 좋아하지 않았다. 우리 스스로 좋은 프레젠테이션을 만들 수가 없었다." 기술이 발표자·청중·둘의 관계에 대한 컨텍스트를 못 담는다는 판단이었다. 지금 만드는 건 비즈니스 월드 모델 — 이메일·통화·미팅을 관계 단위 활동 로그로 쌓아 에이전트가 쓰게 하는 구조다. 완전 비정형 RAG 는 실패했다고 밝혔다. "쿼리가 너무 오래 걸렸다. 건초더미 속 바늘 문제가 생긴다." 그래서 반정형으로 갔다. 가격도 시트 과금에서 출발했지만 헤드가 테일의 1만 배를 써서 소비량 과금으로 바꿨다.
💡💡 에이전트 제품의 1차 프리미티브는 '필드'가 아니라 관계의 시계열 활동 로그입니다. 그리고 컨텍스트를 못 담는 제품은 모델이 좋아져도 구원되지 않습니다 — 지표가 좋아도 접을 근거가 됩니다.
원문 →Lightfield →#interview#crm#agent#pricing
🦅

claw 생태계

채팅 말고 자동화용 모델 — Jev, HN 1위

채팅 말고 자동화용 모델 — Jev, HN 1위

#
Typesafe.ai 가 9월 15일(UTC) System One Models 와 전용 런타임 Jev 를 함께 공개했다. 같은 날 Hacker News 1위에 올라 현재 1,772점·471댓글이 달렸다. 질문은 단순하다. "모델은 수년째 채팅에서 초인적인데, 자동화는 다 어디 갔나?" 답으로 내놓은 건 대화가 아니라 소프트웨어 내부 호출을 위한 모델이다. Jev 는 "비정형 상태를 넣으면 타입이 붙은 확률적 결정이 나오는 프런티어 지능 함수 호출"로 설명된다. 회사 발표 기준 응답 70~500ms(프런티어 LLM 은 3~329초), 입력 $0.042/MTok·출력 무료, 워크플로 평가에서 193.6배 빠르고 444.6배 저렴하다 — 얼리 액세스 대기자 단계라 제3자 검증은 아직 없다. clawfit 은 이를 9월 16일 데일리 스캔에 올리며 레지스트리에 없던 '모델 결합형 하네스' 로 분류했다.
💡💡 하네스를 고를 때 '어떤 모델이든 끼운다'가 늘 정답은 아닙니다. 분류·추출·라우팅 같은 구조화 판단 단계는 프런티어 모델에서 떼어내 결정 전용 모델로 돌리는 설계를 지금 비용표에 올려두세요.
원문 →#L1#L2#runtime#typed-output#hn
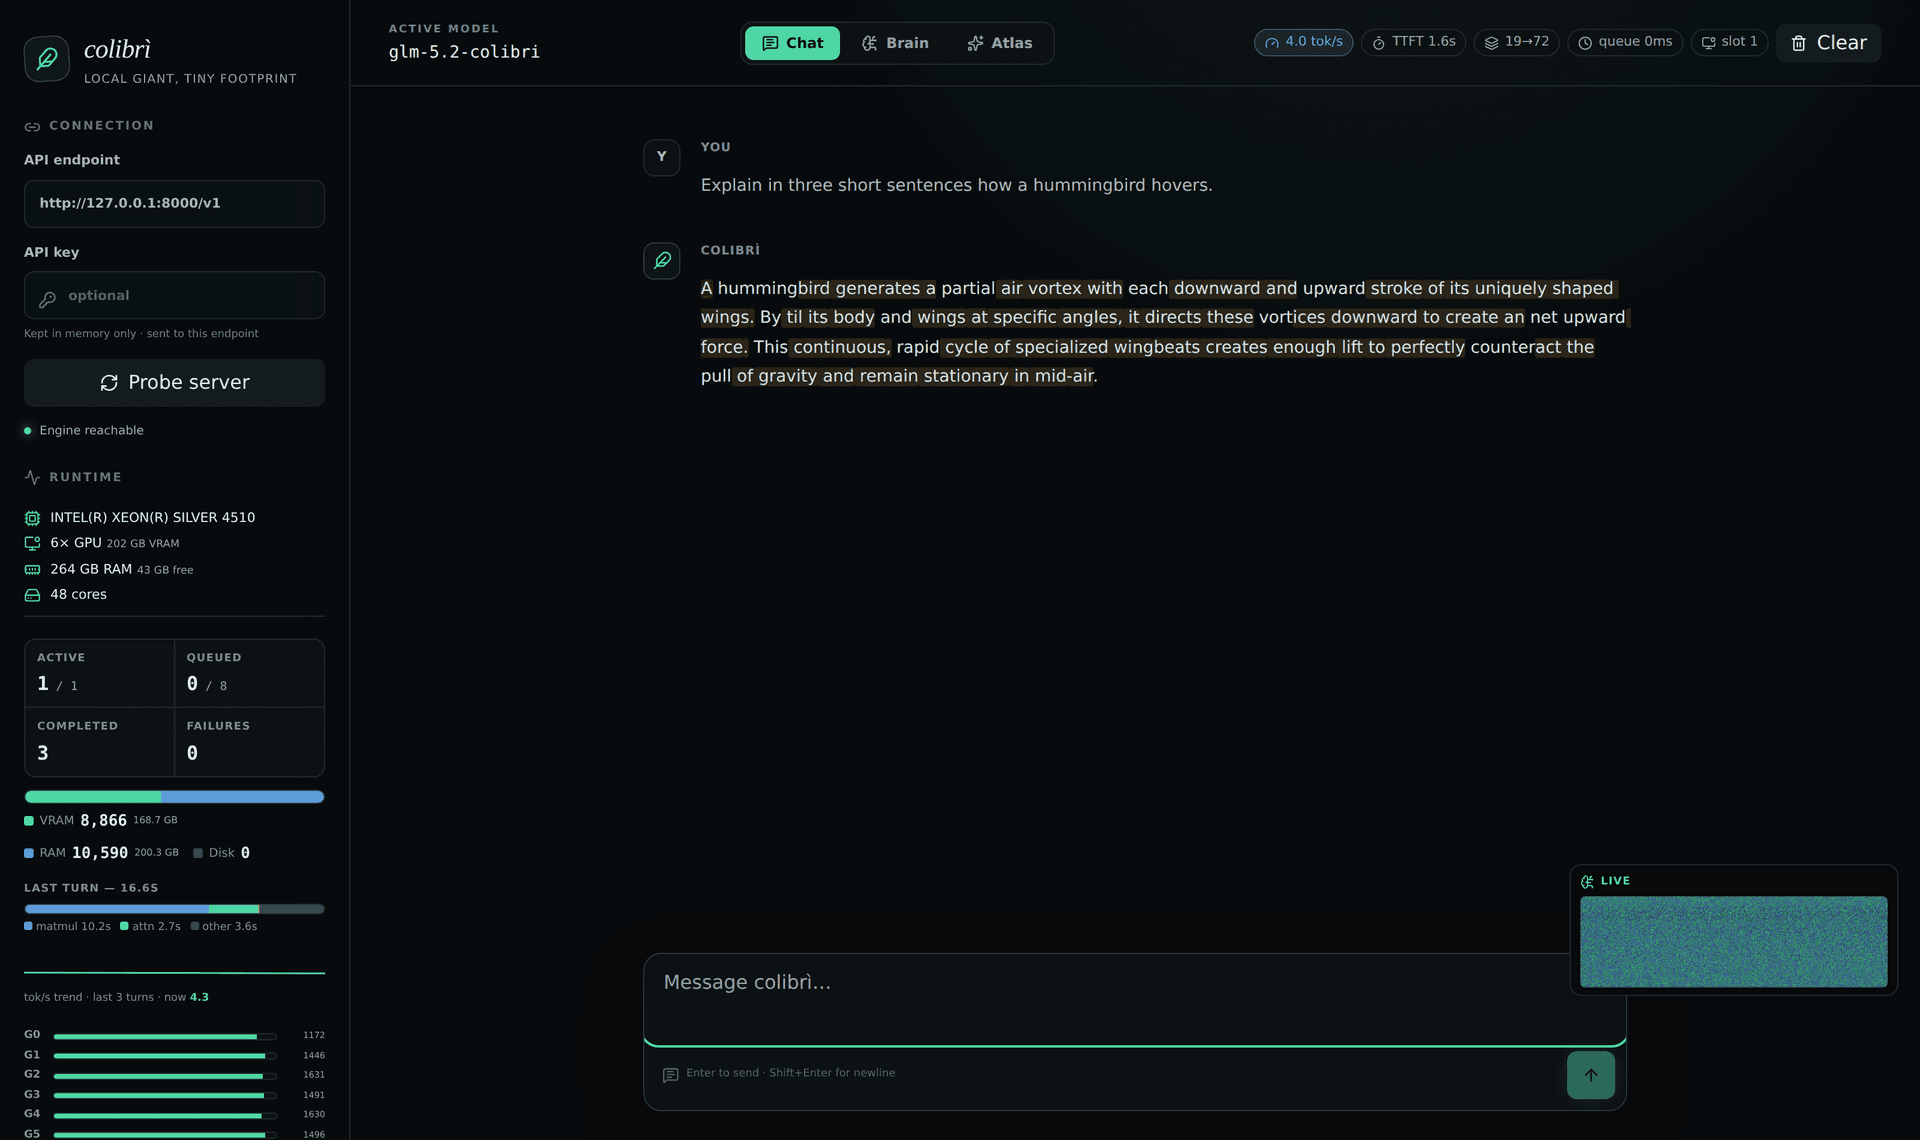
colibri 추론 엔진의 어두운 대시보드 화면 — 왼쪽에 API 엔드포인트와 GPU·RAM·코어 등 런타임 사용량 패널, 오른쪽에 glm-5.2-colibri 모델과 주고받은 채팅 응답이 표시됨

순수 C로 744B, 전문가만 디스크에서 꺼냅니다

#
clawfit 이 9월 16일 데일리 스캔에서 colibri(⭐34,921)를 L0 베어 추론 기반층으로 다시 다뤘다. 레포는 2026-07-01 에 공개됐고 clawfit 재등재는 2026-07-21 이라 신규가 아니다. 이번 신호의 실체는 2026-09-13 v1.11.0(v1.10.2 이후 PR 56건)으로, 아홉 번째 모델 계열인 DeepSeek V4.1 Flash(552B·디스크 510GB)를 변환 없이 SSD 스트리밍으로 붙였다. 설계는 한 문장이다. "저장장치·RAM·VRAM 을 하나의 추론 계층으로 취급한다." llama.cpp 는 양자화로, vLLM 은 GPU 페이징으로 모델을 하드웨어에 맞추지만 colibri 는 애초에 전부 올리지 않는다 — 연산마다 활성 전문가 샤드만 디스크에서 읽는다. 데모 대시보드에서 744B 모델이 상주 9.9GB·4 tok/s·TTFT 1.6s 로 돈다.
💡💡 'VRAM 이 몇 GB냐'로 로컬 모델 후보를 거르던 기준이 흔들립니다. 온프레미스·기밀 데이터 워크로드라면 양자화 손실을 감수하기 전에 스트리밍 엔진으로 같은 체크포인트를 그대로 돌려보는 경로를 먼저 확인하세요.
원문 →#L0#inference#moe#local
alphaXiv/OpenResearch 깃허브 저장소 카드 — '코딩 에이전트를 리서치 에이전트로' 소개 문구와 스타 4천 개, 포크 270개 지표 표시

쓰던 코딩 에이전트를 연구 에이전트로

#
arXiv 주석 플랫폼 alphaXiv 가 만든 OpenResearch(⭐4,294 · MIT · Rust)가 clawfit 에 L2 도메인 하네스로 등재됐다. 등재 커밋은 9월 16일 00:08 UTC, 같은 날 01:25 UTC 에 v0.2.3 이 나왔다 — 등재가 릴리스보다 77분 빨랐으니 릴리스가 계기는 아니다. 레포는 2026-06-07 생성, 트렌딩 1위 배지는 별도 확인되지 않았다. 핵심은 새 프레임워크를 만들지 않았다는 점이다. "Claude Code, Codex, OpenCode, Cursor 를 논문을 리뷰하고 가설을 세우고 실험을 돌리는 연구 에이전트로 바꾼다." 계획-실행-관찰-수정 루프는 그대로 두고 논문 검색·인용 그래프 추적·주장 검증 같은 도메인 프리미티브만 얹었다. 방향마다 독립 세션과 격리된 git worktree 를 주고, 실행마다 커밋 불변 아카이브를 남긴다. 전부 로컬에 남는다.
💡💡 도메인 하네스를 새로 짜기 전에 '이미 쓰는 에이전트 + 도메인 스킬 층' 구성을 먼저 시도해 보세요. 여기서 훔칠 만한 건 방향마다 worktree 를 격리하고 실행 결과를 커밋에 못 박는 실험 추적 구조입니다.
원문 →#L2#harness#research#rust

이 호가 도움됐다면 공유해 주세요 — 빌더 한 명이 더 알게 됩니다.

📤 공유하기𝕏@inf💬✈B✉